6장. Qwen 모델 준비와 텍스트 생성
프로젝트 1 — 디코딩 설정 비교표
사내 도우미 챗봇을 만드는 팀에서 "답이 너무 딱딱하다"는 의견과 "가끔 엉뚱한 말을 한다"는 의견이 함께 나왔습니다. 생성 설정을 바꾸면 어떻게 달라지는지 회의에서 보여 줄 비교표가 필요합니다. 같은 질문, 같은 모델로 고르는 방식만 바꿔 생성하고, 결과를 한 장의 표로 정리하세요.
질문은 실습 2와 같은 "업무 실수를 줄이려면 체크리스트를 쓰는 게 좋을까?" 로 합니다. Greedy 의 답이 실습 2의 chat 결과와 같은지도 함께 확인할 수 있습니다.
요구사항
- 토크나이저와 Qwen2.5-0.5B-Instruct 를 프로젝트 안에서 직접 불러와 GPU 에 올립니다. 모델은 하나만 올립니다.
- 질문을
apply_chat_template로 대본 양식에 넣어 입력을 만듭니다. - 설정 다섯 가지(Greedy, temperature 0.3, temperature 1.5, top-k 20, top-p 0.8)로 각각 씨앗 42 와 7 에서 두 번씩, 40토큰을 생성합니다.
- 설정마다 "두 씨앗의 답이 같은가", "새 토큰 가운데 서로 다른 토큰의 비율", "한글 글자 비율"을 표로 찍고
out_ch06_decoding_table.csv로 저장합니다. - 끝나면 모델을 지우고 GPU 메모리를 비웁니다.
힌트
- 한 설정만 견주려면 모델 기본값을 꺼야 합니다. 샘플링 설정에는
top_k=0, top_p=1.0을 기본으로 주고, 바꿀 것만 바꿉니다. - Greedy 에는
do_sample=False와 함께temperature=None, top_k=None, top_p=None을 주면 "무시될 수 있다"는 안내가 나오지 않습니다. - 씨앗은
generate바로 앞에서torch.manual_seed(seed)로 줍니다. - 한글 글자는 정규식
re.findall(r"[가-힣]", 글)로 셉니다. 빈칸을 뺀 글자 수로 나누면 비율입니다. - 사전의 리스트를
pd.DataFrame으로 바꾸고groupby("설정")으로 묶으면 설정별 표가 됩니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 모델 준비 | 토크나이저와 모델을 직접 불러 GPU 에 BF16 으로 올린다 | 15 |
| 입력 만들기 | apply_chat_template 로 답 칸까지 연 입력을 만든다 | 15 |
| 다섯 가지 설정 | 한 번에 한 설정만 바꾸도록 기본값을 끄고 생성한다 | 25 |
| 씨앗과 반복 | 설정마다 씨앗 두 개로 두 번 생성한다 | 15 |
| 비교표와 저장 | 세 가지 지표를 표로 찍고 csv 로 저장한다 | 20 |
| 정리 | 모델을 지우고 GPU 메모리를 비운다 | 10 |
코드의 흐름
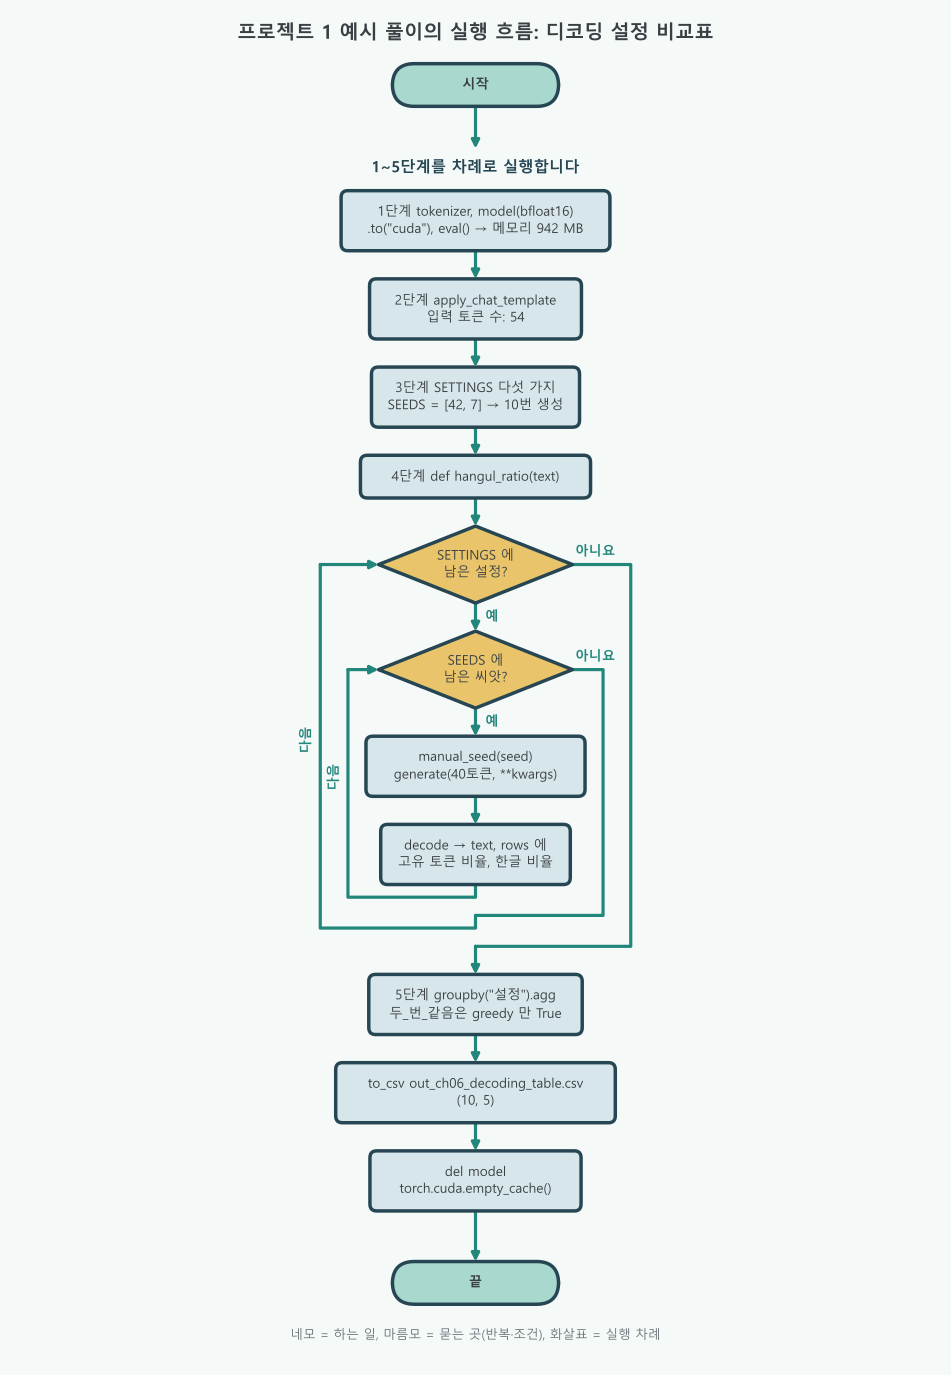
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 토크나이저와 모델을 GPU 에 올린다 | 없음 | model = AutoModelForCausalLM.from_pretrained(MODEL_NAME, dtype=torch.bfloat16).to("cuda") |
| 2 | 질문을 대본 양식으로 바꾼다 | 없음 | prompt_len = inputs["input_ids"].shape[1] |
| 3 | 설정 다섯 가지와 씨앗 두 개를 정한다 | 없음 | SEEDS = [42, 7] |
| 4 | 설정마다 두 번씩 생성하고 지표를 모은다 | 설정 5개 × 씨앗 2개의 이중 반복, 10번 생성 | torch.manual_seed(seed) 뒤 model.generate(**inputs, ..., **kwargs) |
| 5 | 설정별 비교표를 찍고 저장한 뒤 모델을 지운다 | 없음 | df.groupby("설정", sort=False).agg(...) |
- 한 줄기 흐름: 앞 단계의 변수(
model,inputs,prompt_len,SETTINGS,rows)를 뒤 단계가 그대로 쓰므로 1단계부터 차례로 실행합니다. 1~2단계는 실습 1, 2와 같은 준비입니다. - 4단계의 이중 반복: 바깥 고리는 설정, 안쪽 고리는 씨앗입니다. 3단계에서 설정 다섯 가지를 사전 하나에 모아 두었으므로, 4단계는 그 사전을 돌기만 하면 됩니다. 씨앗은
generate바로 앞에서 주어 매번 같은 출발점에서 제비를 뽑게 합니다. - 끝부분: 5단계에서 두 씨앗의 답이 같은지와 두 비율의 평균을 숫자로 견주고, 표를 저장한 뒤
del model과torch.cuda.empty_cache()로 GPU 메모리를 비웁니다.
결과 보기 (예시 풀이)
1단계. 토크나이저와 모델 불러오기
# re = 정규식(글자 무늬 찾기) 도구. 한글 글자를 셀 때 쓴다
import re

import pandas as pd
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_NAME = "Qwen/Qwen2.5-0.5B-Instruct"

# 실습 1과 같은 방법으로 불러온다. 다른 장의 변수에 기대지 않는다
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
# dtype=torch.bfloat16 = 2바이트 숫자로 읽기, .to("cuda") = GPU 에 올리기
model = AutoModelForCausalLM.from_pretrained(MODEL_NAME, dtype=torch.bfloat16).to("cuda")
# 추론 모드로 바꾼다(dropout 끄기)
model.eval()
# 결과: 메모리 942 MB
print(f"메모리 {model.get_memory_footprint() / 1024**2:,.0f} MB")메모리 942 MB2단계. 질문을 대본 양식으로 바꾸기
question = "업무 실수를 줄이려면 체크리스트를 쓰는 게 좋을까?"
messages = [{"role": "user", "content": question}]

# 실습 2의 chat 함수와 같은 인자로 대본 양식을 입히고 GPU 로 옮긴다
inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,  # <|im_start|>assistant 까지 붙여 답 칸을 연다
    return_tensors="pt",  # PyTorch 텐서로
    return_dict=True,  # input_ids 와 attention_mask 를 함께
).to(model.device)

# 입력 길이: 시스템 안내 + 질문 + 머리표의 토큰 수
prompt_len = inputs["input_ids"].shape[1]
# 결과: 입력 토큰 수: 54
print("입력 토큰 수:", prompt_len)입력 토큰 수: 543단계. 설정 다섯 가지 정하기
# 설정 이름 -> generate 에 넘길 인자. 샘플링은 top_k=0, top_p=1.0 으로 기본 거르개를 끄고 하나만 바꾼다
SETTINGS = {
    # Greedy: 늘 1등. 샘플링용 값은 None 으로 비워 "무시될 수 있다" 안내를 막는다
    "greedy": dict(do_sample=False, temperature=None, top_k=None, top_p=None),
    # 낮은 모험심: 1등 근처에 몰린다
    "temperature 0.3": dict(do_sample=True, temperature=0.3, top_k=0, top_p=1.0),
    # 높은 모험심: 거르개 없이 퍼진 분포에서 뽑는다
    "temperature 1.5": dict(do_sample=True, temperature=1.5, top_k=0, top_p=1.0),
    # 예선: 상위 20개 후보만(모델 기본값과 같은 k)
    "top-k 20": dict(do_sample=True, temperature=1.0, top_k=20, top_p=1.0),
    # 결선: 누적 80% 까지의 후보만
    "top-p 0.8": dict(do_sample=True, temperature=1.0, top_k=0, top_p=0.8),
}
SEEDS = [42, 7]  # 씨앗 두 개로 두 번씩 뽑는다
# 결과: 설정 5개 × 씨앗 2개 = 10번 생성
print(f"설정 {len(SETTINGS)}개 × 씨앗 {len(SEEDS)}개 = {len(SETTINGS) * len(SEEDS)}번 생성")설정 5개 × 씨앗 2개 = 10번 생성4단계. 설정마다 두 번씩 생성하기
def hangul_ratio(text):
    # 빈칸을 뺀 글자 가운데 한글(가~힣)의 비율. 다른 나라 글자가 섞이면 낮아진다
    chars = text.replace(" ", "")
    return len(re.findall(r"[가-힣]", chars)) / max(len(chars), 1)

rows = []
for name, kwargs in SETTINGS.items():
    for seed in SEEDS:
        torch.manual_seed(seed)  # 제비뽑기의 출발점을 정한다
        with torch.inference_mode():  # 학습 기록을 끄고 생성만
            output = model.generate(
                **inputs,
                max_new_tokens=40,  # 새 토큰 40개까지
                repetition_penalty=1.2,  # 실습 2와 같은 반복 억제
                **kwargs,  # 설정별 인자를 풀어 넣는다
            )
        new_ids = output[0, prompt_len:].tolist()  # 새로 만든 토큰 번호만
        text = tokenizer.decode(new_ids, skip_special_tokens=True).strip().replace("\n", " ")
        rows.append({
            "설정": name,
            "씨앗": seed,
            "답": text,
            "고유 토큰 비율": len(set(new_ids)) / len(new_ids),  # 서로 다른 토큰 수 ÷ 전체 토큰 수
            "한글 비율": hangul_ratio(text),
        })
        # 답은 앞 45글자만 찍는다
        # 결과: greedy 는 두 씨앗이 같은 답, temperature 1.5 는 중국어 같은 다른 나라 글자가 섞인 답
print(f"[{name} / 씨앗 {seed}] {text[:45]}")[greedy / 씨앗 42] 네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다. 체크리스트(예: '1번'
[greedy / 씨앗 7] 네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다. 체크리스트(예: '1번'
[temperature 0.3 / 씨앗 42] 네, 체크리스트( Checklist )은 일정이나 작업에 대한 명확한 목표와 준비
[temperature 0.3 / 씨앗 7] 체크리스트(Checklist)은 작업이나 일정에 필요한 요소들을 정리하고 관리를
[temperature 1.5 / 씨앗 42] 测评基本原则通常是将"取消运用既单独检索多项容纳用户所需的信息头被延误;",把信息偏差 c
[temperature 1.5 / 씨앗 7] DefaultCloseOperation 的因素有很多,这里提供一些建议และความ
[top-k 20 / 씨앗 42] 네, 체크리스트( Checklist)은 작업에 중점을 둔 정보 또는 목록입니다.
[top-k 20 / 씨앗 7] 체크리스트라는 방법은 일반적으로 사용하는 것이 아니라 중요한 부분을 분석하고 제거
[top-p 0.8 / 씨앗 42] 네, 체크리스트(Prevention Checklist)이라는 개념은 워드룸 또는
[top-p 0.8 / 씨앗 7] 체크리스트라는 방법은 일반적으로 사용하는 것이 아니라 작업에 필요한 실제 일정과5단계. 비교표 만들고 저장하기
df = pd.DataFrame(rows)

# 설정별로 묶어 세 지표를 낸다
table = df.groupby("설정", sort=False).agg(
    두_번_같음=("답", lambda s: s.iloc[0] == s.iloc[1]),  # 두 씨앗의 답이 같은가
    고유_토큰_비율=("고유 토큰 비율", "mean"),  # 두 번의 평균
    한글_비율=("한글 비율", "mean"),
).round(2)
# 결과: 두 번 같음은 greedy 만 True, 한글 비율은 temperature 1.5 만 0.06 으로 크게 낮다
print(table)

# 답까지 들어간 전체 표를 저장한다(utf-8-sig = 엑셀에서 한글이 깨지지 않게)
df.to_csv("out_ch06_decoding_table.csv", index=False, encoding="utf-8-sig")
print("저장:", "out_ch06_decoding_table.csv", df.shape)

# 다른 실습도 같은 GPU 를 쓰므로 모델을 지우고 메모리를 비운다
del model
torch.cuda.empty_cache() 두_번_같음 고유_토큰_비율 한글_비율
설정
greedy True 0.95 0.74
temperature 0.3 False 0.99 0.79
temperature 1.5 False 1.00 0.06
top-k 20 False 1.00 0.87
top-p 0.8 False 0.98 0.82
저장: out_ch06_decoding_table.csv (10, 5)비교표를 읽으면 회의에서 할 말이 정리됩니다. 아래 결론은 이 PC 에서 한 번 돌린 결과를 기준으로 썼습니다.
표를 위에서부터 읽습니다. Greedy 만 두 씨앗의 답이 같습니다(True). 씨앗은 제비뽑기의 출발점이므로 뽑기를 하지 않는 Greedy 에는 영향이 없습니다. Greedy 의 답 "네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다." 는 실습 2의 chat 결과와 같습니다. 설정(Greedy, repetition_penalty=1.2)이 같으면 답도 같다는 것을 확인한 셈입니다.
temperature 0.3, top-k 20, top-p 0.8 은 씨앗마다 문장이 다르지만 모두 체크리스트 이야기를 한국어로 이어 갑니다. 한글 비율이 0.79~0.87 로 Greedy(0.74)와 비슷합니다. Greedy 의 비율이 조금 낮은 것은 '1번' 같은 따옴표와 숫자가 섞였기 때문입니다. 반면 temperature 1.5 는 거르개 없이 평평해진 분포에서 뽑아 중국어, 영어, 태국어가 뒤섞인 글이 나왔고 한글 비율이 0.06 까지 떨어졌습니다. 같은 1.5 라도 top-k 나 top-p 를 함께 걸면 이런 꼬리 후보가 걸러집니다. 고유 토큰 비율은 모두 0.95 이상으로 비슷했습니다. 40토큰으로 짧고 repetition_penalty=1.2 가 반복을 이미 막았기 때문입니다.
회의에서 할 말은 이렇습니다. 정확성이 중요한 사내 도우미는 Greedy 나 낮은 temperature 를 쓰고, 다양한 표현이 필요하면 temperature 를 올리되 top-p(또는 top-k)를 꼭 함께 겁니다. 샘플링 결과는 실행할 때마다, GPU 마다 달라지므로 비교표에는 씨앗을 함께 적어 둡니다.