6장. Qwen 모델 준비와 텍스트 생성
디코딩 전략: temperature, top-k, top-p
점심 메뉴를 고르는 세 가지 버릇을 생각해 봅니다. 늘 가던 집만 가는 사람(낮은 temperature), 가끔 새 집도 가 보는 사람(높은 temperature), 그리고 "후보는 인기 순위 2위까지만"이라는 규칙을 두는 사람(top-k), "인기 투표 합이 80% 가 될 때까지의 집만"이라는 규칙을 두는 사람(top-p)입니다. temperature 는 모험심 다이얼, top-k 는 후보 k명만 남기는 예선, top-p 는 누적 득표 p% 까지만 결선입니다.
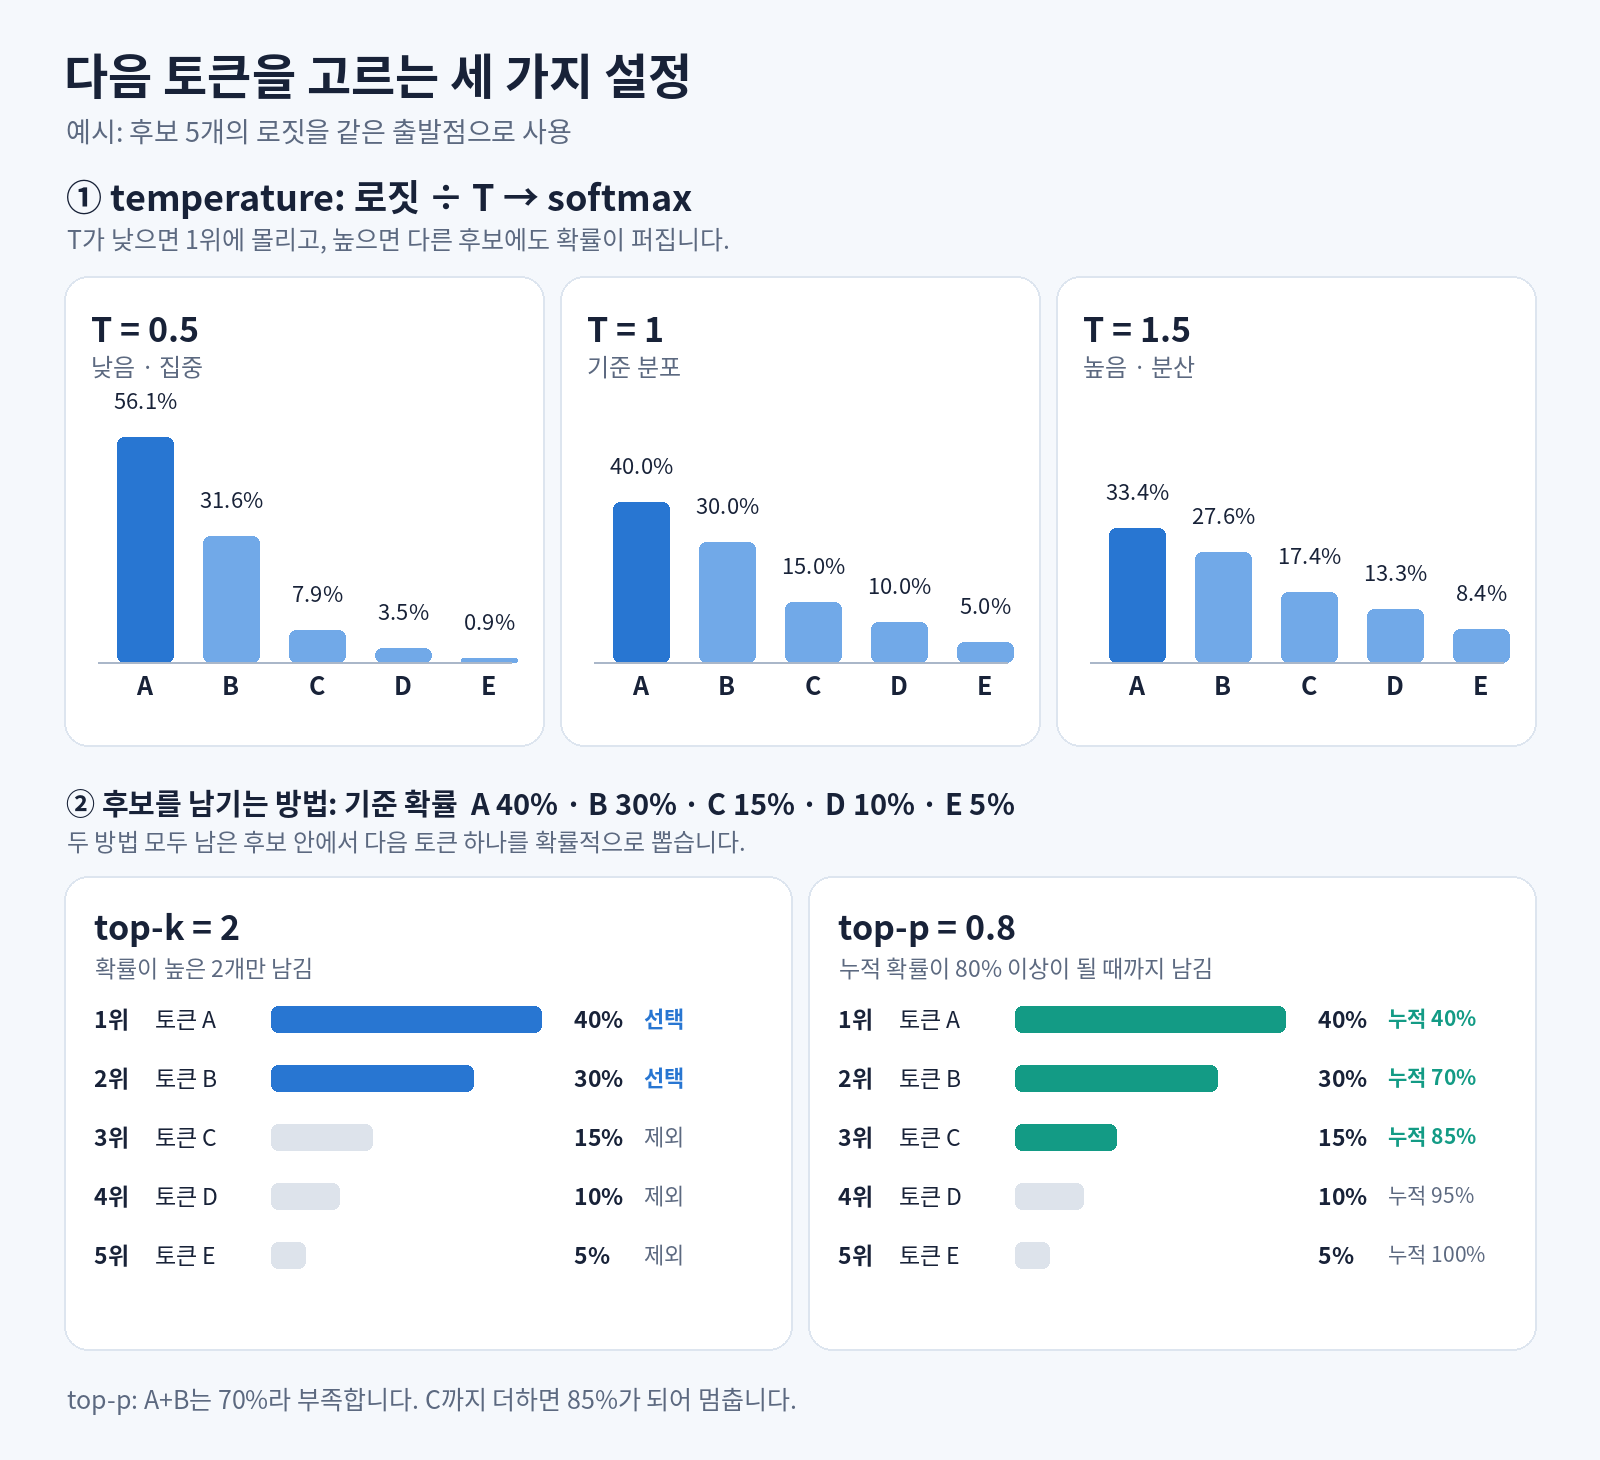
강사자료 그림의 위쪽은 같은 후보 5개(A~E)의 확률이 temperature 에 따라 어떻게 바뀌는지 보여 줍니다. T = 1 이 기준 분포(40, 30, 15, 10, 5%)이고, T = 0.5 면 A 가 56.1% 로 커지며 뾰족해지고, T = 1.5 면 A 가 33.4% 로 줄며 평평해집니다. 아래쪽은 후보를 거르는 두 방법입니다. top-k = 2 는 A, B 만 남기고, top-p = 0.8 은 A + B 가 70% 라 모자라서 C 까지 더해 85% 에서 멈춥니다. 두 방법 모두 남은 후보 안에서 확률에 따라 하나를 뽑습니다.
세 가지 설정
| 설정 | 하는 일 | 값이 작으면 | 값이 크면 | 점심으로 치면 |
|---|---|---|---|---|
temperature | 로짓을 T 로 나눠 분포를 뾰족하게, 평평하게 | 안정적, 반복적 | 다양하지만 엉뚱할 수 있음 | 모험심 다이얼 |
top_k | 확률 상위 k 개 후보만 남김 | 보수적 | 다양함 | 인기 순위 k 위까지만 |
top_p | 누적 확률 p 까지의 후보만 남김(nucleus sampling) | 보수적 | 다양함 | 누적 득표 p% 까지만 |
| 하는 일 | 알맞은 설정 |
|---|---|
| 사실 확인, 분류, 코드 생성처럼 정확성이 중요한 일 | Greedy 또는 낮은 temperature |
| 아이디어, 글쓰기처럼 다양성이 필요한 일 | 높은 temperature 와 top-p 를 함께 |
| 학습 전후 비교처럼 같은 조건이 필요한 일 | Greedy(do_sample=False) |
손으로 한 번 계산해 봅니다. 로짓이 [2.0, 1.0, 0.1] 이면 T = 1 일 때 e^2 ≈ 7.39, e^1 ≈ 2.72, e^0.1 ≈ 1.11, 합 11.21 로 나눠 0.66, 0.24, 0.10 입니다. T = 0.5 면 로짓을 0.5 로 나눠 [4, 2, 0.2] 가 되고, e^4 ≈ 54.6, e^2 ≈ 7.39, e^0.2 ≈ 1.22, 합 63.2 로 나눠 0.86, 0.12, 0.02 입니다. 1등이 0.66 에서 0.86 으로 커졌습니다. 나누는 값이 작을수록 점수 차이가 벌어져 1등이 독차지합니다.
짧은 예시
import numpy as np

def softmax_t(logits, temperature=1.0):
    # 로짓을 temperature 로 나눈 뒤 Softmax(합이 1 인 비율)로 바꾼다
    z = np.array(logits) / temperature
    e = np.exp(z - z.max())  # 가장 큰 값을 빼도 비율은 같고, 큰 수 넘침을 막는다
    return e / e.sum()

# 손계산과 대조: 로짓 [2.0, 1.0, 0.1]
for t in [0.5, 1.0, 2.0]:
    print(t, softmax_t([2.0, 1.0, 0.1], t).round(2))
# 결과: 0.5 [0.86 0.12 0.02] / 1.0 [0.66 0.24 0.1 ] / 2.0 [0.5 0.3 0.19]

# 강사자료 그림의 후보 A~E: T = 1 에서 40, 30, 15, 10, 5% 가 되도록 로짓을 log(확률)로 둔다
p = np.array([0.40, 0.30, 0.15, 0.10, 0.05])
logits = np.log(p)
for t in [0.05, 0.5, 1.5]:
    print(t, (softmax_t(logits, t) * 100).round(1))
# 결과: 0.05 [99.7 0.3 0. 0. 0.] / 0.5 [56.1 31.6 7.9 3.5 0.9] / 1.5 [33.4 27.6 17.4 13.3 8.4]

# top-k = 2: 상위 2개만 남기고 다시 합 1 로 맞춘다
order = np.argsort(p)[::-1]  # 확률이 큰 순서의 자리 번호
keep_k = np.zeros_like(p)
keep_k[order[:2]] = p[order[:2]]
print((keep_k / keep_k.sum()).round(3))  # 결과: [0.571 0.429 0. 0. 0.]

# top-p = 0.8: 누적 확률이 0.8 이상이 되는 자리까지 남긴다
cum = np.cumsum(p[order])  # 결과: [0.4 0.7 0.85 0.95 1.]
n_keep = np.searchsorted(cum, 0.8) + 1  # 0.8 이 처음 넘는 자리까지의 개수. 결과: 3
keep_p = np.zeros_like(p)
keep_p[order[:n_keep]] = p[order[:n_keep]]
print((keep_p / keep_p.sum()).round(3))  # 결과: [0.471 0.353 0.176 0. 0.]
이 코드가 뜻하는 것
점심 메뉴 투표 결과 하나를 놓고 세 가지 버릇을 차례로 적용해 본 것입니다. 첫 줄은 손계산(0.66, 0.24, 0.10)과, 둘째 줄은 강사자료 그림의 막대 숫자(56.1%, 33.4%)와 똑같이 나옵니다. temperature 0.05 에서는 A 가 99.7% 라 사실상 Greedy 와 같아집니다. 실습 3에서 temperature 0.05 로 두 번 뽑은 답이 둘 다 "서울입니다." 로 시작한 까닭입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
np.array(logits) / temperature | 로짓을 T 로 나눈다 | 모험심 다이얼 돌리기 |
np.log(p) | 확률을 로짓으로 되돌린다 | 그림과 같은 출발점 만들기 |
keep_k[order[:2]] = ... | 상위 2개만 남긴다 | 인기 순위 2위까지만 예선 통과 |
np.cumsum(p[order]) | 누적 확률 | 득표를 위에서부터 더하기 |
keep / keep.sum() | 남은 후보끼리 합 1 로 | 결선 후보끼리 다시 비율 내기 |
top-k 와 top-p 는 "누가 뽑기에 들어갈지"를, temperature 는 "들어간 후보끼리 얼마나 고르게 나눌지"를 정합니다. 그래서 셋을 함께 쓰는 일이 많습니다.
주의할 점
- 모델 폴더의 생성 기본값(temperature 0.7, top_k 20, top_p 0.8, repetition_penalty 1.1)이 함께 걸립니다. 실습 3처럼
temperature만 바꾸면 top_k 20, top_p 0.8 은 그대로 적용됩니다. 한 설정만 견주고 싶으면 프로젝트처럼top_k=0, top_p=1.0을 직접 주어 끕니다. - temperature 를 너무 높이면 확률이 아주 낮은 엉뚱한 토큰(다른 나라 글자, 끊긴 낱말)까지 뽑힙니다. 프로젝트에서 temperature 1.5 의 결과로 확인합니다.
- 샘플링 결과는 실행할 때마다 다릅니다. 같은 결과를 다시 보려면
torch.manual_seed(42)처럼 씨앗을 줍니다. 다만 GPU 종류와 라이브러리 버전이 다르면 씨앗이 같아도 결과가 다를 수 있습니다.