6장. Qwen 모델 준비와 텍스트 생성
실습 3 — 문장 이어 쓰기와 temperature 비교
pipeline 으로 문장 뒤를 이어 쓰게 하고, 같은 문장을 temperature 두 값으로 두 번씩 뽑아 견줍니다. 원본 노트북의 셀 11, 16 입니다. 실습 1의 두 셀을 먼저 실행해 둡니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다.
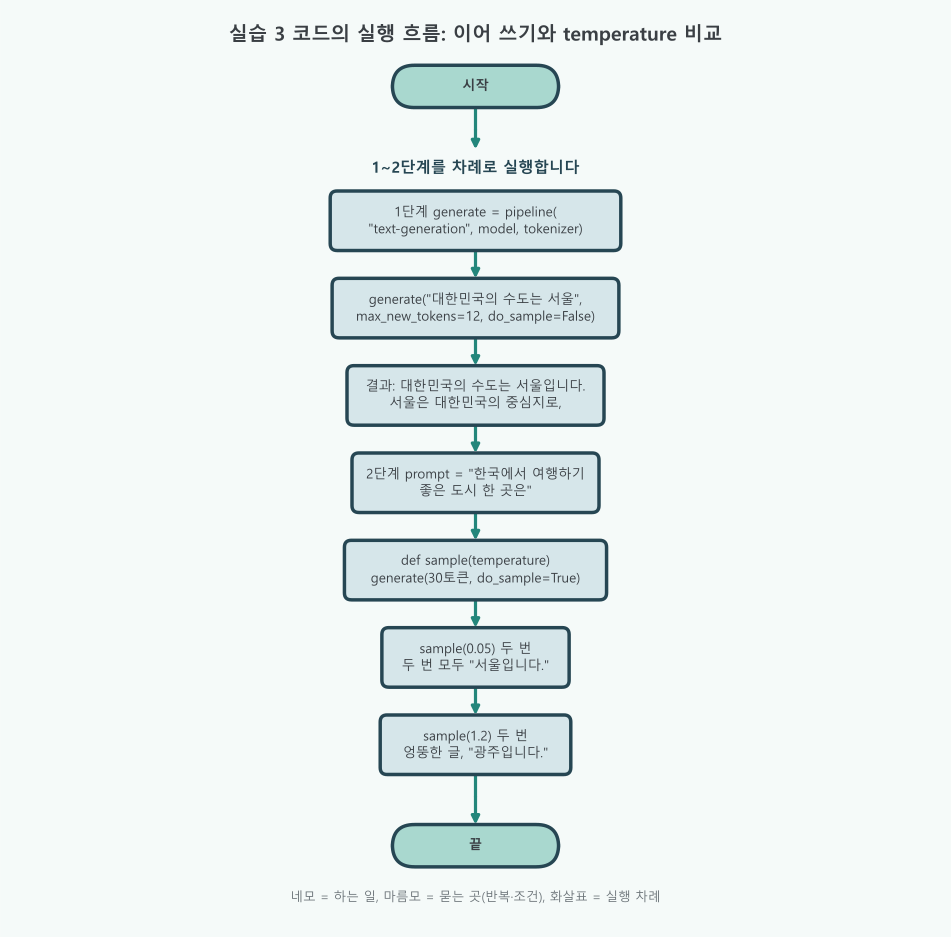
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | pipeline 으로 문장을 Greedy 로 이어 쓴다 | 없음 | result = generate(prompt, max_new_tokens=12, do_sample=False) |
| 2 | temperature 두 값으로 두 번씩 뽑는다 | 없음. sample 을 네 번 차례로 부른다 | generate(prompt, max_new_tokens=30, do_sample=True, temperature=temperature) |
- 한 줄기 흐름: 2단계의
sample함수는 1단계에서 만든generate(pipeline)를 그대로 씁니다. 그래서 1단계를 먼저 실행합니다. - 반복문 대신 네 줄: 2단계는
for없이print(sample(0.05))두 줄,print(sample(1.2))두 줄을 차례로 적었습니다. 그림에서도 온도마다 네모 하나로 묶었습니다. - 결과는 실행마다 다릅니다: 마지막 두 네모의 결과는 교안을 만들 때 한 번 돌린 출력입니다.
do_sample=True라 직접 돌리면 다른 문장이 나옵니다.
1단계. pipeline 으로 문장 이어 쓰기
말 이어 붙이기 놀이에서 앞부분만 주고 뒤를 맡기는 일입니다. 대본 양식 없이 글자 그대로 주므로, 모델은 질문에 답하기보다 글을 자연스럽게 이어 씁니다.
# 입력한 문장 뒤에 모델이 어떤 단어를 이어 쓰는지 확인합니다.
# pipeline = 토큰화, 생성, 글자로 되돌리기를 한 줄로 묶은 간편 도구
from transformers import pipeline  # 텍스트 생성을 간단히 호출합니다.

# "text-generation" = 글 이어 쓰기 일. 이미 불러 둔 model 과 tokenizer 를 그대로 쓴다
generate = pipeline("text-generation", model=model, tokenizer=tokenizer)  # 생성 파이프라인을 만듭니다.
prompt = "대한민국의 수도는 서울"  # 이어 쓸 문장 앞부분입니다.
# max_new_tokens=12 = 새 토큰 12개까지, do_sample=False = Greedy(늘 1등 후보)
result = generate(prompt, max_new_tokens=12, do_sample=False)  # 최대 12토큰을 탐욕적으로 생성합니다.
# result 는 [{"generated_text": 입력 + 이어 쓴 글}] 꼴의 리스트
# 결과: Device set to use cuda:0 / 대한민국의 수도는 서울입니다. 서울은 대한민국의 중심지로,
print(result[0]["generated_text"])Device set to use cuda:0
대한민국의 수도는 서울입니다. 서울은 대한민국의 중심지로,2단계. temperature 두 값으로 두 번씩 뽑기
점심 메뉴를 늘 가던 집만 고르는 사람(0.05)과 모험을 즐기는 사람(1.2)에게 같은 질문을 두 번씩 해 보는 일입니다. do_sample=True 라 제비뽑기로 고르므로 실행할 때마다 문장이 달라집니다.
# 같은 문장을 두 temperature로 두 번씩 생성
prompt = "한국에서 여행하기 좋은 도시 한 곳은"  # 여러 번 이어 쓸 같은 문장입니다.

# temperature 를 받아 문장 하나를 뽑는 함수
def sample(temperature):  # 주어진 온도로 답변 하나를 생성합니다.
    # do_sample=True = 확률에 따라 제비뽑기. temperature = 로짓을 나누는 값(모험심 다이얼)
    result = generate(prompt, max_new_tokens=30, do_sample=True, temperature=temperature)  # 확률적으로 다음 토큰을 고릅니다.
    # replace(prompt, "", 1) = 앞의 입력 문장을 한 번만 지운다. replace("\n", " ") = 줄바꿈을 빈칸으로
    return result[0]["generated_text"].replace(prompt, "", 1).strip().replace("\n", " ")  # 프롬프트를 뺀 뒷부분만 한 줄로 정리합니다.

# 낮은 온도: 1등 후보에 거의 몰린다. 결과: 두 번 모두 "서울입니다." 로 시작
print("--- temperature=0.05 (낮음) ---")
print(sample(0.05))
print(sample(0.05))

# 높은 온도: 확률이 고르게 퍼진다. 결과: 두 번이 서로 전혀 다른 문장
print("--- temperature=1.2 (높음) ---")
print(sample(1.2))
print(sample(1.2))--- temperature=0.05 (낮음) ---
서울입니다. 서울은 한국의 중심지로, 다양한 문화와 레스토랑을 찾는 것이 좋습니다. 또한,
서울입니다. 서울의 주요 도시 중 하나인 강남구는 한국의 가장 큰 중심지로, 다양한 문화와 �
--- temperature=1.2 (높음) ---
? (2) - 월간 '미디어 뉴스' 기자 정진환 코리아일 블
광주입니다. 한국을 여행하는데 광주에 도달하는 방법과 장소, 광주에 가는이 실습이 뜻하는 것
같은 앞부분을 주고 "늘 1등만 고르기"와 "제비뽑기"를 견준 실습입니다. 1단계의 Greedy 는 "서울입니다. 서울은 대한민국의 중심지로," 처럼 무난하게 이어 쓰고, 12토큰에서 멈춥니다. 2단계의 temperature 0.05 는 두 번 모두 "서울입니다." 로 시작해 거의 Greedy 처럼 굴었고, 둘째 문장부터 조금씩 갈라졌습니다. temperature 1.2 는 한 번은 "? (2) - 월간 '미디어 뉴스' ..." 처럼 엉뚱한 글이, 한 번은 "광주입니다. ..." 처럼 다른 도시가 나왔습니다. 이 셀은 do_sample=True 라 실행할 때마다 문장이 달라집니다. 직접 돌리면 교안과 다른 문장이 나오는 것이 정상입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | Device set to use cuda:0 | pipeline 이 GPU 를 쓴다는 안내 |
| 1단계 | 대한민국의 수도는 서울입니다. 서울은 대한민국의 중심지로, | Greedy 로 12토큰 이어 쓰기 |
| 2단계 | temperature 0.05: 두 번 모두 "서울입니다." | 1등에 몰려 거의 같은 시작 |
| 2단계 | temperature 1.2: 엉뚱한 글, "광주입니다." | 퍼진 분포에서 다양하게, 때로 엉뚱하게 |
temperature 를 낮추면 안정적이고, 높이면 다양하지만 엉뚱해질 수 있습니다.
코드 설명
pipeline("text-generation", model=model, tokenizer=tokenizer)는 이미 GPU 에 올린 모델을 그대로 씁니다. 모델을 새로 불러오지 않으므로 메모리가 늘지 않습니다.pipeline에 글자를 그대로 넣으면 Chat Template 을 입히지 않습니다. 그래서 질문 답변이 아니라 "글 이어 쓰기"가 됩니다. 실습 2의chat과 다른 점입니다.max_new_tokens=12는 토큰 12개입니다. 본문에서 센 것처럼 입력 8토큰 + 새 12토큰 = 20토큰이라 "중심지로," 에서 끊깁니다.sample함수에는 temperature 만 줬으므로 모델 기본값 top_k 20, top_p 0.8, repetition_penalty 1.1 이 함께 걸립니다. temperature 1.2 에서도 아주 낮은 확률의 후보는 이 두 거르개에 걸러집니다.- 두 번 뽑은 문장이 서로 다른 것은 씨앗을 주지 않았기 때문입니다.
torch.manual_seed로 씨앗을 주면 같은 PC 에서는 다시 같은 문장을 볼 수 있습니다. 프로젝트에서 해 봅니다.