6장. Qwen 모델 준비와 텍스트 생성
실습 1 — 실습 준비와 Qwen 불러오기
2일차에 쓸 도구를 불러오고, Qwen2.5-0.5B-Instruct 를 GPU 에 올려 파라미터 수와 메모리를 확인합니다. 원본 노트북의 셀 3, 6 입니다. 이 두 셀은 7~9차시의 실습에서도 먼저 실행해 두는 준비 코드입니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
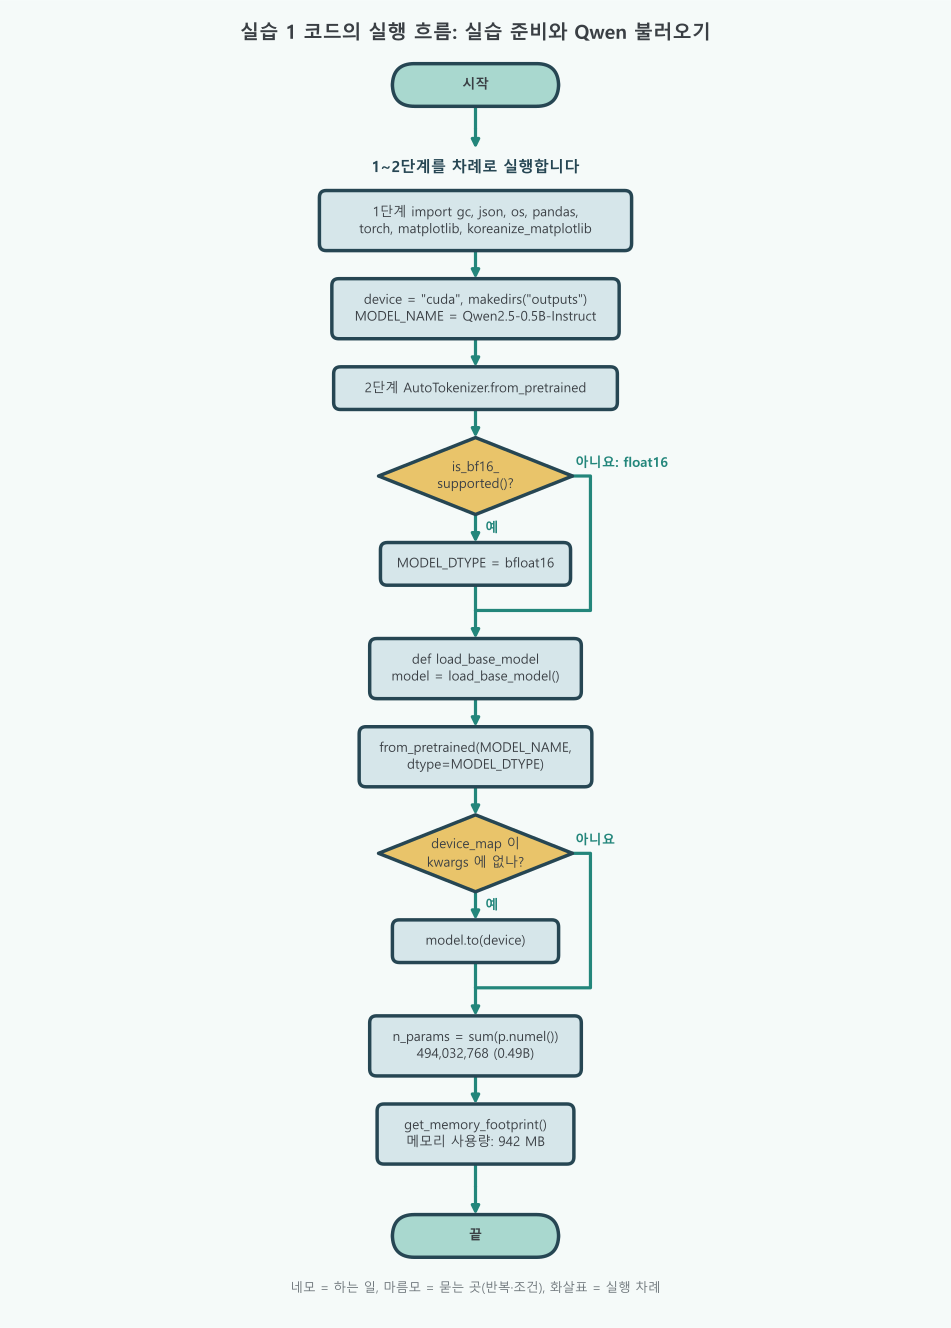
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 도구를 불러오고 장치와 모델 이름을 정한다 | 없음 | device = "cuda" |
| 2 | 정밀도를 골라 기반 모델을 불러오고 크기를 잰다 | 조건 두 개: BF16 지원 여부, device_map 이 없는지 | model = load_base_model() |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 조건 마름모에서 "예"면 아래 네모를 하고, "아니요"면 오른쪽 선을 따라 그 네모를 건너뜁니다. 반복이 있으면 마름모로 다시 돌아오는 고리가 생기는데, 이 실습에는 반복이 없습니다.
- 첫째 마름모:
torch.cuda.is_bf16_supported()가 참이면MODEL_DTYPE이torch.bfloat16, 거짓이면torch.float16입니다. RTX 3080 은 "예" 쪽입니다. - 둘째 마름모:
load_base_model()을 인자 없이 불렀으므로device_map이 없어 "예" 쪽으로 가model.to(device)를 합니다. 9장의 QLoRA 처럼device_map을 주면 이 네모를 건너뜁니다.
1단계. 도구 불러오기와 GPU 정하기
연수 첫날 아침에 공구함을 펼치고 작업대를 정하는 일입니다. 표, 텐서, 그래프 도구를 꺼내고, 계산은 GPU(cuda)에서 하기로 정합니다.
# 데이터를 읽고 모델을 학습하는 데 필요한 도구를 불러옵니다.
import gc  # 더 이상 쓰지 않는 모델 객체를 메모리에서 정리합니다.
import json  # JSONL 데이터를 읽고 쓸 때 사용합니다.
import os  # 파일 경로와 폴더를 다룹니다.
import warnings  # 경고 메시지를 제어합니다.
# filterwarnings("ignore") = 경고 거르개를 "무시"로 둔다
warnings.filterwarnings("ignore")  # 실습과 무관한 경고를 숨깁니다.

import pandas as pd  # 표 형태 데이터를 다룹니다.
# torch = PyTorch. 텐서(GPU 에서 계산할 수 있는 숫자 배열)와 신경망 도구
import torch  # 텐서와 모델 학습에 사용합니다.
import matplotlib.pyplot as plt  # 그래프를 그립니다.
import koreanize_matplotlib  # 그래프에서 한글이 깨지지 않게 합니다.

# "cuda" = NVIDIA GPU. 뒤에서 모델과 입력을 이 장치로 옮긴다
device = "cuda"  # GPU 1개를 사용합니다.
# makedirs(폴더, exist_ok=True) = 폴더를 만들되, 이미 있으면 그냥 넘어간다
os.makedirs("outputs", exist_ok=True)  # 학습 결과를 저장할 폴더입니다.

# Hugging Face 의 모델 이름. "만든 곳/모델 이름" 꼴이다
MODEL_NAME = "Qwen/Qwen2.5-0.5B-Instruct"  # 추론과 LoRA 학습에 사용할 모델입니다.
2단계. 기반 모델 불러오고 크기 재기
새 직원을 자리에 앉히고 짐이 얼마나 되는지 재는 일입니다. GPU 가 BF16 을 지원하면 2바이트 숫자로 가중치를 읽어 GPU 에 올리고, 파라미터 수와 메모리 사용량을 찍습니다.
# GPU가 지원하는 숫자 정밀도를 고른 뒤 기반 모델을 불러옵니다.
# AutoModelForCausalLM = 다음 낱말 맞히기(causal LM)용 모델을 이름으로 불러오는 도구
# AutoTokenizer = 모델 이름에 맞는 토크나이저를 골라 주는 도구
from transformers import AutoModelForCausalLM, AutoTokenizer  # 생성 모델과 토크나이저를 불러옵니다.

# from_pretrained = 이미 학습된(pretrained) 것을 내려받아 불러오기
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)  # Qwen용 토크나이저를 불러옵니다.
# is_bf16_supported() = 이 GPU 가 BF16 을 지원하는가. RTX 3080 은 True 라 BF16 을 고른다
MODEL_DTYPE = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16  # BF16 지원 GPU(RTX 30 이상, A100, L4)는 BF16, 그 외(Colab T4 등)는 FP16입니다.


# 기반 모델을 부르는 함수. 9차시에서 어댑터를 붙이거나 QLoRA 로 다시 부를 때도 쓴다
def load_base_model(model_name=MODEL_NAME, dtype=MODEL_DTYPE, **kwargs):  # 같은 기반 모델을 필요할 때 다시 불러옵니다.
    model = AutoModelForCausalLM.from_pretrained( # 지정한 기반 모델 가중치를 불러옵니다.
        model_name,  # 내려받을 기반 모델입니다.
        dtype=dtype,  # 가중치의 정밀도입니다. 기본값은 MODEL_DTYPE입니다.
        # **kwargs = 이름 붙은 인자를 사전으로 모아 그대로 넘긴다(예: quantization_config, device_map)
        **kwargs,  # 양자화와 장치 배치 등 추가 옵션입니다.
    )
    # device_map 을 주면 라이브러리가 알아서 장치에 올리므로 직접 옮기지 않는다
    if "device_map" not in kwargs:  # device_map 옵션이 없을 때만 아래에서 장치를 직접 지정합니다.
        model = model.to(device)  # 앞에서 선택한 장치로 모델을 옮깁니다.
    # 종료 토큰과 패딩 토큰은 모델에 저장된 생성 설정을 사용합니다.
    return model


# 인자 없이 부르면 MODEL_NAME 을 BF16 으로 불러와 GPU 에 올린다
model = load_base_model()  # 기본 정밀도로 Qwen 모델을 불러옵니다.
# parameters() = 가중치 텐서를 하나씩 돌려준다. numel() = number of elements, 원소 수
n_params = sum(p.numel() for p in model.parameters())  # 모든 가중치 원소 수를 합칩니다.
# 결과: 파라미터 수: 494,032,768 (0.49B)
print(f"파라미터 수: {n_params:,} ({n_params / 1e9:.2f}B)")
# get_memory_footprint() = 가중치가 차지하는 바이트 수. 1024**2 로 나눠 MB 로. 결과: 942 MB
print(f"메모리 사용량: {model.get_memory_footprint() / 1024**2:,.0f} MB")파라미터 수: 494,032,768 (0.49B)
메모리 사용량: 942 MB이 실습이 뜻하는 것
공구함을 펼치고(1단계), 새 직원을 자리에 앉혀 짐의 크기를 잰(2단계) 실습입니다. 짐의 크기 942 MB 는 본문에서 손으로 계산한 494,032,768 × 2바이트 ≈ 942.3 MB 와 같습니다. 10GB 짜리 RTX 3080 에서 가중치는 10분의 1 남짓만 차지하므로, 생성과 LoRA 학습에 쓸 자리가 넉넉합니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 없음 | 도구, device = "cuda", MODEL_NAME 준비 |
| 2단계 | 파라미터 수: 494,032,768 (0.49B) | 0.5B 라는 이름처럼 약 4.9억 개 |
| 2단계 | 메모리 사용량: 942 MB | BF16 2바이트 × 4.9억 개 |
모델의 크기는 파라미터 수가, 메모리는 파라미터 수 × 바이트 수가 정합니다.
코드 설명
warnings.filterwarnings("ignore")는 경고를 숨깁니다. 그래도 transformers 가 직접 찍는 안내(실습 2의 첫 줄)는 남습니다.MODEL_DTYPE은 GPU 에 따라 BF16 이나 FP16 을 고릅니다. Colab T4 처럼 BF16 을 지원하지 않는 GPU 에서는 FP16 이 됩니다. 어느 쪽이든 2바이트라 메모리는 같습니다.load_base_model의**kwargs는 9장의 QLoRA 에서quantization_config와device_map을 넘길 때 쓰입니다. 그때는 라이브러리가 장치 배치를 맡으므로model.to(device)를 건너뜁니다.sum(p.numel() for p in model.parameters())는 모든 가중치 표의 칸 수를 더합니다. 5장에서 층별로 나눠 센 합과 같은 494,032,768 입니다.get_memory_footprint()는 가중치만의 크기입니다. 생성 중의 중간값은 들어 있지 않습니다.