6장. Qwen 모델 준비와 텍스트 생성
실습 2 — chat 함수로 질문하기
질문 하나를 Qwen 의 대본 양식으로 바꿔 Greedy 로 답하게 하는 chat 함수를 만듭니다. 원본 노트북의 셀 7 입니다. 이 함수는 8장, 9장에서 학습 전후를 견줄 때 그대로 다시 씁니다. 실습 1의 두 셀을 먼저 실행해 둡니다.
코드를 따라가기 전에 실행 흐름을 한 장으로 봅니다.
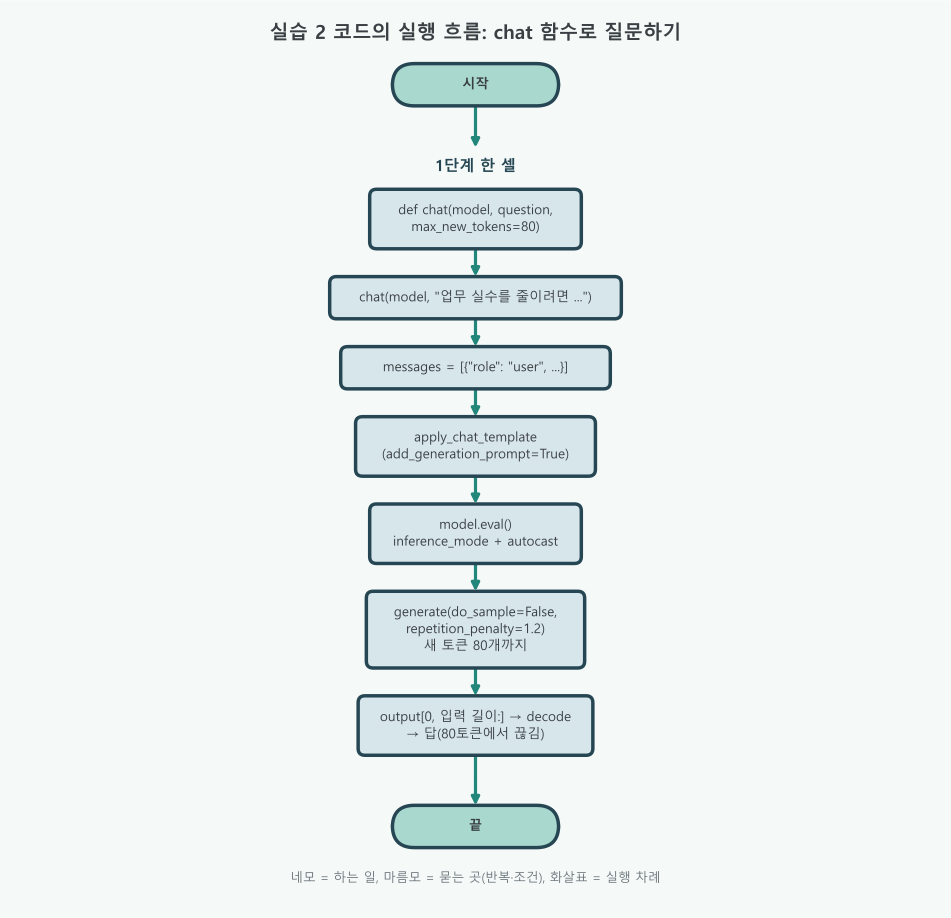
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | chat 함수를 만들고 질문 하나로 부른다 | 없음. 토큰을 하나씩 잇는 반복은 generate() 가 안에서 맡는다 | output = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False, ...) |
- 함수 정의와 부르기: 첫 네모는
def chat을 적어 두기만 하는 일이고, 둘째 네모의chat(model, ...)을 부를 때 아래 네모들이 차례로 실행됩니다. - generate 는 네모 하나: 다음 토큰 고르기 → 붙이기를 새 토큰 80개까지 되풀이하지만 코드에 반복이 보이지 않으므로 네모 하나로 그렸습니다. 4장 실습 3의 흐름도에서 이 반복을 풀어 그렸습니다.
- 끝부분:
generate는 입력과 새 토큰을 이어 붙여 돌려주므로, 입력 길이 뒤부터 잘라 새 토큰만 글자로 바꿉니다.
1단계. chat 함수 만들고 질문하기
상담 창구의 접수 양식과 같습니다. 손님의 말을 "user 가 말함" 꼬리표를 단 대본에 옮겨 적고, 끝에 "assistant 답:" 칸을 열어 둔 채 모델에게 건넵니다. 모델은 그 칸부터 답을 이어 씁니다.
# 질문을 Qwen이 사용하는 채팅 형식으로 바꾸고 답변을 생성합니다.
# max_new_tokens=80 = 새로 쓸 토큰을 최대 80개로 둔다(기본값)
def chat(model, question, max_new_tokens=80):
    # role(누가 말했는지) 과 content(한 말) 를 담은 사전의 리스트
    messages = [{"role": "user", "content": question}]  # 질문을 채팅 메시지 형식으로 만듭니다.
    # apply_chat_template = 대본 양식(Chat Template) 입히기
    inputs = tokenizer.apply_chat_template(  # 질문을 Qwen이 학습한 채팅 형식으로 바꿉니다.
        messages,  # 변환할 사용자 메시지입니다.
        add_generation_prompt=True,  # 모델 답변이 시작될 위치(<|im_start|>assistant)까지 붙입니다.
        return_tensors="pt",  # 결과를 PyTorch 텐서로 받습니다.
        return_dict=True,  # input_ids와 attention_mask를 함께 받습니다.
    ).to(model.device)  # 입력 텐서를 모델과 같은 장치로 옮깁니다.

    # eval = evaluation(평가) 모드. 학습 때만 쓰는 무작위 끄기(dropout)를 멈춘다
    model.eval()  # dropout 등을 추론 모드로 바꿉니다.

    # inference_mode = 추론 전용 모드, autocast = 연산마다 정밀도를 자동으로 고르기
    with (torch.inference_mode(), # 기울기 계산과 관련 기록을 끕니다. 답변 생성처럼 학습하지 않을 때 메모리 사용과 계산 부담을 줄입니다.
    torch.autocast(device_type="cuda", dtype=MODEL_DTYPE)):# CUDA 연산마다 적절한 정밀도를 자동으로 선택합니다.
        # generate = 다음 토큰 하나 고르기 → 붙이기를 되풀이해 이어 쓰기
        output = model.generate(  # 설정에 따라 새 토큰을 생성합니다.
            **inputs,  # input_ids와 attention_mask를 전달합니다.
            max_new_tokens=max_new_tokens,  # 새로 만들 최대 토큰 수입니다.
            do_sample=False,  # 매번 확률이 가장 높은 토큰을 선택하므로 결과를 비교하기 쉽습니다.
            repetition_penalty=1.2,  # 작은 모델이 같은 단어를 반복하는 현상을 줄입니다.
        )
    # output 의 모양은 (1, 입력 길이 + 새 토큰 수). 입력 길이 뒤부터 잘라 새 토큰만 남긴다
    new_tokens = output[0, inputs["input_ids"].shape[1]:]  # 질문에 해당하는 입력 토큰은 제외하고 새로 생성한 토큰만 남깁니다.
    # decode = 토큰 번호를 글자로. skip_special_tokens=True 면 <|im_end|> 같은 머리표를 뺀다
    return tokenizer.decode(new_tokens, skip_special_tokens=True).strip()  # 새 토큰을 사람이 읽는 문자열로 바꿉니다.


# 학습 전 Qwen 의 평소 말투를 본다
# 결과: 첫 줄은 "temperature, top_p, top_k 는 무시될 수 있다" 는 안내, 그다음 존댓말 답(80토큰에서 끊김)
print(chat(model, "업무 실수를 줄이려면 체크리스트를 쓰는 게 좋을까?"))The following generation flags are not valid and may be ignored: ['temperature', 'top_p', 'top_k']. Set `TRANSFORMERS_VERBOSITY=info` for more details.
네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다. 체크리스트(예: '1번', '2번')은 일정에 따라 적절한 작업을 수행하는 데 도움이 됩니다.
하지만 이 방법은 단순히 "일반적인" 실수가 아니라 특정 상황이나 팀원이 실습이 뜻하는 것
접수 양식에 손님 질문을 옮겨 적고, 수습생이 가장 무난한 말만 골라 답하게 한 실습입니다. 첫 줄의 안내는 오류가 아닙니다. 모델 폴더의 기본값(temperature 0.7, top_p 0.8, top_k 20)은 샘플링용인데, 여기서는 do_sample=False 로 Greedy 를 썼으므로 "이 값들은 쓰이지 않는다"고 알린 것입니다. 답은 "네, ..." 로 시작하는 평범한 존댓말이고, 80토큰에서 문장 중간에 끊깁니다. "업무실시 수준" 처럼 어색한 말도 섞여 있습니다. 0.5B 라는 작은 모델의 한계입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | The following generation flags are not valid ... | 샘플링용 기본값이 Greedy 에서는 무시됨 |
| 1단계 | 네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다. ... | 학습 전의 평범한 존댓말 답 |
| 1단계 | ... 특정 상황이나 팀원 | 80토큰에서 끊김 |
이 답이 8장의 학습 뒤에 군주 말투로 바뀌는지가 2일차의 볼거리입니다.
코드 설명
apply_chat_template(..., add_generation_prompt=True)는 질문 뒤에<|im_start|>assistant까지 붙여 "답 칸"을 열어 둡니다. 이것을 빼면 모델이 답 대신 질문을 더 이어 쓸 수 있습니다.return_dict=True는input_ids(토큰 번호)와attention_mask(실제 토큰은 1, 빈칸은 0)를 사전으로 돌려줍니다.**inputs로generate에 그대로 풀어 넘깁니다.torch.inference_mode()는 학습용 기록(기울기)을 끄고,torch.autocast는 연산마다 BF16 을 쓰게 합니다. 둘 다 생성할 때 메모리와 시간을 줄입니다.do_sample=False와repetition_penalty=1.2는 학습 전후를 같은 조건으로 견주려고 고정한 값입니다. 9장의 평가에서도 이 함수를 그대로 씁니다.output[0, inputs["input_ids"].shape[1]:]는 출력에서 입력 길이만큼을 잘라 냅니다.generate는 입력과 새 토큰을 이어 붙여 돌려주기 때문입니다.