1장. 준비 수학과 Transformer 개요
프로젝트 1 — 취향 점수를 추천 확률로 바꾸는 도우미
작은 동네 영화 모임에서 이번 주 상영작 다섯 편 가운데 회원마다 무엇을 권할지 정한다고 해 봅시다. 회원 세 명은 장르 취향을 점수로 적어 냈고, 영화마다 장르 성격도 점수로 적혀 있습니다. 회원과 영화가 얼마나 잘 맞는지는 내적으로, "이 영화를 권할 확률"은 Softmax 로 정합니다. 이 장에서 배운 행렬곱, 내적, Softmax 만으로 추천 도우미를 만듭니다. 모든 계산은 NumPy 로 CPU 에서 끝납니다.
요구사항
- 영화 5편 × 장르 4개(액션, 로맨스, 코미디, 공포) 성격표와 회원 3명 × 장르 4개 취향표를 NumPy 배열과 DataFrame 으로 만들고 shape 를 찍습니다.
- 행렬곱 한 번으로 회원 3명 × 영화 5편의 내적 점수표를 만들고, 한 칸을 손으로 계산해 맞는지 확인합니다.
- 노트북 셀 14의
softmax로 점수표를 행마다 확률로 바꾸고, 행마다 합이 1인지 확인합니다. - 회원마다 확률이 가장 높은 영화 두 편을 골라 퍼센트와 함께 찍습니다.
- 회원, 영화, 점수, 확률을 한 표로 모아
out_ch01_recommend.csv로 저장하고 다시 읽어 행 수를 확인합니다.
힌트
- 점수표는
users @ movies.T입니다. (3, 4) @ (4, 5) 라서 결과는 (3, 5) 입니다..T는 행과 열을 바꿉니다. - 행마다 확률을 만들려면
softmax의axis=-1을 그대로 쓰면 됩니다. - 큰 값부터 고르려면
np.argsort(-p[i])[:2]처럼 음수를 붙여 정렬합니다. - 표로 모을 때는
pd.DataFrame(점수표, index=회원, columns=영화).stack()으로 긴 표를 만들 수 있습니다. - 장르 점수는 설명을 위해 정한 값입니다. 숫자를 바꿔 가며 추천이 어떻게 달라지는지 보면 더 좋습니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 표 만들기 | 성격표 (5, 4) 와 취향표 (3, 4) 를 만들고 shape 를 찍는다 | 15 |
| 내적 점수표 | 행렬곱 한 번으로 (3, 5) 점수표를 만들고 한 칸을 손계산과 맞춘다 | 25 |
| Softmax | 행마다 확률로 바꾸고 행 합이 1인지 확인한다 | 25 |
| 추천 고르기 | 회원마다 확률 상위 두 편을 퍼센트와 함께 찍는다 | 20 |
| 저장 | 한 표로 모아 csv 로 저장하고 다시 읽어 확인한다 | 15 |
코드의 흐름
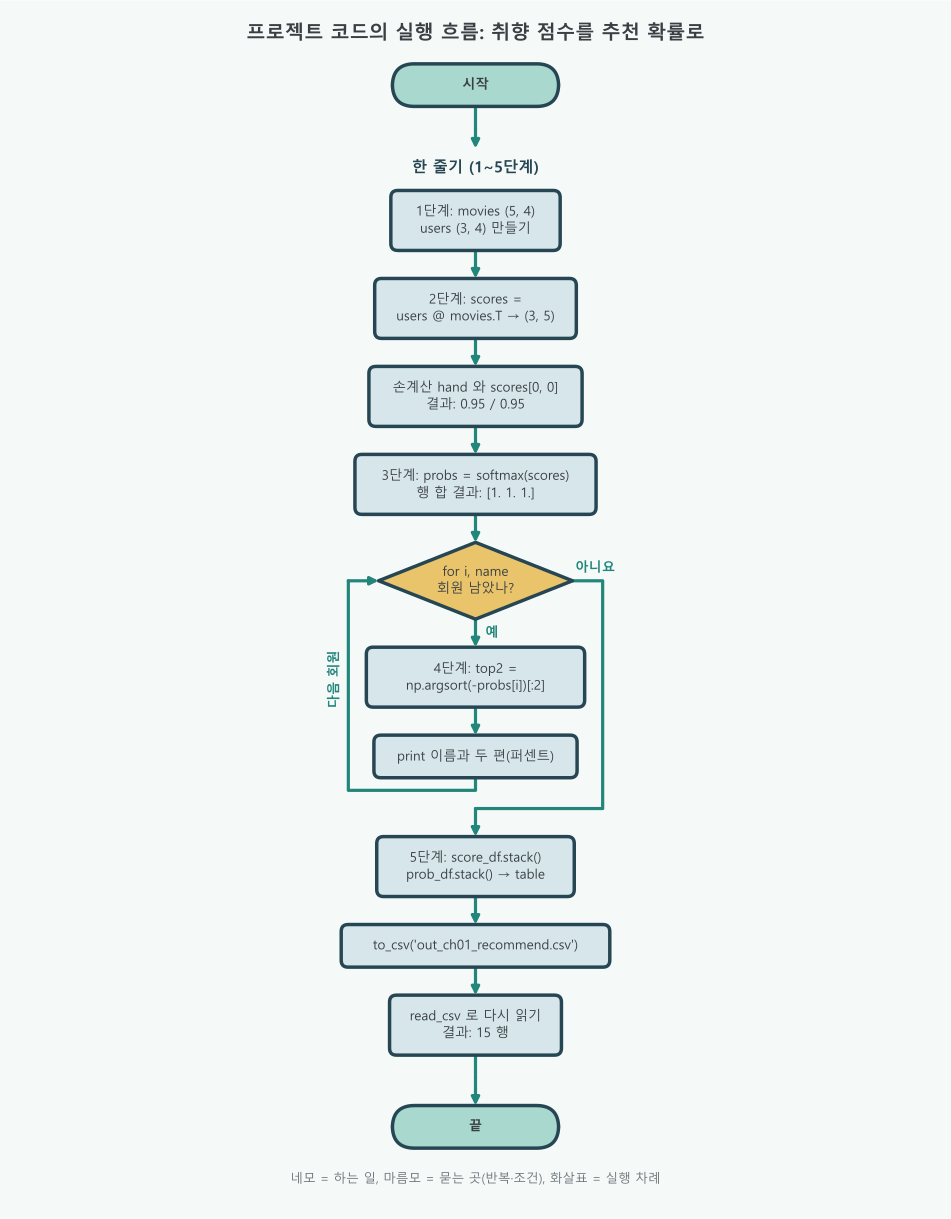
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 영화 성격표 (5, 4) 와 회원 취향표 (3, 4) 만들기 | 없음 | users = np.array([...]) |
| 2 | 행렬곱 한 번으로 (3, 5) 점수표 만들고 한 칸 손계산 | 없음 | scores = users @ movies.T |
| 3 | 점수를 행마다 합 1 인 확률로 바꾸기 | 없음 | probs = softmax(scores) |
| 4 | 회원마다 확률 상위 두 편 고르기 | 회원 3명을 한 명씩 도는 반복(for i, name) | top2 = np.argsort(-probs[i])[:2] |
| 5 | 점수와 확률을 긴 표로 펴서 csv 로 저장하고 다시 읽기 | 없음 | table.to_csv("out_ch01_recommend.csv", ...) |
- 반복 고리: 4단계의 마름모 "회원 남았나?"에서 "예"로 내려가 두 편을 골라 찍고, 왼쪽 선을 따라 다시 마름모로 돌아옵니다. 세 명을 다 돌면 "아니요"로 빠져나가 5단계로 갑니다.
- 반복이 필요 없는 곳: 2, 3단계는 회원 3명 × 영화 5편을 행렬곱과
softmax한 번으로 한꺼번에 계산합니다. pandas 에서 반복문 대신 열 단위 계산을 쓰는 것과 같습니다. - 짜임: 2단계의 내적 점수표가 "얼마나 잘 맞나"를, 3단계의 Softmax 가 "얼마의 비율로 권할까"를 맡습니다. Attention 이 내적으로 관련도를 매기고 Softmax 로 비율을 정하는 것과 같은 짜임입니다.
결과 보기 (예시 풀이)
1단계. 영화 성격표와 회원 취향표 만들기
import numpy as np
import pandas as pd

# 장르 4개: 열의 차례
genres = ["액션", "로맨스", "코미디", "공포"]
# 영화 5편의 장르 성격(0~1, 클수록 그 장르 색이 짙다). 설명을 위해 정한 값이다
movie_names = ["질주하는 도시", "봄날의 편지", "웃음 택배", "검은 복도", "우주 구조대"]
movies = np.array([
    [0.9, 0.1, 0.2, 0.1],   # 질주하는 도시: 액션
    [0.0, 0.9, 0.3, 0.0],   # 봄날의 편지: 로맨스
    [0.2, 0.2, 0.9, 0.0],   # 웃음 택배: 코미디
    [0.3, 0.0, 0.1, 0.9],   # 검은 복도: 공포
    [0.8, 0.3, 0.4, 0.2],   # 우주 구조대: 액션에 코미디가 조금
])
# 회원 3명의 장르 취향(-1~1, 음수는 싫어한다는 뜻). 설명을 위해 정한 값이다
user_names = ["민지", "준호", "서연"]
users = np.array([
    [1.0, -0.5, 0.5, 0.0],   # 민지: 액션을 좋아하고 로맨스는 별로
    [-0.5, 1.0, 0.5, -1.0],  # 준호: 로맨스를 좋아하고 공포는 싫어한다
    [0.0, 0.0, 0.5, 1.0],    # 서연: 공포를 좋아한다
])

print("영화 성격표 shape:", movies.shape)   # (영화 수, 장르 수)
print("회원 취향표 shape:", users.shape)    # (회원 수, 장르 수)
# DataFrame 으로 보면 행과 열 이름이 붙어 읽기 쉽다
print(pd.DataFrame(users, index=user_names, columns=genres))영화 성격표 shape: (5, 4)
회원 취향표 shape: (3, 4)
액션 로맨스 코미디 공포
민지 1.0 -0.5 0.5 0.0
준호 -0.5 1.0 0.5 -1.0
서연 0.0 0.0 0.5 1.02단계. 내적으로 점수표 만들기
# (3, 4) @ (4, 5) → (3, 5): 회원마다 영화 5편과의 내적을 한 번에
scores = users @ movies.T
score_df = pd.DataFrame(scores, index=user_names, columns=movie_names)
print("점수표 shape:", scores.shape)
print(score_df.round(2))

# 한 칸 손계산: 민지 × 질주하는 도시
hand = 1.0 * 0.9 + (-0.5) * 0.1 + 0.5 * 0.2 + 0.0 * 0.1   # 0.9 - 0.05 + 0.1 + 0 = 0.95
print("손계산:", round(hand, 2), "/ 행렬곱:", round(scores[0, 0], 2))점수표 shape: (3, 5)
질주하는 도시 봄날의 편지 웃음 택배 검은 복도 우주 구조대
민지 0.95 -0.30 0.55 0.35 0.85
준호 -0.35 1.05 0.55 -1.00 -0.10
서연 0.20 0.15 0.45 0.95 0.40
손계산: 0.95 / 행렬곱: 0.953단계. Softmax 로 추천 확률 만들기
# 노트북 셀 14와 같은 softmax: 마지막 축(행마다) 기준으로 합이 1
def softmax(z):
    e = np.exp(z - z.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

probs = softmax(scores)          # (3, 5): 회원마다 영화 5편의 추천 확률
prob_df = pd.DataFrame(probs, index=user_names, columns=movie_names)
print(prob_df.round(2))
# 행마다 합이 1인지 확인한다
print("행 합:", probs.sum(axis=1).round(6)) 질주하는 도시 봄날의 편지 웃음 택배 검은 복도 우주 구조대
민지 0.29 0.08 0.20 0.16 0.27
준호 0.11 0.44 0.26 0.06 0.14
서연 0.15 0.14 0.20 0.32 0.19
행 합: [1. 1. 1.]4단계. 회원마다 두 편 고르기
for i, name in enumerate(user_names):
    # argsort 는 작은 값부터 번호를 돌려주므로, 음수를 붙여 큰 값부터 고른다
    top2 = np.argsort(-probs[i])[:2]
    picks = [f"{movie_names[j]}({probs[i, j]:.0%})" for j in top2]
print(f"{name}: {', '.join(picks)}")민지: 질주하는 도시(29%), 우주 구조대(27%)
준호: 봄날의 편지(44%), 웃음 택배(26%)
서연: 검은 복도(32%), 웃음 택배(20%)5단계. 한 표로 모아 저장하기
# stack(): (회원, 영화) 두 이름을 행 번호로 삼는 긴 표로 편다
table = pd.DataFrame({
    "점수": score_df.stack(),
    "확률": prob_df.stack(),
}).reset_index()
table.columns = ["회원", "영화", "점수", "확률"]
table = table.round(4)
# utf-8-sig: 엑셀에서 열어도 한글이 깨지지 않게 저장한다
table.to_csv("out_ch01_recommend.csv", index=False, encoding="utf-8-sig")

check = pd.read_csv("out_ch01_recommend.csv", encoding="utf-8-sig")
print("저장: out_ch01_recommend.csv,", len(check), "행")
print(check.head(5))저장: out_ch01_recommend.csv, 15 행
회원 영화 점수 확률
0 민지 질주하는 도시 0.95 0.2932
1 민지 봄날의 편지 -0.30 0.0840
2 민지 웃음 택배 0.55 0.1965
3 민지 검은 복도 0.35 0.1609
4 민지 우주 구조대 0.85 0.2653점수표의 숫자 차이가 Softmax 를 거치며 비율 차이로 바뀌는 모습을 보았습니다. 민지는 액션 두 편(질주하는 도시 29%, 우주 구조대 27%), 준호는 로맨스(봄날의 편지 44%), 서연은 공포(검은 복도 32%)의 확률이 가장 높게 나옵니다. 민지의 점수 0.95 와 0.85 는 0.1 차이라서 확률도 29% 와 27% 로 가깝고, 준호의 1.05 와 0.55 는 0.5 차이라서 44% 와 26% 로 더 벌어집니다. 점수 사이의 차이가 클수록 확률이 한쪽으로 몰립니다. 장르 점수를 바꾸면 추천도 바로 바뀝니다. 이 프로젝트의 요점은 "내적으로 잘 맞는 정도를 재고, Softmax 로 합이 1인 비율로 바꾼다"입니다. 3장의 Self-Attention 은 회원 자리에 낱말을, 영화 자리에도 낱말을 놓고 똑같은 계산을 합니다.