1장. 준비 수학과 Transformer 개요
Seq2Seq: Encoder 와 Decoder 를 따로 두기
통역사 두 명이 일을 나눈다고 해 봅니다. 첫째 통역사는 긴 영어 연설을 끝까지 듣고 요점을 쪽지 한 장에 적어 넘깁니다. 둘째 통역사는 연설을 직접 듣지 못하고, 그 쪽지만 보고 한국어 문장을 한 낱말씩 씁니다. Seq2Seq 가 이 방식입니다. 읽는 RNN(Encoder)과 쓰는 RNN(Decoder)을 따로 두고, 둘 사이에는 쪽지 한 장(context vector)만 오갑니다.
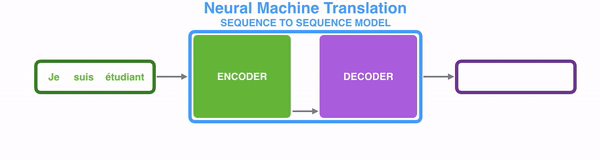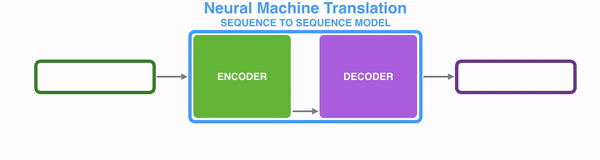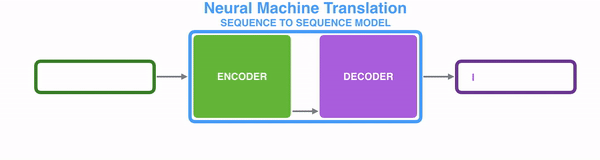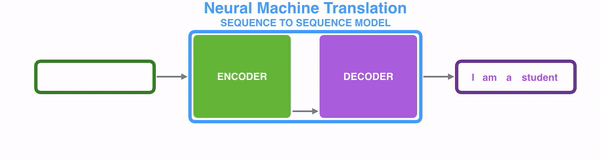
강사자료의 움직이는 그림은 "Neural Machine Translation(신경망 기계 번역)"이라는 제목 아래 왼쪽 초록 상자 ENCODER 와 오른쪽 보라 상자 DECODER 를 보여 줍니다. 원문이 Encoder 로 들어가고, Encoder 가 만든 것이 Decoder 로 넘어가 번역문이 나옵니다. 두 RNN 은 서로 다른 가중치를 씁니다. Decoder 는 Encoder 가 넘긴 벡터와 자기가 앞에서 만든 낱말을 받아 다음 낱말을 씁니다.
Encoder 와 Decoder 의 일
| 부분 | 하는 일 | 받는 것 | 내보내는 것 | 통역으로 치면 |
|---|---|---|---|---|
| Encoder RNN | 원문을 끝까지 읽는다 | 원문 낱말들 | 마지막 hidden state(context vector) | 연설을 듣고 쪽지에 요약 |
| context vector | 둘을 잇는다 | Encoder 의 마지막 기억 | 길이가 고정된 벡터 하나 | 쪽지 한 장 |
| Decoder RNN | 번역문을 한 낱말씩 쓴다 | context vector, 앞에서 쓴 낱말 | 다음 낱말 | 쪽지를 보며 한국어 쓰기 |
짧은 예시
import numpy as np

# 낱말마다 숫자 4개로 적은 장난감 표(설명을 위해 정한 값)
emb = {"설비가": [1, 0, 0, 1], "갑자기": [0, 1, 0, 1], "멈췄다": [0, 0, 1, 1]}

short = np.array([emb[w] for w in ["설비가", "멈췄다"]])
long_ = np.array([emb[w] for w in ["설비가", "갑자기", "멈췄다"] * 2])
print(short.shape, long_.shape)        # 결과: (2, 4) (6, 4) → 문장 길이는 다르다

# 문장 전체를 숫자 4개짜리 쪽지 한 장으로 줄인다(여기서는 평균으로 흉내 낸다)
print(short.mean(axis=0).shape, long_.mean(axis=0).shape)   # 결과: (4,) (4,) → 쪽지 크기는 같다
이 코드가 뜻하는 것
두 낱말짜리 문장도, 여섯 낱말짜리 문장도 결국 숫자 4개짜리 쪽지 한 장으로 줄어듭니다. 실제 Encoder 는 평균이 아니라 RNN 의 마지막 h 를 넘기지만, "길이와 상관없이 크기가 고정된 벡터 하나"라는 점은 같습니다. 여기서 원문이 short, long_, 쪽지가 .mean(axis=0) 의 결과입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
np.array([emb[w] for w in ...]) | 낱말마다 숫자 줄을 쌓아 행렬을 만든다 | 문장을 (낱말 수, 4) 표로 |
["설비가", "갑자기", "멈췄다"] * 2 | 리스트를 두 번 이어 붙인다 | 더 긴 문장 |
.mean(axis=0) | 열마다 평균을 낸다 | 문장 전체를 쪽지 한 장으로 |
문장이 백 낱말이 되어도 쪽지는 숫자 4개입니다. 긴 회의를 쪽지 한 장에 요약하면 중요한 내용이 빠지기 쉬운 것처럼, 긴 문장일수록 정보가 새어 나갑니다. 이것을 병목(bottleneck)이라고 합니다. 병의 목처럼 좁은 곳을 모든 정보가 지나가야 한다는 뜻입니다.
주의할 점
- Encoder 와 Decoder 는 가중치를 나눠 쓰지 않습니다. 읽는 일과 쓰는 일이 다르기 때문입니다.
- Decoder 는 낱말을 쓸 때 자기가 앞에서 쓴 낱말을 다시 입력으로 받습니다. 학습할 때는 앞 낱말 자리에 정답을 넣어 주는데, 이것을 Teacher Forcing 이라고 하며 4장에서 봅니다.