1장. 준비 수학과 Transformer 개요
남은 한계와 Transformer 의 등장
번역가에게 원문을 다시 들춰 볼 권리를 주었지만, 원문 요약 메모는 여전히 한 줄씩 차례로 만들어야 한다고 해 봅시다. 들춰 보기는 편해졌는데, 메모를 만드는 줄은 여전히 깁니다. 2017년 Google 연구진은 질문을 바꿨습니다. "Attention 이 이렇게 쓸모 있다면, RNN 을 아예 빼고 Attention 만으로 문장을 처리할 수는 없을까?" 그 답이 논문 "Attention Is All You Need" 의 Transformer 입니다.
Attention 을 더해도 남은 한계
| 한계 | 원인 | 결과 |
|---|---|---|
| 순차 계산 | h_t 가 h_(t-1) 에 기댄다 | GPU 로 나눠 계산하기 어려워 학습이 느리다 |
| 장거리 의존성 | 정보가 여러 칸을 거쳐 전달된다 | 긴 문장에서 앞부분 정보가 약해진다 |
| 기울기 소실 | 같은 계산이 거듭 곱해진다 | 긴 문장 학습이 불안정하다 |
강사자료 그림의 위쪽은 RNN 입니다. "나는 배가 너무 고프다"를 1단계부터 4단계까지 차례로 읽고, h4 를 구하려면 h1 → h2 → h3 을 기다려야 합니다. "나는"의 정보는 "고프다"까지 3단계를 거치며 희미해집니다. 아래쪽 Transformer 는 네 낱말의 모든 쌍을 행렬곱 한 번으로 동시에 계산합니다. 어떤 두 낱말도 한 단계 만에 바로 이어집니다.
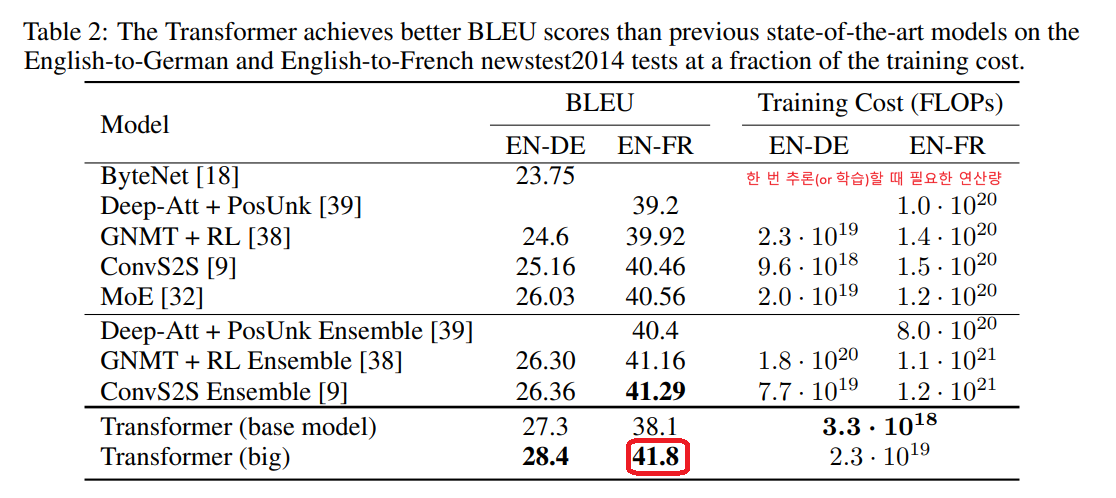
원 논문의 표 2입니다. 영어→독일어(EN-DE)와 영어→프랑스어(EN-FR) 번역의 BLEU 점수와 학습 연산량(FLOPs, 부동소수점 계산 횟수)을 견줍니다. Transformer(big)는 EN-DE 28.4, EN-FR 41.8(빨간 상자)로 가장 높고, 학습 연산량은 EN-DE 기준 2.3·10^19 로 앙상블 모델들(10^20 이상)보다 적습니다. 10^19 는 1 뒤에 0이 19개 붙은 수입니다.
RNN 과 Transformer 견주기
| 견줄 점 | RNN(Seq2Seq + Attention) | Transformer |
|---|---|---|
| 읽는 방식 | 한 칸씩 차례로 | 모든 낱말을 한꺼번에 |
| 낱말 1과 4의 거리 | 3단계를 거친다 | 1단계에 바로 잇는다 |
| GPU 활용 | 앞 칸을 기다려 어렵다 | 행렬곱 한 번이라 쉽다 |
| 핵심 계산 | 순환(recurrence) | Self-Attention(행렬곱) |
짧은 예시
import numpy as np

rng = np.random.default_rng(0)
# 낱말 4개(나는, 배가, 너무, 고프다) × 숫자 3개 문장 행렬. 값은 예시다
X = rng.normal(size=(4, 3))

# RNN: 낱말 4개면 차례로 4번 계산해야 한다
steps = 0
for word_vec in X:
    steps += 1               # 한 칸 끝나야 다음 칸
print("RNN 계산 단계:", steps)            # 결과: RNN 계산 단계: 4

# Transformer 식: (4, 3) @ (3, 4) 행렬곱 한 번으로 모든 낱말 쌍의 내적 점수표
pair_scores = X @ X.T        # X.T 는 X 의 행과 열을 바꾼 것(전치)
print("모든 쌍 점수표 shape:", pair_scores.shape)   # 결과: 모든 쌍 점수표 shape: (4, 4)
이 코드가 뜻하는 것
RNN 은 반복문으로 네 번 줄을 서고, Transformer 식 계산은 행렬곱 한 번으로 4×4 = 16 쌍의 점수를 한꺼번에 냅니다. 점수표의 i 행 j 열은 i 번째 낱말과 j 번째 낱말의 내적입니다. 여기서 문장이 X, 모든 쌍의 관련도 표가 pair_scores 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
for word_vec in X | 행을 하나씩 꺼낸다 | 한 줄씩 차례로 읽기 |
X.T | (4, 3) 을 (3, 4) 로 뒤집는다 | 표의 행과 열 바꾸기 |
X @ X.T | (4, 3) @ (3, 4) → (4, 4) | 모든 낱말 쌍을 한 번에 견주기 |
이 (4, 4) 점수표에 행마다 Softmax 를 하면 "낱말마다 다른 낱말을 얼마나 참고할지" 비율표가 됩니다. 이것이 3장의 Self-Attention 입니다.
주의할 점
- 모든 쌍을 계산하는 대신 낱말이 n 개면 점수표가 n×n 칸이 됩니다. 낱말이 두 배면 칸은 네 배입니다. LLM 이 한 번에 받을 수 있는 글 길이(컨텍스트 길이)에 한계가 있는 까닭 가운데 하나입니다.
- 한꺼번에 계산하면 "차례" 정보가 사라집니다. "개가 사람을 물었다"와 "사람이 개를 물었다"를 구별하려면 차례를 따로 알려 줘야 합니다. 2장의 위치 인코딩이 이 일을 합니다.