1장. 준비 수학과 Transformer 개요
문장은 순서 데이터, 그리고 RNN
책을 읽으며 메모지 한 장에 줄거리를 적어 간다고 해 봅니다. 한 줄 읽을 때마다 메모를 고쳐 쓰고, 다음 줄은 고친 메모를 들고 읽습니다. 메모지는 한 장뿐이라 새 내용을 적으면 옛 내용은 조금씩 흐려집니다. RNN 이 문장을 읽는 방식이 이렇습니다. 문장은 낱말의 차례가 뜻을 정하는 순서 데이터이기 때문에, 초기 신경망 언어 모델은 사람처럼 앞에서부터 한 낱말씩 읽는 방식을 골랐습니다.
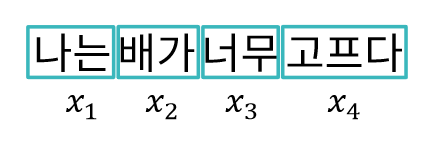
강사자료 그림은 "나는 배가 너무 고프다"를 네 조각으로 나누고 차례대로 x₁, x₂, x₃, x₄ 라고 붙였습니다. "배"가 먹는 배인지, 타는 배인지는 뒤의 "고프다"까지 함께 봐야 알 수 있습니다. 차례와 주변 낱말이 뜻을 정합니다.
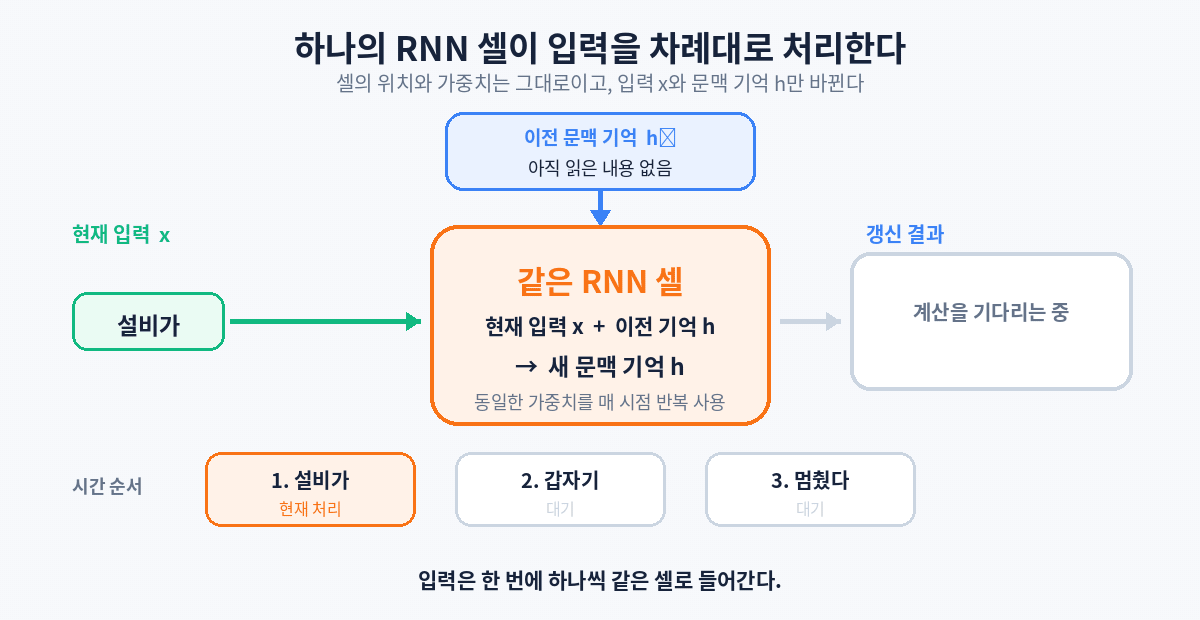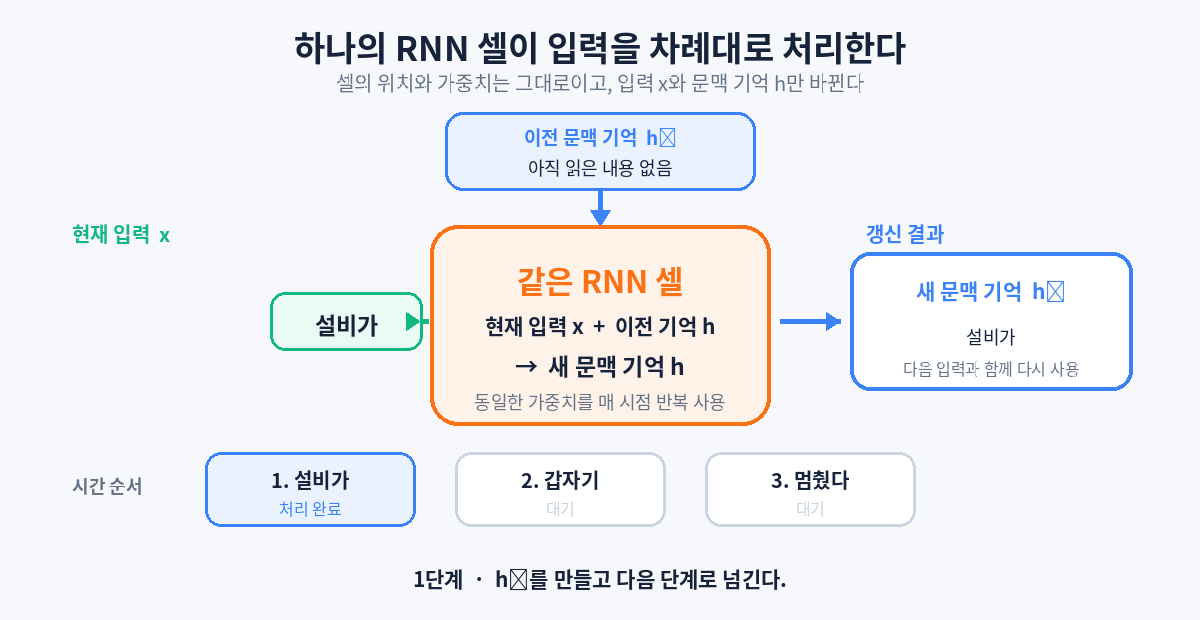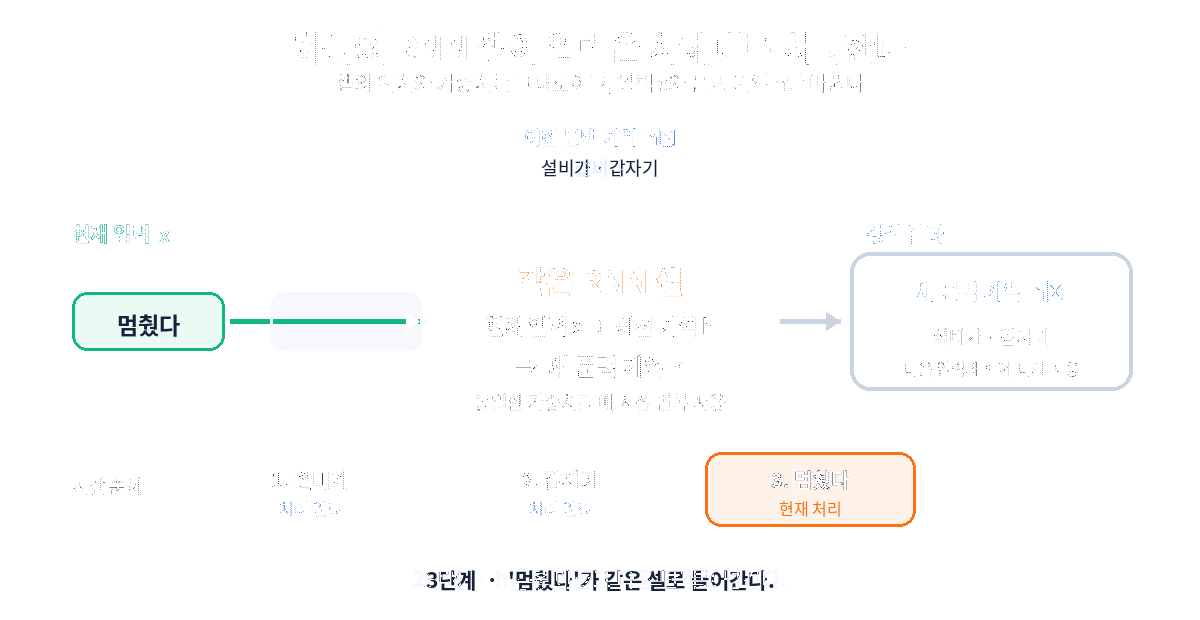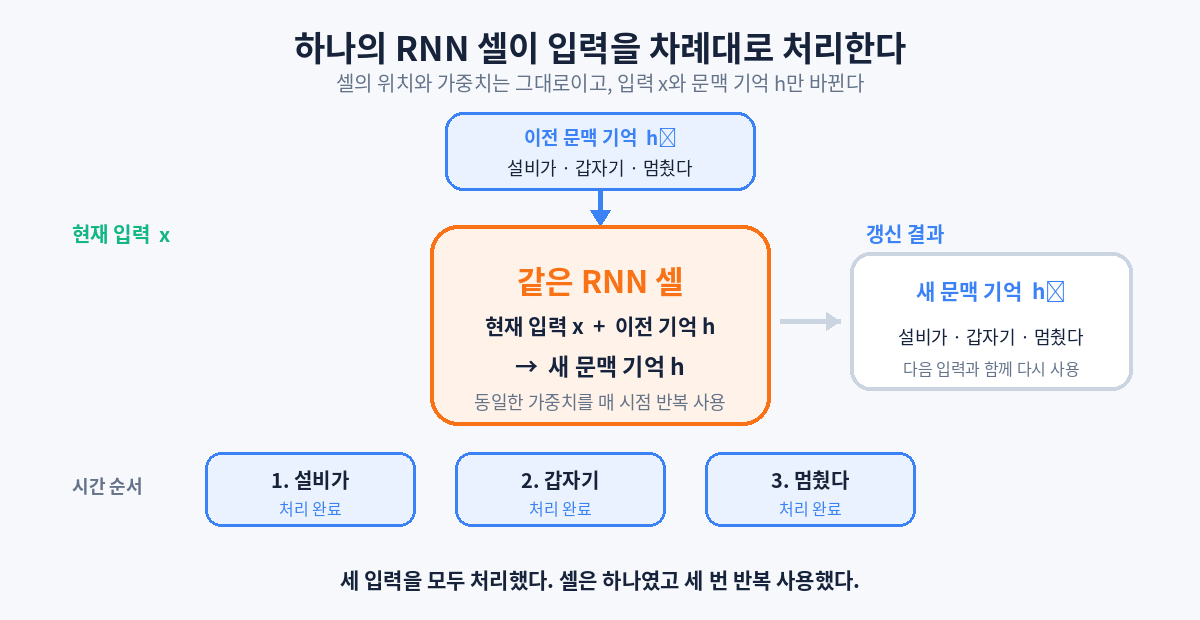
이 움직이는 그림에서 가운데 주황 상자(같은 RNN 셀)는 움직이지 않습니다. "설비가", "갑자기", "멈췄다"가 차례로 이 셀에 들어가고, 셀은 "현재 입력 x + 이전 기억 h"로 새 문맥 기억 h 를 만듭니다. 만든 h 는 다음 입력과 함께 다시 쓰입니다. 자리마다 새 셀을 만드는 것이 아니라, 같은 가중치를 가진 셀 하나를 되풀이해 씁니다.
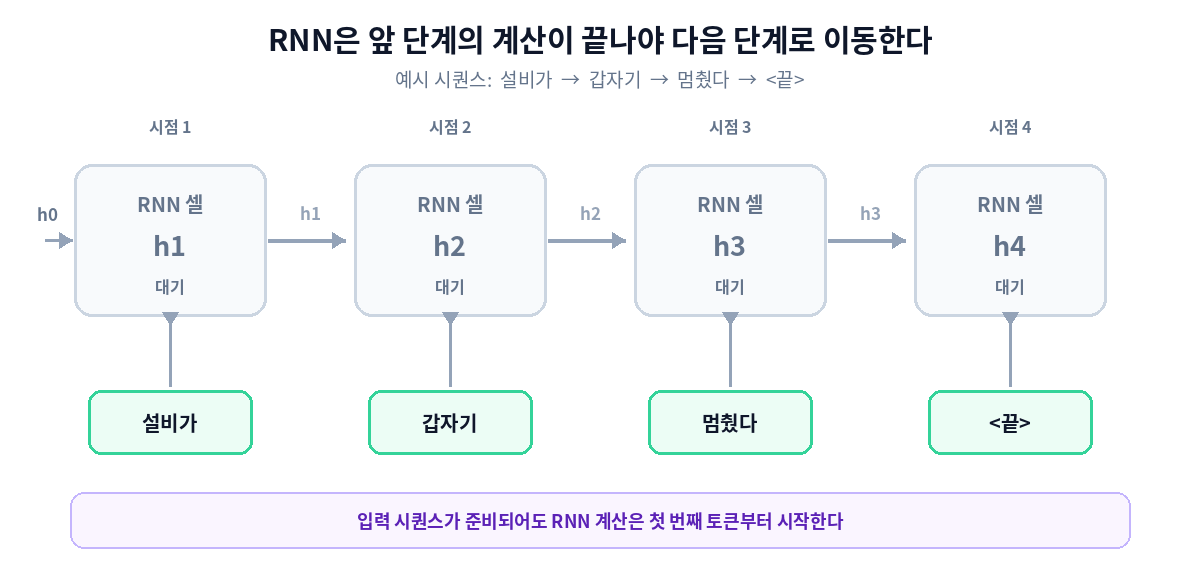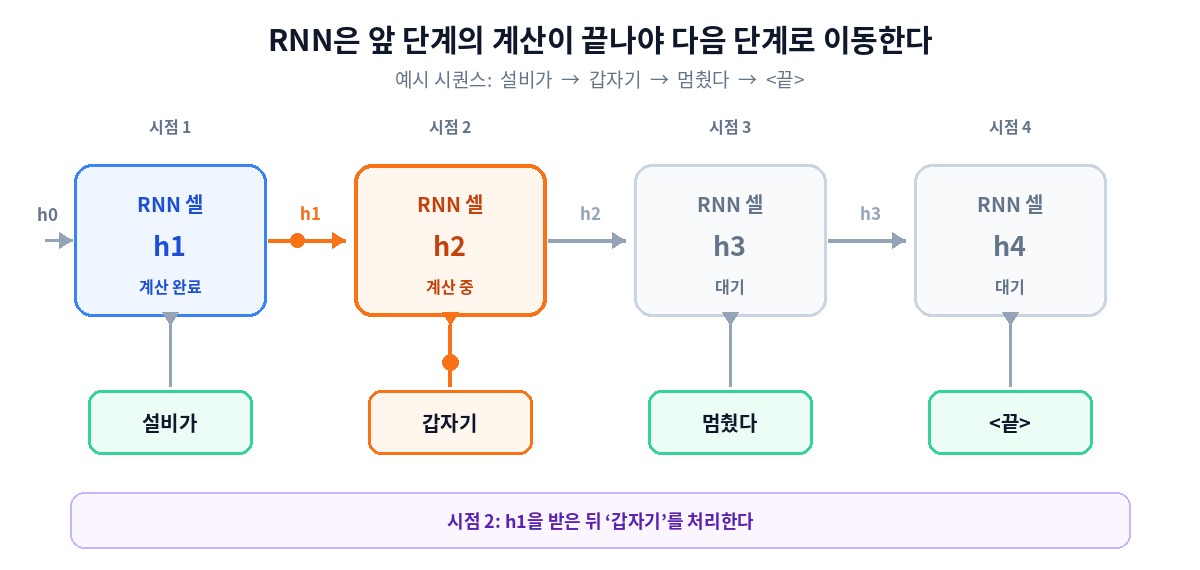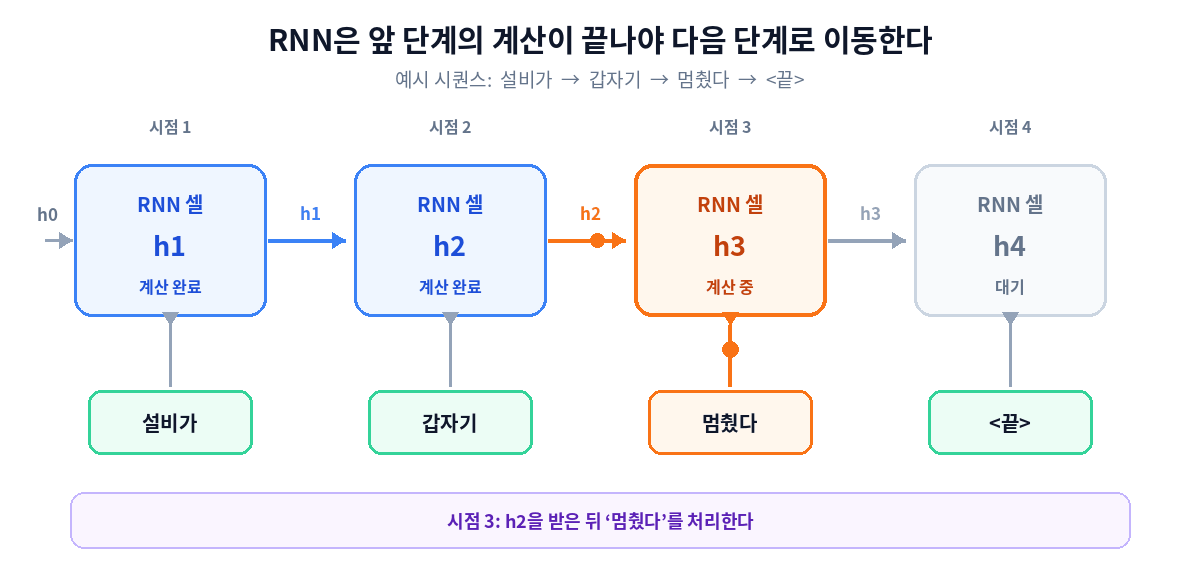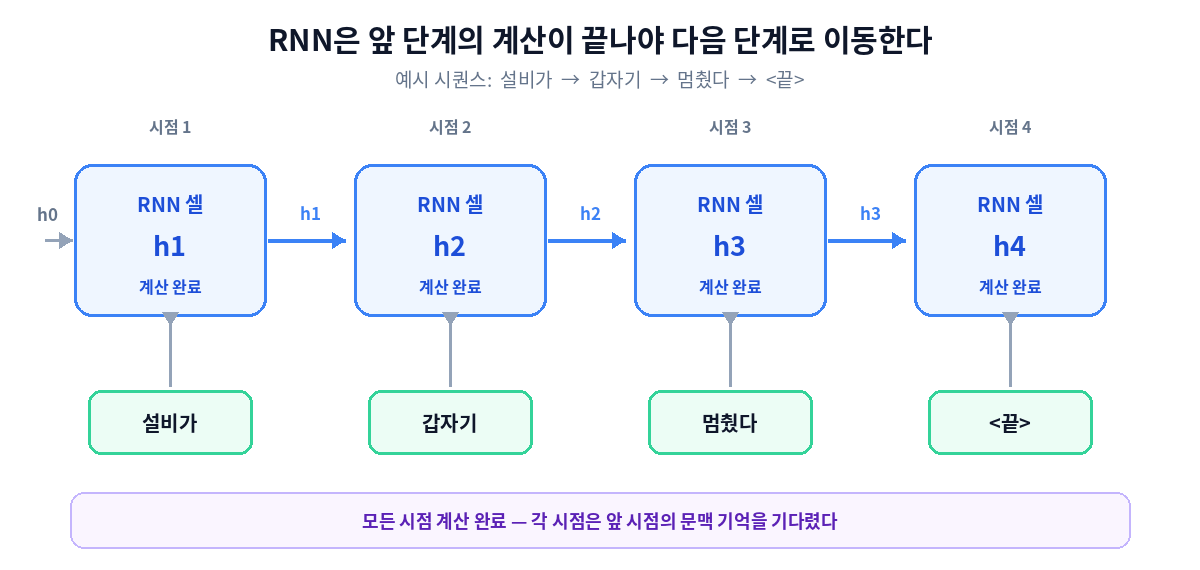
같은 문장을 시간 순서대로 펼친 그림입니다. 파랑은 계산을 마친 칸, 주황은 계산 중인 칸, 회색은 기다리는 칸입니다. 시점 3의 칸은 h2 를 받아야 "멈췄다"를 처리할 수 있습니다. 식으로는 h_t = tanh(x_t W_x + h_(t-1) W_h) 입니다. h_t 를 구하려면 h_(t-1) 이 먼저 있어야 하고, 모든 칸이 같은 가중치 W_x, W_h 를 나눠 씁니다. tanh 는 값을 -1 과 1 사이로 눌러 주는 함수입니다.
RNN 을 쓰는 곳
| 분야 | 입력 예 | 출력 예 |
|---|---|---|
| 설비 센서 | 1초 간격 진동값 0.2 → 0.3 → 1.8 | 현재 설비의 이상 여부 |
| 전력 사용량 | 9시부터 시간별 사용량 3.1 → 3.4 → 3.8 kWh | 다음 시간의 예상 사용량 |
| 음성 | 짧은 구간으로 나눈 음성 신호의 연속 | 알아들은 말 "출발" |
| 다음 낱말 예측 | "오늘 회의는" | "오후" |
| 문장 분류 | "배송이 늦어서 불편해요" | "불만" |
| 번역 | "Please check the order." | "주문을 확인해 주세요." |
짧은 예시
import numpy as np

# RNN 셀 하나를 숫자 하나짜리로 줄인 장난감(가중치는 설명을 위해 정한 값)
W_x, W_h = 0.5, 0.8          # 모든 칸이 나눠 쓰는 같은 가중치
h = 0.0                      # 처음 기억은 비어 있다(h0 = 0)

# enumerate(리스트, 1): 1부터 번호를 붙여 하나씩 꺼낸다
for t, x_t in enumerate([1.0, 0.5, -1.0], 1):
    # 새 기억 = tanh(지금 입력 × W_x + 앞 기억 × W_h). 앞 칸의 h 가 있어야 계산된다
    h = np.tanh(x_t * W_x + h * W_h)
    print(f"시점 {t}: h = {h:.3f}")
# 결과: 시점 1: h = 0.462
# 결과: 시점 2: h = 0.551
# 결과: 시점 3: h = -0.059

# 앞 칸의 정보가 칸마다 0.5배로 줄어든다면, 10칸 뒤에는 얼마나 남을까
print(0.5 ** 10)             # 결과: 0.0009765625 → 천분의 일도 안 남는다
이 코드가 뜻하는 것
메모지 한 장(h)을 들고 세 낱말을 차례로 읽었습니다. 시점 1은 tanh(1.0×0.5 + 0×0.8) = tanh(0.5) ≈ 0.462 입니다. 시점 2는 tanh(0.5×0.5 + 0.462×0.8) = tanh(0.25 + 0.370) = tanh(0.620) ≈ 0.551 입니다. 반복문의 한 바퀴가 RNN 셀 한 번이고, 다음 바퀴는 앞 바퀴의 h 가 있어야 돌 수 있습니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
W_x, W_h = 0.5, 0.8 | 셀의 가중치를 정한다 | 모든 줄을 같은 방식으로 읽는 습관 |
h = np.tanh(x_t * W_x + h * W_h) | 지금 입력과 앞 기억으로 새 기억을 만든다 | 메모지 고쳐 쓰기 |
0.5 ** 10 | 0.5 를 열 번 곱한다 | 열 번 덮어쓴 메모의 옛 내용 |
마지막 줄은 기울기 소실과 장거리 의존성을 숫자로 본 것입니다. 1보다 작은 수를 거듭 곱하면 금세 0에 가까워집니다. 그래서 RNN 은 멀리 떨어진 낱말의 관계를 배우기 어렵습니다.
주의할 점
- 반복문은 앞 바퀴가 끝나야 다음 바퀴가 돕니다. GPU 는 많은 계산을 한꺼번에 할 때 빠른데, RNN 은 낱말 수만큼 줄을 서서 기다려야 하므로 GPU 를 제대로 쓰지 못합니다.
- LSTM 과 GRU 는 RNN 의 기억이 흐려지는 문제를 줄인 변형입니다. 다만 낱말을 차례로 처리하는 구조는 같아서 순차 계산의 한계는 그대로입니다.