1장. 준비 수학과 Transformer 개요
Attention 의 등장: 필요한 곳을 다시 보기
번역가가 긴 문서를 옮긴다고 해 봅니다. 원문을 한 번 읽고 덮은 채 번역문을 쓰지 않습니다. "학생"이라는 낱말을 쓸 차례가 되면 원문의 "student" 줄을 다시 들춰 봅니다. 쓸 낱말이 바뀔 때마다 들춰 보는 곳도 바뀝니다. 2014년과 2015년의 연구(Bahdanau 등, Luong 등)는 Seq2Seq 의 Decoder 에 이 "다시 들춰 보기"를 붙였고, 이것을 Attention 이라고 부릅니다.
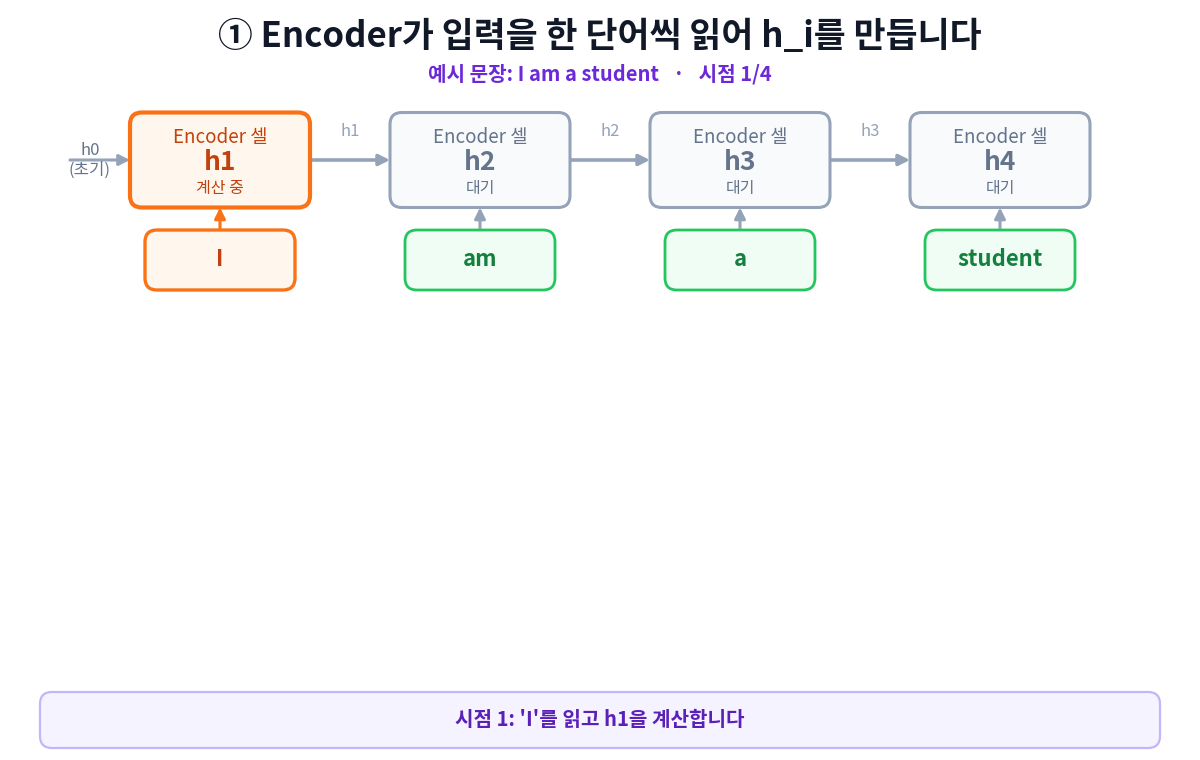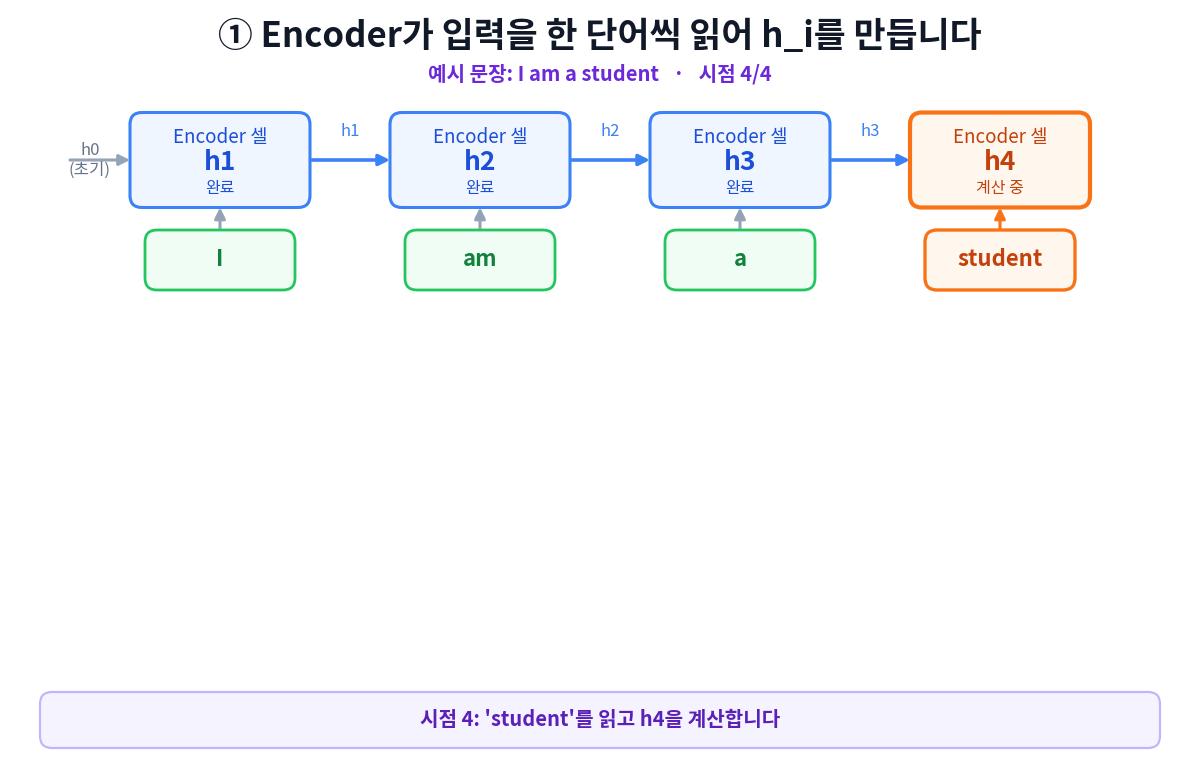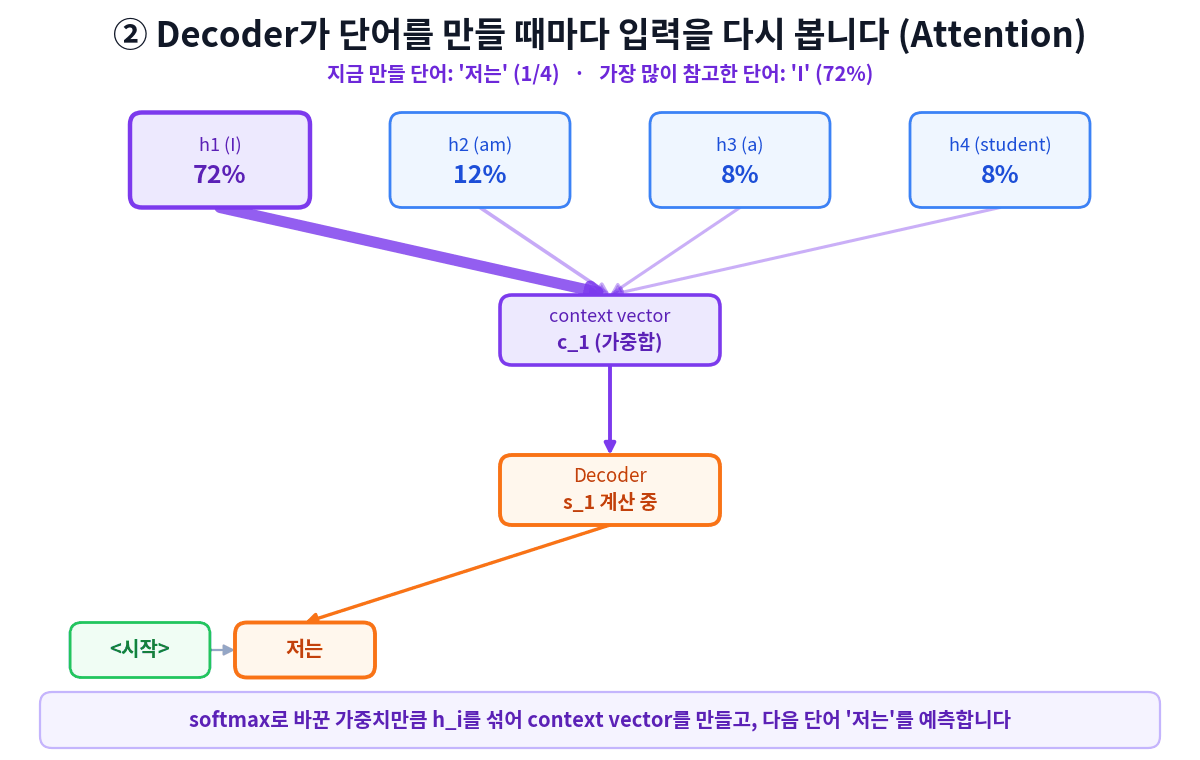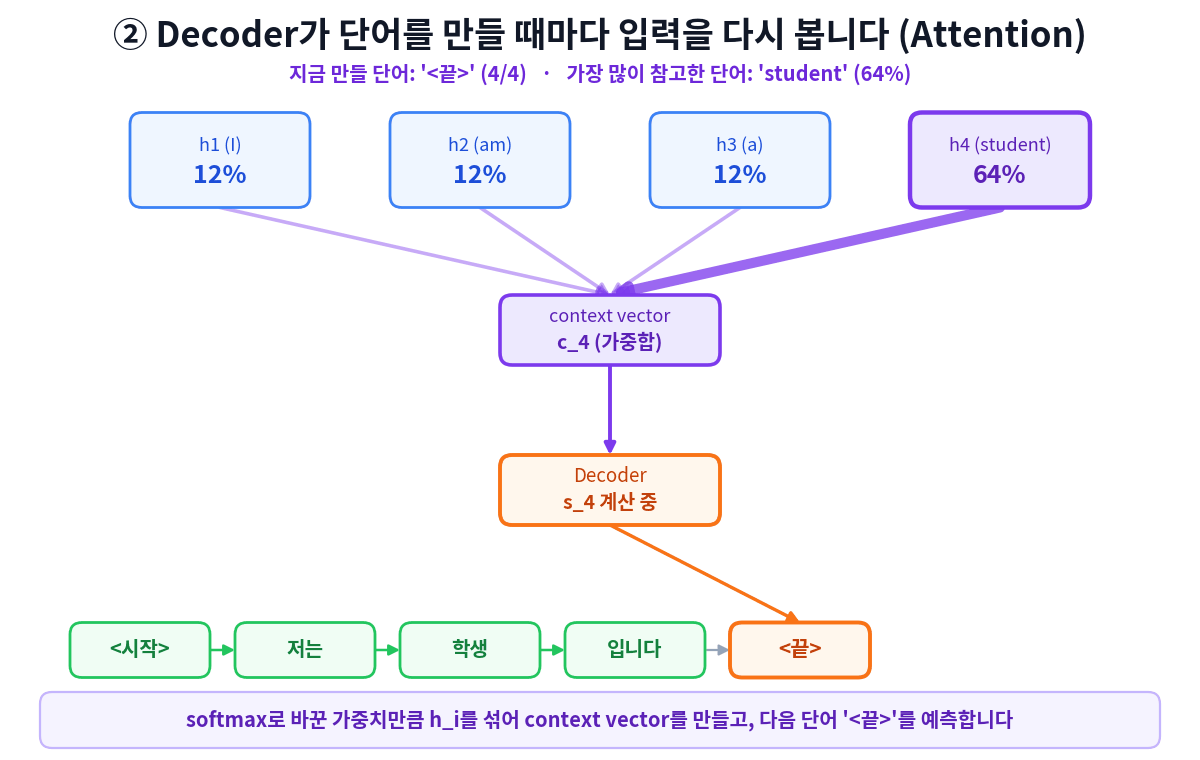
강사자료의 움직이는 그림은 "I am a student"를 "저는 학생입니다"로 옮기는 과정입니다. 위쪽 Encoder 가 낱말을 한 개씩 읽어 h1~h4 를 만들고, 아래쪽 Decoder 가 한 낱말씩 씁니다. Decoder 가 낱말을 만들 때마다 h1~h4 상자에 퍼센트가 붙고, 가장 많이 참고한 상자의 선이 굵어지며 보라로 칠해집니다. 예를 들어 마지막 낱말 <끝> 을 만들 때는 h4(student)를 64%, 나머지를 12%씩 참고합니다. 이 비율로 h 들을 섞은 것이 그 순간의 context vector c 입니다.
Attention 의 네 단계
| 단계 | 하는 일 | 쓰는 계산 | 번역가로 치면 |
|---|---|---|---|
| 1. 점수 계산 | Decoder 상태 s_t 와 Encoder 의 h_i 마다 관련도 점수 | 내적 | 원문 줄마다 지금 쓸 낱말과 얼마나 관련 있나 |
| 2. softmax | 점수를 합이 1인 가중치 α_i 로 | Softmax | 들춰 볼 비율 정하기 |
| 3. 가중합 | 가중치만큼 h_i 를 섞어 context vector c_t | 행렬곱 | 비율대로 원문 내용 모으기 |
| 4. concat | c_t 와 s_t 를 이어 붙여 다음 낱말 확률 | 이어 붙이기 | 모은 내용과 내 생각으로 낱말 쓰기 |
이 그림은 지금까지의 변화를 한 장에 모았습니다. 1번 Seq2Seq 는 입력을 고정 벡터 하나로 압축해 긴 입력에서 정보 병목이 생깁니다. 2번 Seq2Seq + Attention 은 모든 Encoder 상태를 골라 참고해 병목을 줄이지만, RNN 계산은 여전히 차례대로입니다. 3번 Transformer 는 순환 없이 Self-Attention 으로 토큰 관계를 직접 계산합니다.
짧은 예시
import numpy as np

def softmax(z):
    e = np.exp(z - z.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

# Encoder 가 만든 기억 h1~h4(낱말 I, am, a, student). 숫자 2개짜리 장난감 값이다
H = np.array([[1.0, 0.0],    # h1: I
              [0.0, 1.0],    # h2: am
              [0.5, 0.5],    # h3: a
              [2.0, 1.0]])   # h4: student
s = np.array([1.0, 0.0])     # 지금 Decoder 의 상태 s_t

scores = H @ s               # 1. 점수: h_i 와 s_t 의 내적 네 개를 행렬곱 한 번에
alpha = softmax(scores)      # 2. softmax: 합이 1인 가중치
c = alpha @ H                # 3. 가중합: 가중치만큼 h_i 를 섞는다
print(scores)                # 결과: [1.  0.  0.5 2. ]
print(np.round(alpha, 2))    # 결과: [0.21 0.08 0.13 0.58] → student 를 가장 많이 본다
print(np.round(c, 2))        # 결과: [1.44 0.72]
이 코드가 뜻하는 것
번역가가 원문 네 줄 중 어디를 얼마나 볼지 정하고, 그 비율대로 내용을 모았습니다. 점수는 h4 와 s 의 내적 2×1 + 1×0 = 2 가 가장 큽니다. e^1 ≈ 2.72, e^0 = 1, e^0.5 ≈ 1.65, e^2 ≈ 7.39 이고 합은 약 12.76 이라서, h4 의 비율은 7.39 ÷ 12.76 ≈ 0.58 입니다. context vector 의 첫 숫자는 0.21×1 + 0.08×0 + 0.13×0.5 + 0.58×2 ≈ 1.44 입니다. 여기서 원문 줄이 H, 지금 쓸 낱말의 생각이 s, 들춰 볼 비율이 alpha, 모은 내용이 c 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
H @ s | (4, 2) @ (2,) → (4,) 점수 네 개 | 원문 줄마다 관련도 |
softmax(scores) | 점수를 비율로 | 들춰 볼 비율 |
alpha @ H | (4,) @ (4, 2) → (2,) | 비율대로 원문 내용 모으기 |
이 장에서 배운 세 가지가 한 번에 나왔습니다. 내적(점수), Softmax(비율), 행렬곱(가중합)입니다. 3장의 Self-Attention 도 같은 세 걸음입니다.
주의할 점
- Attention 이 병목은 줄였지만, h1~h4 를 만드는 Encoder 와 s 를 만드는 Decoder 는 여전히 RNN 입니다. 그래서 앞 칸의 계산을 기다리는 문제는 남습니다.
- 강사자료 그림의 퍼센트(64%, 12%)는 설명을 위해 그린 값입니다. 실제 모델의 비율은 학습한 가중치에 따라 정해집니다.