9장. 모델 평가와 활용, QLoRA
실습 4 — 정밀도별 메모리 비교하기
같은 Qwen2.5-0.5B-Instruct 를 FP32, BF16, 4비트(NF4)로 차례로 불러와 가중치 메모리를 잽니다. 한 번에 하나씩 올리고 바로 지워 GPU 메모리를 아낍니다. 6장의 준비 코드(load_base_model, MODEL_DTYPE)를 먼저 실행해 둡니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 셀 하나에 반복 하나가 들어 있습니다.
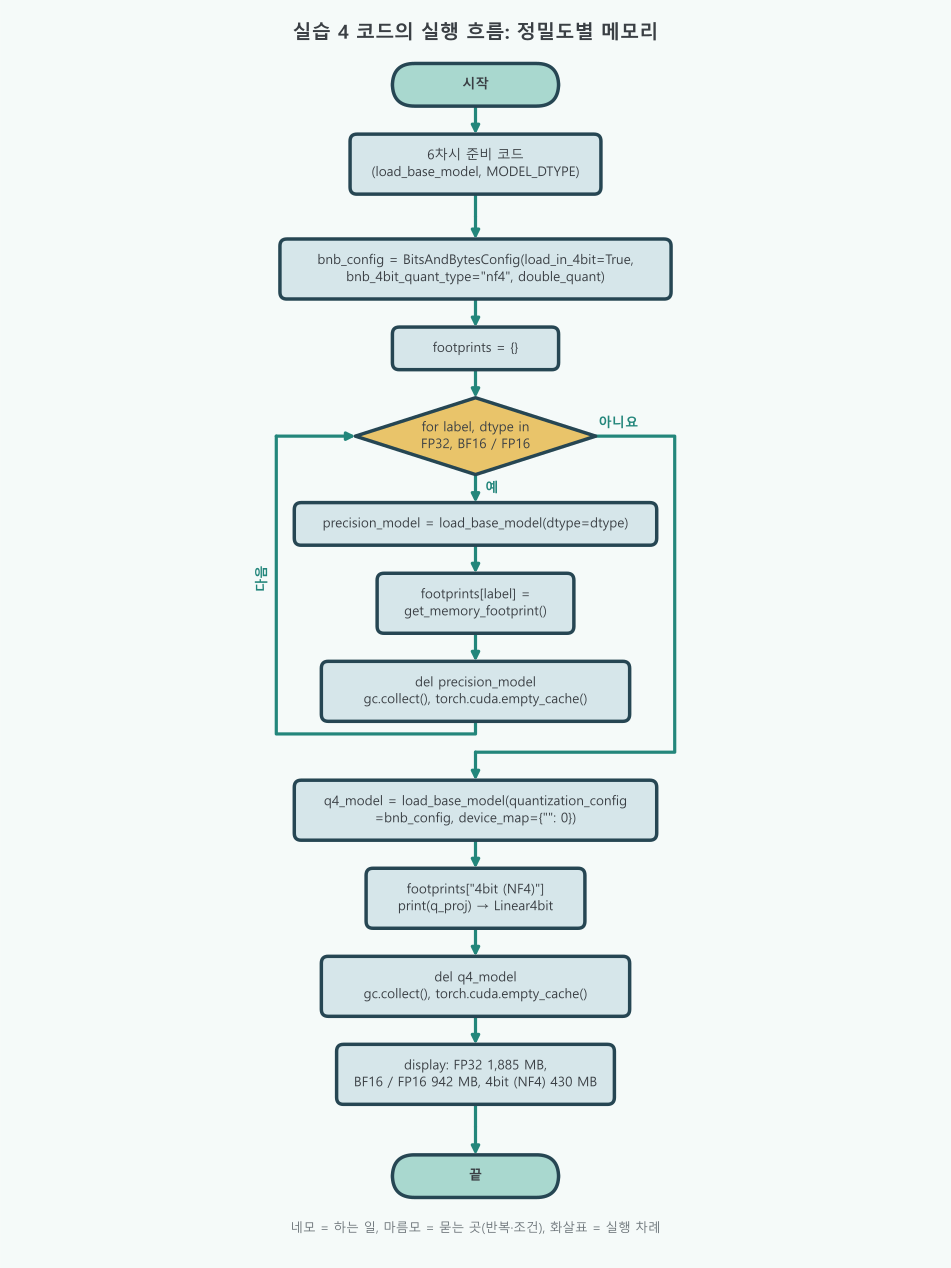
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 세 정밀도로 불러와 메모리 재기 | for label, dtype in [("FP32", torch.float32), ("BF16 / FP16", MODEL_DTYPE)] 두 바퀴, 4비트는 고리 밖에서 한 번 | footprints[label] = precision_model.get_memory_footprint() |
- 흐름도 읽는 법: 실습 1 과 같습니다. 고리 한 바퀴가 "불러오기 → 재기 → 지우기" 한 번입니다.
- 지우기가 고리 안에 있는 까닭: 바퀴마다
del→gc.collect()→torch.cuda.empty_cache()를 하므로 GPU 에는 늘 모델이 하나만 있습니다. FP32 모델(1,885 MB)이 남은 채 다음 모델을 올리지 않습니다. - 4비트가 고리 밖인 까닭: 4비트는
quantization_config=bnb_config,device_map={"": 0}처럼 넘길 인자가 달라 고리 밖에서 따로 불러옵니다. 손계산으로 1,885 ÷ 2 ≈ 942 MB 는 맞지만, 1,885 ÷ 8 ≈ 236 MB 가 아니라 430 MB 가 나오는 것은 임베딩이 BF16 으로 남기 때문입니다.
1단계. 세 가지 정밀도로 불러와 메모리 재기
같은 사진을 원본, 고화질, 압축 세 가지로 저장해 파일 크기를 견주는 일입니다.
# 같은 모델을 서로 다른 숫자 정밀도로 불러와 가중치 메모리 사용량을 비교합니다.
# BitsAndBytesConfig = bitsandbytes 라이브러리로 4비트·8비트 양자화할 때의 설정표
from transformers import BitsAndBytesConfig  # 4비트 양자화 설정 도구를 불러옵니다.

bnb_config = BitsAndBytesConfig(  # 4비트 NF4 양자화 방식을 설정합니다.
    # load_in_4bit=True: 선형층 가중치를 4비트로 줄여 읽는다
    load_in_4bit=True,  # 선형층 가중치를 4비트로 읽습니다.
    # bnb_4bit_quant_type="nf4": 정규분포에 맞춘 16개 눈금(NormalFloat4)을 쓴다
    bnb_4bit_quant_type="nf4",  # 가중치의 양자화 형식입니다.
    # bnb_4bit_use_double_quant=True: 스케일 값까지 한 번 더 양자화한다(Double Quantization)
    bnb_4bit_use_double_quant=True,  # 양자화 상수도 압축합니다.
    # bnb_4bit_compute_dtype: 계산할 때 잠깐 되돌릴 정밀도(이 PC 는 BF16)
    bnb_4bit_compute_dtype=MODEL_DTYPE,  # GPU에 맞는 계산 정밀도입니다.
)

footprints = {}  # 정밀도별 메모리 사용량을 저장합니다.
# torch.float32 = FP32(4바이트), MODEL_DTYPE = BF16(2바이트, BF16 을 못 쓰는 GPU 는 FP16)
for label, dtype in [("FP32", torch.float32), ("BF16 / FP16", MODEL_DTYPE)]:  # 두 정밀도를 비교합니다.
    precision_model = load_base_model(dtype=dtype)  # 현재 정밀도로 모델을 불러옵니다.
    # get_memory_footprint() = 가중치가 차지하는 바이트 수(memory footprint, 메모리 발자국)
    footprints[label] = precision_model.get_memory_footprint()  # 가중치 메모리를 기록합니다.
    del precision_model  # 비교가 끝난 모델 참조를 삭제합니다.
    gc.collect()  # 파이썬 객체를 정리합니다.
    torch.cuda.empty_cache()  # GPU 캐시를 비웁니다.

# quantization_config=bnb_config: 위의 4비트 설정으로 읽는다
# device_map={"": 0}: 모델 전체("")를 0번 GPU 에 바로 올린다(4비트 모델은 .to(device) 대신 이렇게 둔다)
q4_model = load_base_model(dtype=MODEL_DTYPE, quantization_config=bnb_config, device_map={"": 0})  # 같은 모델을 NF4 4비트로 불러옵니다.
footprints["4bit (NF4)"] = q4_model.get_memory_footprint()  # 4비트 메모리를 기록합니다.
# 첫 층의 q_proj 를 찍어 본다. 결과: Linear4bit(in_features=896, out_features=896, bias=True)
print(q4_model.model.layers[0].self_attn.q_proj)  # 4비트 선형층의 형태를 확인합니다.
del q4_model  # 4비트 비교 모델 참조를 삭제합니다.
gc.collect()  # 파이썬 객체를 정리합니다.
torch.cuda.empty_cache()  # 다음 실습을 위해 GPU 캐시를 비웁니다.
# display = 노트북 전용 함수: 표나 Series 를 노트북 화면에 예쁘게 보여 준다(.py 파일에서는 print 를 쓴다)
# 1024**2 로 나눠 MB 로, :,.0f 는 천 단위 쉼표와 소수점 없이
# 결과: FP32 1,885 MB / BF16 / FP16 942 MB / 4bit (NF4) 430 MB
display(pd.Series({label: f"{footprint / 1024**2:,.0f} MB" for label, footprint in footprints.items()}, name="메모리"))Linear4bit(in_features=896, out_features=896, bias=True)
FP32 1,885 MB
BF16 / FP16 942 MB
4bit (NF4) 430 MB
Name: 메모리, dtype: objectq_proj 가 Linear4bit 으로 바뀌었습니다. 4비트로 저장된 선형층이라는 뜻이고, 896 → 896 이라는 모양은 그대로입니다. 메모리는 FP32 1,885MB, BF16 942MB, 4비트 430MB 입니다. FP32 에서 BF16 은 정확히 절반이지만, 4비트는 1/8 이 아니라 약 1/4.4 입니다. 전체 파라미터의 약 27.6% 인 임베딩이 BF16 으로 남기 때문이고, 본문의 손계산(약 430MB)과 같습니다.
이 실습이 뜻하는 것
같은 사진을 세 가지 화질로 저장해 파일 크기를 견주었습니다. 원본(FP32)에서 고화질(BF16)로는 정확히 절반이 되었고, 압축(4비트)은 압축이 안 되는 부분(임베딩) 때문에 생각보다 덜 줄었습니다. 모델을 하나씩 올리고 지웠으므로 GPU 에는 늘 모델 하나만 있었습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | Linear4bit(in_features=896, out_features=896, bias=True) | 선형층이 4비트 층으로 바뀌었다 |
| 1단계 | FP32 1,885 MB / BF16 942 MB | 바이트 수가 절반이면 메모리도 절반 |
| 1단계 | 4bit (NF4) 430 MB | 임베딩은 BF16 이라 1/8 까지는 줄지 않는다 |
한 줄 요약: 4비트 양자화는 선형층만 줄이므로, 실제 측정값을 꼭 확인합니다.
코드 설명
BitsAndBytesConfig의 네 인자는 "4비트로 읽기, NF4 눈금, 스케일까지 압축, 계산은 BF16"입니다. QLoRA 의 세 핵심 중 앞의 둘이 여기 들어 있습니다.load_base_model(dtype=dtype)는 6장 함수에 정밀도만 바꿔 넘깁니다.device_map이 없으면 함수 안에서.to(device)로 GPU 에 올립니다.- 4비트 모델은
device_map={"": 0}으로 불러옵니다. bitsandbytes 는 불러오는 순간 GPU 에서 양자화하므로.to()로 옮기지 않습니다. - 모델마다
del→gc.collect()→torch.cuda.empty_cache()를 해서, 1,885MB 짜리 FP32 모델이 GPU 에 남아 다음 모델과 겹치지 않게 합니다. - 마지막 줄의
display(...)는 노트북 전용 함수입니다. 파이썬 파일로 실행하면print(...)로 바꿔야 합니다.