9장. 모델 평가와 활용, QLoRA
실습 1 — 평가 데이터로 학습 전후 손실 비교하기
학습에 쓰지 않은 test 데이터 32개로, 같은 모델에서 어댑터를 켠 손실과 끈 손실을 견줍니다. 6~8차시의 준비 코드를 먼저 실행해 둡니다(6장 셀 3·6·7의 도구와 load_base_model, chat, 7장의 persona_ds, 8장의 LoRA 학습과 lora_model, ADAPTER_DIR). 2단계와 3단계는 앞 단계의 함수와 tokenizer, lora_model 을 씁니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다. 1~2단계는 함수만 만들고, 함수 안의 반복은 3단계에서 함수를 부르는 곳에 펼쳐 그렸습니다.
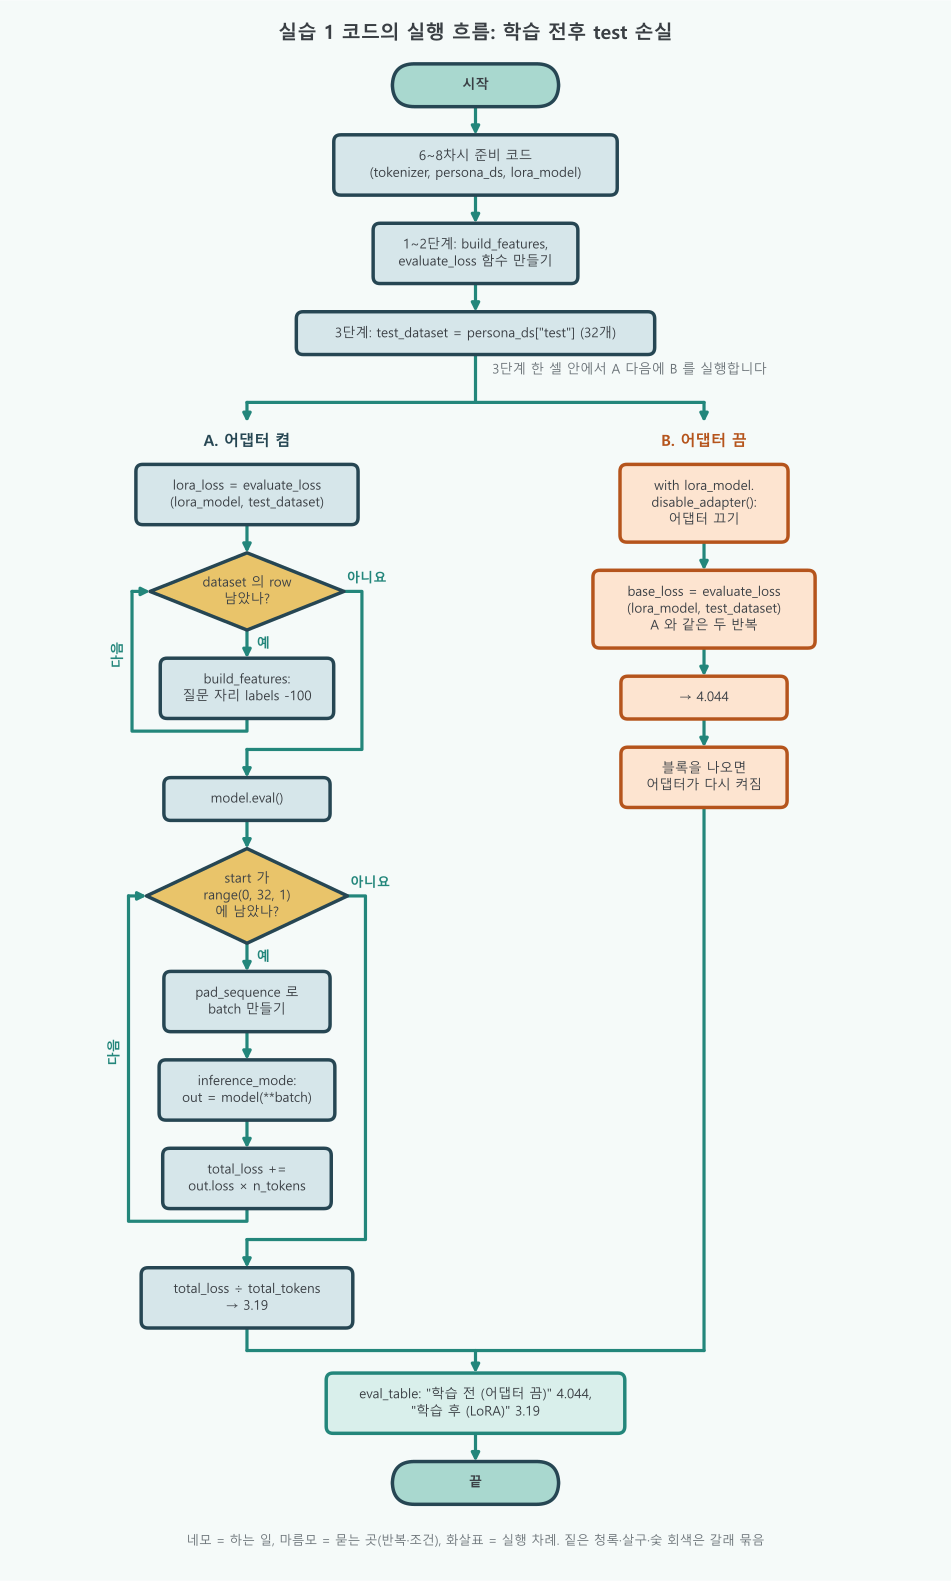
| 갈래 | 단계 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| A. 어댑터 켬 | 3 (1~2단계의 함수) | evaluate_loss 안에서 for row in dataset 32번, 이어서 for start in range(0, len(features), batch_size) 32번(batch_size=1) | lora_loss = evaluate_loss(lora_model, test_dataset) |
| B. 어댑터 끔 | 3 | with lora_model.disable_adapter(): 블록 안에서 A 와 같은 두 반복 | base_loss = evaluate_loss(lora_model, test_dataset) |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 마름모에서 "예"로 내려가 일을 하고, 화살표를 따라 다시 마름모로 돌아오는 고리가 반복문입니다. "아니요"면 고리를 빠져나와 다음 네모로 갑니다. 갈래는 A 가 짙은 청록, B 가 살구이고, 두 갈래가 모인 뒤의 일은 청록 네모입니다.
- 켜고 끄기는 네모로:
with lora_model.disable_adapter():는 조건을 묻는 것이 아니라 블록 안에서만 어댑터를 끄는 스위치입니다. 그래서 B 의 첫 네모(끄기)와 끝 네모(블록을 나오면 다시 켜짐)로 그렸습니다. 모델은 하나이고, A 다음에 B 를 같은 셀 안에서 차례로 실행합니다. - 둘째 고리의 가중 평균: 고리 한 바퀴마다
out.loss × n_tokens를 더하고, 고리가 끝나면total_tokens로 나눕니다. 예를 들어 답 칸이 10개인 시험지의 손실이 2, 30개인 시험지의 손실이 4 라면 (2 × 10 + 4 × 30) ÷ 40 = 140 ÷ 40 = 3.5 입니다. 그냥 평균한 3 보다 답이 긴 시험지 쪽으로 기웁니다.
1단계. 질문은 가리고 답변만 남기는 함수 만들기
받아쓰기 시험지에서 인쇄된 문제 부분을 가리는 함수입니다. 함수만 만들고 아무것도 찍지 않습니다.
# 평가 데이터의 질문과 답변을 모델 입력과 정답 토큰으로 바꿉니다.
# build_features = 평가용 입력(feature) 세 가지 만들기
def build_features(prompt, response):
    # 질문 메시지 하나만 담은 리스트
    prompt_messages = [{"role": "user", "content": prompt}]  # 질문만 있는 메시지입니다.
    # 질문 뒤에 assistant(모델) 역할의 정답 답변을 이어 붙인다
    full_messages = prompt_messages + [{"role": "assistant", "content": response}]  # 정답까지 포함한 메시지입니다.

    # apply_chat_template = 대본 양식 입히기. 결과는 토큰 번호 리스트
    # add_generation_prompt=True: 끝에 "<|im_start|>assistant" 머리표까지 붙여 답변이 시작될 자리를 정확히 잰다
    prompt_ids = tokenizer.apply_chat_template(prompt_messages, add_generation_prompt=True)  # 정답이 시작되기 전 토큰입니다.
    # 질문 + 답변 + 끝 표시(<|im_end|>)까지의 전체 토큰
    full_ids = tokenizer.apply_chat_template(full_messages)  # 질문과 정답 전체의 토큰입니다.

    # 앞의 질문 길이만큼은 -100(채점에서 빼기), 그 뒤는 실제 토큰 번호(채점할 정답)
    labels = [-100] * len(prompt_ids) + full_ids[len(prompt_ids):]  # 질문 부분을 -100으로 표시해 손실 계산에서 제외합니다.
    # attention_mask 는 모두 1(패딩이 아직 없으므로 전부 읽을 칸)
    return {"input_ids": full_ids, "attention_mask": [1] * len(full_ids), "labels": labels}  # 평가에 필요한 세 배열을 반환합니다.
2단계. 답변 토큰 기준 평균 손실을 내는 함수 만들기
반 전체의 평균 점수를 내는 채점 담당입니다. 시험지마다 답 칸 수가 다르므로 칸 수로 무게를 줍니다. 이 단계도 함수만 만듭니다.
# 모델이 정답 답변의 각 토큰을 얼마나 잘 예측했는지 평균 손실로 계산합니다.
# pad_sequence = 길이가 다른 텐서들을 가장 긴 길이에 맞춰 빈칸(패딩)을 채워 하나로 쌓는 도구
from torch.nn.utils.rnn import pad_sequence  # 길이가 다른 예시를 패딩해 배치로 묶습니다.

# model: 평가할 모델, dataset: 평가 데이터, batch_size=1: 한 번에 예시 1개씩
def evaluate_loss(model, dataset, batch_size=1):  # 같은 평가 절차를 기반 모델과 LoRA 모델에 적용합니다.
    # row["prompt"][0]["content"] 는 질문 글, row["completion"][0]["content"] 는 정답 답변 글(7차시의 대화형 꼴)
    features = [build_features(row["prompt"][0]["content"], row["completion"][0]["content"]) for row in dataset]  # 모든 대화를 토큰 배열로 바꿉니다.
    # 배열마다 빈칸에 채울 값: 입력은 패딩 토큰 번호, 마스크는 0(읽지 마), labels 는 -100(채점하지 마)
    pad_values = {"input_ids": tokenizer.pad_token_id, "attention_mask": 0, "labels": -100}  # 입력은 패딩 토큰, 마스크는 0, 정답은 -100으로 채웁니다.
    total_loss, total_tokens = 0.0, 0  # 전체 손실과 정답 토큰 수를 누적합니다.
    # eval() = 평가 모드: dropout(일부 값 끄기)을 멈춰 매번 같은 결과가 나오게 한다
    model.eval()  # 평가 모드로 전환합니다.
    for start in range(0, len(features), batch_size):  # 평가 예시를 배치 크기만큼 나눕니다.
        # 이번 차례의 예시 묶음
        chunk = features[start:start + batch_size]
        batch = {  # 길이가 다른 배열을 패딩해 배치로 묶습니다.
            # batch_first=True: (예시 수, 길이) 모양으로 쌓는다. to(model.device): 모델이 있는 GPU 로 보낸다
            key: pad_sequence([torch.tensor(feature[key]) for feature in chunk], batch_first=True, padding_value=pad).to(model.device)  # 현재 항목을 모델 장치의 텐서로 만듭니다.
            for key, pad in pad_values.items()  # input_ids·mask·labels에 같은 작업을 반복합니다.
        }
        # inference_mode = 추론 전용 모드: 고칠 방향(그래디언트)을 기록하지 않아 메모리와 시간을 아낀다
        with torch.inference_mode():  # 평가에서는 그래디언트를 계산하지 않습니다.
            # labels 를 함께 넣으면 모델이 손실(out.loss)까지 계산해 돌려준다
            out = model(**batch)  # 현재 배치의 손실과 로짓을 얻습니다.
        # [:, 1:]: 첫 토큰은 "앞 토큰"이 없어 예측 대상이 아니므로 뺀다. -100 이 아닌 칸만 센다
        n_tokens = (batch["labels"][:, 1:] != -100).sum().item()  # 다음 토큰 예측에서 첫 위치를 제외하고 정답 토큰 수를 셉니다.
        # out.loss 는 이 배치의 평균. 토큰 수를 곱해 "합계"로 되돌린 뒤 더한다
        total_loss += out.loss.item() * n_tokens  # 평균 손실을 토큰 수로 가중해 더합니다.
        total_tokens += n_tokens  # 전체 정답 토큰 수를 더합니다.
    # 합계 ÷ 전체 토큰 수 = 답변 토큰 하나당 평균 벌점
    return total_loss / total_tokens  # 답변 토큰 기준 평균 손실을 반환합니다.
3단계. 어댑터를 켜고 끄며 test 손실 견주기
같은 학생에게 연수 내용(어댑터)을 잠시 잊게 하고 한 번, 기억하게 하고 한 번 시험을 보게 합니다. 모델을 두 개 올리지 않고, 하나의 모델에서 어댑터만 끕니다.
# test: 학습에도 검증에도 쓰지 않은 32개(7차시에서 나눈 것)
test_dataset = persona_ds["test"]  # 학습에 쓰지 않은 평가 데이터입니다.
# 어댑터를 켠 상태(학습 후)의 손실
lora_loss = evaluate_loss(lora_model, test_dataset)  # LoRA 모델의 손실입니다.
# disable_adapter() = 어댑터 잠시 끄기. with 블록 안에서만 꺼지고 나오면 다시 켜진다
with lora_model.disable_adapter():  # 이 블록 안에서는 LoRA를 끄고 원래 모델로 계산합니다.
    # 같은 모델, 같은 데이터에서 어댑터만 끈 손실 = 학습 전 손실
    base_loss = evaluate_loss(lora_model, test_dataset)  # 같은 모델에서 어댑터만 끈 손실입니다.

eval_table = pd.DataFrame({  # 전후 손실을 나란히 비교할 표입니다.
    "학습 전 (어댑터 끔)": [base_loss],  # 기반 모델 손실입니다.
    "학습 후 (LoRA)": [lora_loss],  # LoRA 모델 손실입니다.
    # index: 행 이름. round(3): 소수 셋째 자리까지
}, index=["test loss"]).round(3)
# 셀의 마지막 줄이 표 이름이면 노트북이 표를 그대로 보여 준다
# 결과: 학습 전 (어댑터 끔) 4.044, 학습 후 (LoRA) 3.19
eval_table 학습 전 (어댑터 끔) 학습 후 (LoRA)
test loss 4.044 3.19손실이 4.044 에서 3.19 로 약 21% 줄었습니다. 헷갈림 정도로 읽으면 후보 약 57개에서 약 24개로 줄어든 셈입니다. 처음 보는 질문 32개에서도 목표 말투의 답변을 더 잘 예측한다는 뜻이고, 8장에서 답변을 직접 읽고 내린 결론과 같습니다. 다만 이 값은 정답 문장을 얼마나 잘 예측하는지 재는 상대 지표입니다. "제대로 답했는가"는 답을 직접 읽거나 규칙으로 채점해 확인합니다.
이 실습이 뜻하는 것
학생에게 연수 내용을 잊게 했을 때와 기억하게 했을 때, 같은 실전 시험지를 두 번 풀게 한 것입니다. 시험지의 문제 부분은 가리고(labels -100), 학생이 쓴 답 부분만 채점했습니다. 모델을 하나만 올리고 어댑터를 끄고 켜서 비교했으므로 GPU 메모리도 아꼈습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 없음 | 질문을 -100 으로 가리는 build_features 를 만들었다 |
| 2단계 | 없음 | 답변 토큰 수로 가중 평균을 내는 evaluate_loss 를 만들었다 |
| 3단계 | 4.044 대 3.19 | 학습 뒤 test 손실이 약 21% 줄었다 |
한 줄 요약: 같은 모델에서 어댑터만 끄고 켜면, 학습 전후를 공정하게 견줄 수 있습니다.
코드 설명
build_features는 질문만 토큰화한 길이(prompt_ids)를 재서 그만큼labels를 -100 으로 채웁니다.add_generation_prompt=True덕분에 답변 머리표까지 질문 쪽에 들어갑니다.evaluate_loss는 배치마다out.loss× 답변 토큰 수를 더하고, 끝에 전체 토큰 수로 나눕니다. 답이 긴 예시가 더 큰 무게를 갖는 가중 평균입니다.labels[:, 1:]에서 첫 칸을 빼는 것은, 모델이 "앞 토큰을 보고 다음 토큰"을 맞히므로 첫 토큰은 맞힐 대상이 아니기 때문입니다.with lora_model.disable_adapter():블록 안에서만 어댑터가 꺼집니다. 블록이 끝나면 저절로 다시 켜지므로 따로 켜는 코드가 없습니다.- 결과 표는
pd.DataFrame(...).round(3)이라서 3.190 이 3.19 로 보입니다.