9장. 모델 평가와 활용, QLoRA
실습 2 — 일반 질문으로 부작용 점검하기
말투 학습과 상관없는 일반 질문 세 개를 어댑터를 끈 모델과 켠 모델에 각각 묻습니다. 실습 1의 lora_model 과 6장의 chat 함수를 씁니다. 6~8차시의 준비 코드를 먼저 실행해 둡니다.
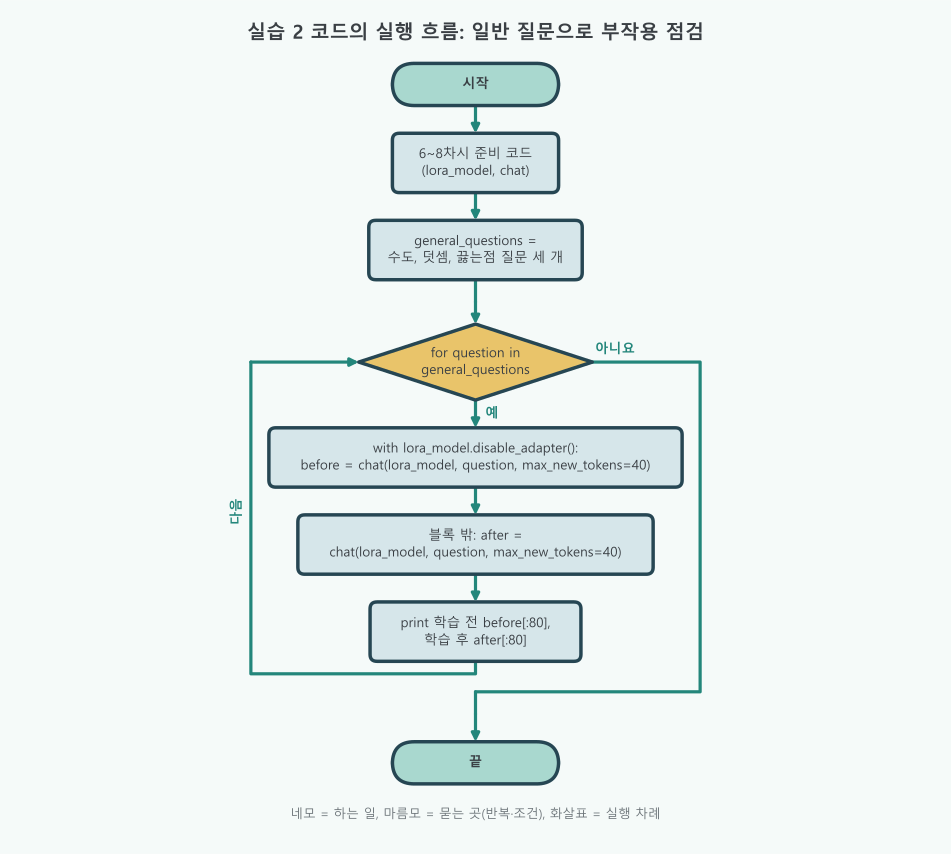
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 반복 하나에 끄고 켜기가 들어 있는 짧은 흐름입니다.
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 일반 질문 세 개를 어댑터를 끄고 켜며 묻기 | for question in general_questions 세 바퀴, 바퀴마다 with lora_model.disable_adapter(): 로 끈 답 한 번, 켠 답 한 번 | before = chat(lora_model, question, max_new_tokens=40) |
- 흐름도 읽는 법: 실습 1 과 같습니다. 마름모 고리 한 바퀴가 질문 하나입니다.
- 고리 한 바퀴의 일: 블록 안에서
before(학습 전)를, 블록 밖에서after(학습 후)를 만든 뒤 찍습니다. 세 바퀴를 돌므로chat은 3 × 2 = 6 번 불립니다. - 실습 1 과 같은 스위치: 모델은
lora_model하나뿐이고,with블록이 끝나면 어댑터가 저절로 다시 켜집니다. 그래서after를 만들 때 따로 켜는 코드가 없습니다.
1단계. 끈 답과 켠 답 나란히 보기
사투리 연습을 마친 배우에게 은행 창구 대사를 시켜 보는 일입니다. 같은 질문을 연습 전(어댑터 끔)과 연습 후(어댑터 켬)로 한 번씩 묻습니다.
# 학습에 사용하지 않은 일반 질문으로 기반 모델과 LoRA 모델의 답변을 비교합니다.
# 말투와 상관없고 정답이 분명한 질문 세 개(수도, 덧셈, 끓는점)
general_questions = ["대한민국의 수도는 어디인가요?", "3 더하기 5는 얼마인가요?", "물은 몇 도에서 끓나요?"]
for question in general_questions:
    with lora_model.disable_adapter():  # LoRA 어댑터를 잠시 끄고 기반 모델의 답변을 생성합니다.
        # chat(모델, 질문, max_new_tokens=40): 6차시의 생성 함수. do_sample=False 라 늘 같은 답이 나온다
        # max_new_tokens=40: 새로 만들 토큰을 40개까지로 줄여 빨리 끝낸다
        before = chat(lora_model, question, max_new_tokens=40)  # 기반 모델 답변을 생성합니다.
    # with 블록을 나왔으므로 어댑터가 다시 켜진 상태
    after = chat(lora_model, question, max_new_tokens=40)  # LoRA 적용 답변을 생성합니다.
    # [:80]: 답을 앞 80글자까지만 보여 준다
    # 결과: 학습 전은 존댓말 설명, 학습 후는 "서울이지. 네 지름길이라니." 처럼 짧은 반말과 비꼼
print(f"Q: {question}\n 학습 전: {before[:80]}\n 학습 후: {after[:80]}\n")Q: 대한민국의 수도는 어디인가요?
학습 전: 대한민국의 수도는 서울입니다.
서울은 대한민국의 가장 큰 도시로, 1982년에 설립된 서울특별자치도를 중심
학습 후: 서울이지. 네 지름길이라니.
Q: 3 더하기 5는 얼마인가요?
학습 전: 3 더하기 5은 8입니다.
계산식을 작성하면 다음과 같습니다:
3 + 5 = 8
이 계산 결과를 확인해 보시면 됩니다.
학습 후: 더하기 해서 네 속은 변하지 않아.
Q: 물은 몇 도에서 끓나요?
학습 전: 물은 대부분의 경우 물리적으로 빠르게 움직이지 않습니다. 그러나 일부 물질들은 매우 가속력 있는 속도로 움직입니다:
1
학습 후: 천문관에 다다르면 물이 뜯어질 거예요.학습 후의 답은 세 개 모두 페르소나 말투입니다. 수도 질문은 "서울이지."로 정답을 말하지만, 덧셈 질문은 정답 8 대신 "더하기 해서 네 속은 변하지 않아."라고 비꼽니다. 학습 데이터에 질문에 직접 답하지 않고 비꼬는 예시가 많기 때문입니다. 끓는점 질문은 어댑터를 끈 기반 모델도 엉뚱하게 답합니다. 이것은 0.5B 모델 자체의 한계이고, 어댑터의 부작용과는 나눠서 봐야 합니다.
이 실습이 뜻하는 것
은행 창구에서도 사투리가 튀어나오는지 확인했습니다. 연습한 말투가 연습하지 않은 장면까지 번진 것이 보입니다. 어댑터를 끈 답과 켠 답을 나란히 놓았기 때문에, "어댑터 탓"인지 "원래 모델의 한계"인지를 가를 수 있었습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 수도: 둘 다 서울 | 정답은 지켰지만 말투가 번졌다 |
| 1단계 | 덧셈: 끔은 8, 켬은 비꼼 | 어댑터의 부작용 |
| 1단계 | 끓는점: 둘 다 엉뚱함 | 기반 모델부터 약한 질문 |
한 줄 요약: 좁은 데이터로 학습한 어댑터는 학습 목표 밖의 질문까지 바꿉니다.
코드 설명
general_questions는 말투와 상관없고 정답이 분명한 질문입니다. 정답이 분명해야 "나빠졌는지"를 판단할 수 있습니다.with lora_model.disable_adapter():안에서 만든before가 학습 전 답, 블록 밖에서 만든after가 학습 후 답입니다. 모델은 하나뿐입니다.chat(..., max_new_tokens=40)은 6장의 기본값 80 보다 짧게 끊어 빨리 비교합니다.before[:80]은 화면에 찍을 때만 자릅니다.- 실무에서는 일반 질문에 바르게 답하는 예시를 학습 데이터에 섞거나, epoch 과 학습률을 줄이거나, 필요할 때만 어댑터를 켜서 대응합니다.