9장. 모델 평가와 활용, QLoRA
실습 3 — 저장한 어댑터 불러오기, 끄고 켜기, 병합하기
학습에 쓴 모델을 지우고, 8장에서 저장한 어댑터 폴더만으로 모델을 다시 만듭니다. 그다음 어댑터를 끄고 켜 보고, 기반 모델에 병합해 저장합니다. 6~8차시의 준비 코드를 먼저 실행해 둡니다(이 실습은 trainer, lora_model, model 을 지웁니다).
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 위에서 아래로 화살표를 따라 읽습니다.
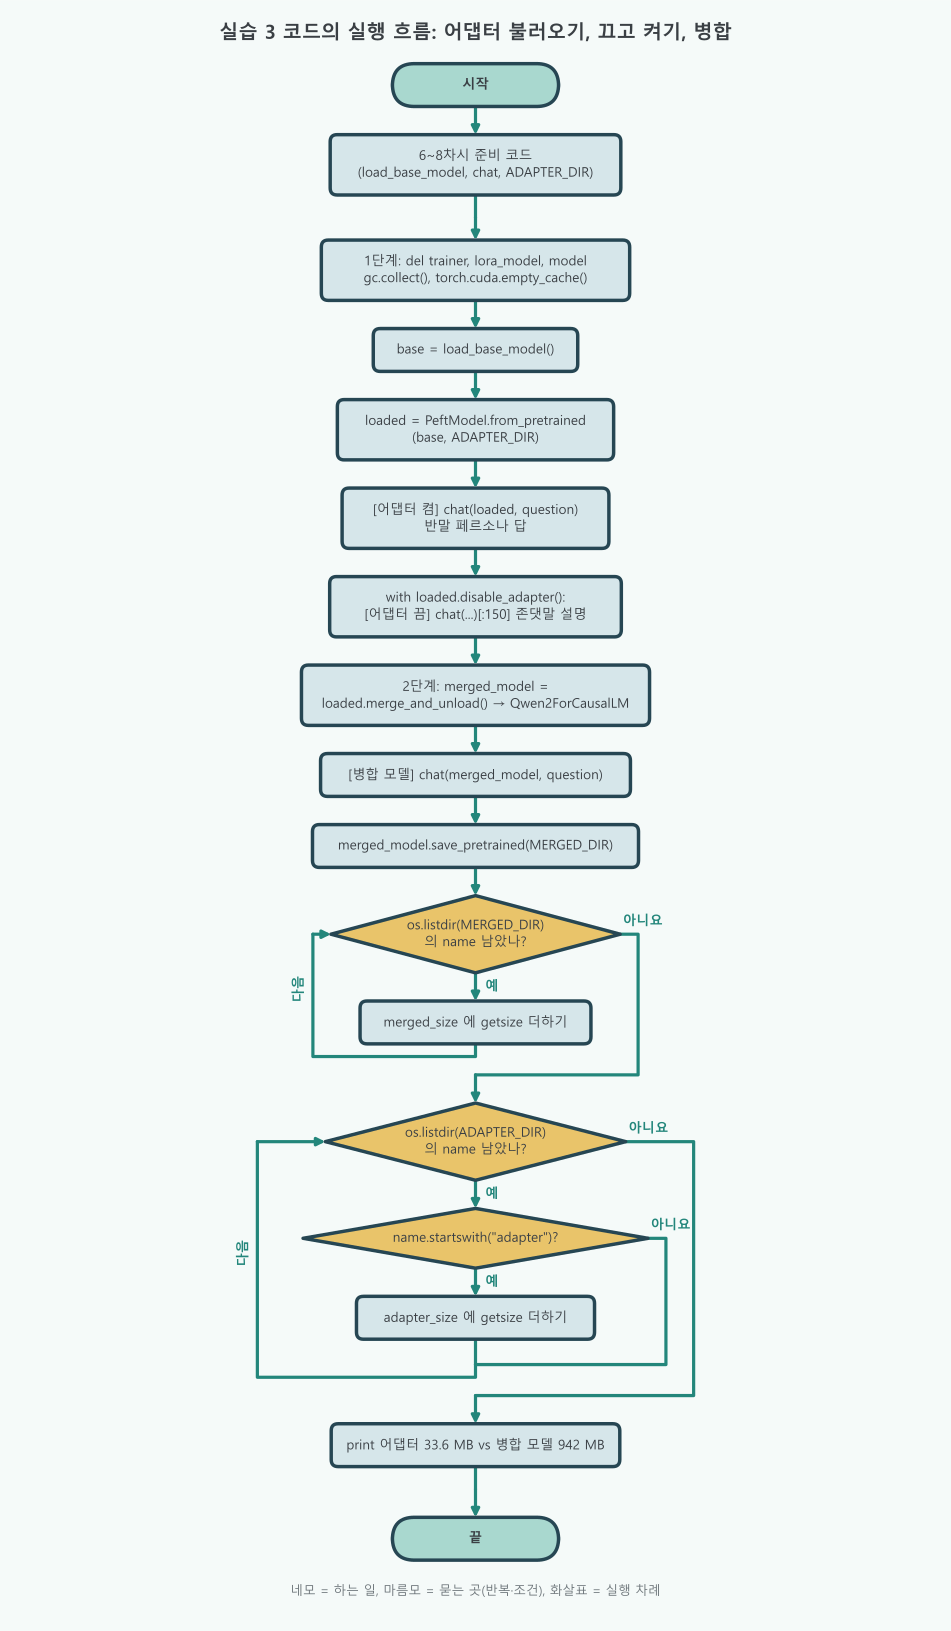
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 앞 모델을 지우고 새 기반 모델에 어댑터를 붙여 켬·끔 답 보기 | 반복 없음. with loaded.disable_adapter(): 로 잠시 끈다 | loaded = PeftModel.from_pretrained(base, ADAPTER_DIR) |
| 2 | 병합하고 저장해 크기 견주기 | os.listdir 를 두 번 돌며 크기를 더한다. 둘째는 if name.startswith("adapter") | merged_model = loaded.merge_and_unload() |
- 흐름도 읽는 법: 실습 1 과 같습니다. 2단계의 둘째 고리 안에 있는 마름모는 조건문입니다. "아니요"(토크나이저 파일 등)면 더하지 않고 다음 파일로 갑니다.
- 한 줄짜리 반복:
sum(os.path.getsize(...) for name in os.listdir(...))는 한 줄이지만 폴더의 파일마다 한 번씩 도는 반복입니다. 그래서 고리로 그렸습니다. - 차례가 중요한 까닭: 켬·끔 비교(1단계)를 병합(2단계)보다 먼저 합니다.
merge_and_unload()뒤에는 어댑터가 기반 가중치에 녹아 들어가 다시 끌 수 없기 때문입니다.
1단계. 새 기반 모델에 어댑터 붙이고 끄고 켜기
카메라 몸체를 새로 꺼내 보관해 둔 렌즈를 끼웁니다. 렌즈를 낀 사진과 뺀 사진을 견줍니다.
# 저장한 LoRA 어댑터를 새로 불러온 기반 모델에 연결합니다.
# PeftModel = PEFT(효율적 파인튜닝) 어댑터가 붙은 모델을 다루는 클래스
from peft import PeftModel  # 저장한 어댑터를 기반 모델에 붙입니다.

# 8차시의 학습 객체와 모델을 지워 GPU 메모리를 비운다(서비스에서는 처음부터 이 상태다)
del trainer, lora_model, model  # 학습에 쓴 모델 객체를 지웁니다.
# gc.collect() = garbage collect(쓰레기 수거): 이름이 지워진 객체를 실제로 정리한다
gc.collect()  # 파이썬 객체를 정리합니다.
# empty_cache = GPU 가 붙잡고 있던 빈 메모리를 돌려준다
torch.cuda.empty_cache()  # GPU 캐시도 비웁니다.

# 6차시의 load_base_model(): Qwen2.5-0.5B-Instruct 를 BF16 으로 GPU 에 올린다
base = load_base_model()  # 같은 기반 모델을 새로 불러옵니다.
# from_pretrained(기반 모델, 어댑터 폴더): 폴더의 A·B 행렬을 기반 모델의 해당 층에 붙인다
# ADAPTER_DIR = "outputs/persona-lora-adapter"(8차시에서 저장한 폴더)
loaded = PeftModel.from_pretrained(base, ADAPTER_DIR)  # 저장한 LoRA 어댑터를 붙입니다.

question = "이번 주말에 등산을 가려는데 날씨가 걱정돼."  # 어댑터 효과를 볼 새 질문입니다.
# 결과: [어댑터 켬] 날씨 걱정은 네 일요일 밥 먹는다.
print("[어댑터 켬]", chat(loaded, question))  # LoRA 적용 답변을 생성합니다.
with loaded.disable_adapter():  # 이 블록에서 어댑터를 잠시 끕니다.
    # 결과: [어댑터 끔] 죄송합니다만, 저는 인공지능으로서 ... (앞 150글자까지)
print("[어댑터 끔]", chat(loaded, question)[:150])[어댑터 켬] 날씨 걱정은 네 일요일 밥 먹는다.
[어댑터 끔] 죄송합니다만, 저는 인공지능으로서 실제의 환경과 상황에 대한 정보를 제공할 수 없습니다. 하지만 일반적으로 등산 시에는 온도와 기온, 풍속 등의 조건들이 중요하게 작용하는 것으로 알려져 있습니다.
1. 온도: 낮은 난관이나 높은 난새로 불러온 모델에서도 어댑터를 켜면 페르소나 말투("날씨 걱정은 네 일요일 밥 먹는다.")가 나오고, 끄면 원래 Qwen 의 존댓말 설명이 나옵니다. 저장한 어댑터 폴더만 있으면 학습을 다시 하지 않고도 같은 말투를 되살릴 수 있다는 뜻입니다. 0.5B 모델이라 페르소나 답의 뜻은 어색합니다. 여기서 보는 것은 말투가 바뀌는지입니다.
2단계. 어댑터를 병합하고 크기 견주기
렌즈를 몸체에 코팅해 붙입니다. 붙인 뒤의 모델 종류와 답, 저장한 파일 크기를 봅니다.
# LoRA가 학습한 변화량을 기반 모델에 합친 뒤 전체 모델을 저장합니다.
# merge_and_unload = merge(W 에 B×A 더하기) + unload(LoRA 층 떼어 내기)
merged_model = loaded.merge_and_unload()  # LoRA 변화량을 기반 가중치에 합칩니다.
# type(...).__name__: 객체의 클래스 이름. 결과: Qwen2ForCausalLM(LoRA 가 없는 일반 모델)
print("병합 후 모델 종류:", type(merged_model).__name__)
# 결과: [병합 모델] 날짜를 기다리는 게 좋겠군. 네 일은 시간의 터지기 전이다.
print("[병합 모델]", chat(merged_model, question))

MERGED_DIR = "outputs/persona-merged"  # 병합 모델을 저장할 폴더입니다.
# save_pretrained: 모델 가중치와 설정을 폴더에 저장한다. 이번에는 어댑터가 아니라 전체 모델이다
merged_model.save_pretrained(MERGED_DIR)  # 전체 가중치 모델로 저장합니다.
# os.listdir: 폴더 안 파일 이름들, os.path.getsize: 파일 하나의 바이트 수
merged_size = sum(os.path.getsize(os.path.join(MERGED_DIR, name)) for name in os.listdir(MERGED_DIR))  # 병합 모델 파일 크기를 합칩니다.
# 어댑터 폴더에서 "adapter" 로 시작하는 파일(adapter_model.safetensors, adapter_config.json)만 더한다
adapter_size = sum(os.path.getsize(os.path.join(ADAPTER_DIR, name)) for name in os.listdir(ADAPTER_DIR) if name.startswith("adapter"))  # 어댑터 파일 크기를 합칩니다.
# 1024**2 로 나눠 MB 로. 결과: 어댑터 33.6 MB vs 병합 모델 942 MB
print(f"\n어댑터 {adapter_size / 1024**2:.1f} MB vs 병합 모델 {merged_size / 1024**2:,.0f} MB")병합 후 모델 종류: Qwen2ForCausalLM
[병합 모델] 날짜를 기다리는 게 좋겠군. 네 일은 시간의 터지기 전이다.
어댑터 33.6 MB vs 병합 모델 942 MB병합한 모델은 LoRA 층이 사라진 일반 Qwen2ForCausalLM 입니다. 답의 말투는 그대로 페르소나이지만 문장이 1단계와 조금 다릅니다. BF16 으로 W + B×A 를 계산하며 생기는 아주 작은 반올림 차이 때문에, greedy 생성이 어느 지점에서 다른 토큰을 골랐기 때문입니다. 저장 크기는 어댑터 33.6MB, 병합 모델 942MB 로 약 28배 차이가 납니다. 본문에서 손으로 계산한 값과 같습니다.
이 실습이 뜻하는 것
보관해 둔 렌즈를 새 몸체에 끼워 같은 사진을 다시 찍었고(불러오기), 렌즈를 잠깐 빼 보았고(끄고 켜기), 끝으로 렌즈를 몸체에 코팅했습니다(병합). 서비스에서 어댑터를 쓰는 세 가지 방식을 모두 해 본 셈입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 켬: 반말 페르소나 / 끔: 존댓말 설명 | 어댑터 폴더만으로 말투가 되살아난다 |
| 2단계 | Qwen2ForCausalLM | 병합하면 일반 모델이 된다 |
| 2단계 | 33.6 MB 대 942 MB | 어댑터가 약 28배 작다 |
한 줄 요약: 붙여 쓰면 갈아 끼울 수 있고, 병합하면 떼어 낼 수 없는 대신 일반 모델처럼 씁니다.
코드 설명
del trainer, lora_model, model뒤의gc.collect(),torch.cuda.empty_cache()는 GPU 메모리를 실제로 비우는 짝입니다. 이름만 지워서는 메모리가 바로 돌아오지 않습니다.PeftModel.from_pretrained(base, ADAPTER_DIR)는 어댑터 폴더의adapter_config.json을 읽어target_modules에 적힌 층마다 A·B 행렬을 붙입니다.merge_and_unload()는loaded안의 기반 가중치를 직접 바꿉니다. 병합 뒤에는loaded.disable_adapter()로 원래 모델을 볼 수 없습니다.- 병합 모델 크기 942MB 는 6장의
get_memory_footprint()값(942MB)과 같습니다. BF16 가중치를 그대로 파일로 쓴 것이기 때문입니다. outputs/persona-merged폴더는 일반 Hugging Face 모델 폴더와 같은 꼴이라,AutoModelForCausalLM.from_pretrained(MERGED_DIR)로 PEFT 없이 불러올 수 있습니다.