3장. Attention과 Encoder
Encoder 블록 구성
시험공부를 하는 학생을 떠올려 봅니다. 먼저 스터디 모임에서 친구들의 설명을 듣습니다(Attention). 들은 내용을 내 원래 노트 옆에 덧붙이고(Add), 글씨 크기를 맞춰 정리합니다(Norm). 그다음 혼자 개인 과외를 받으며 각자 소화합니다(FFN). 다시 원래 노트에 덧붙이고 정리합니다. Encoder 블록 하나가 이 차례입니다.
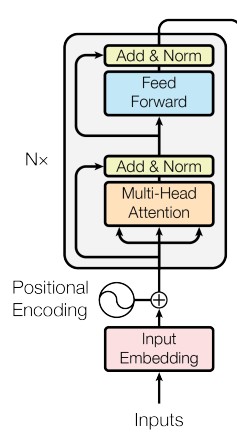
원 논문 그림에서 회색 상자가 Encoder 블록 하나이고, 옆의 N× 는 이 블록을 N 번(원 논문은 6번) 쌓는다는 뜻입니다. 화살표가 Multi-Head Attention 을 건너뛰어 Add & Norm 으로 바로 가는 선이 잔차 연결입니다. 강사자료 그림의 왼쪽은 그 선을 크게 그린 것입니다. x 가 서브층(Attention)을 거치지 않고 점선으로 건너가 f(x) 와 더해집니다. 오른쪽은 FFN 입니다. 단어 세 개가 저마다 512 → 2048 → 512 를 따로 지나고, 단어끼리 섞이지 않습니다. 그림에는 GELU 라고 적혀 있고, 원 논문은 ReLU 를 썼습니다. 둘 다 음수 쪽을 줄이는 비선형 함수입니다.
블록의 네 부품
| 부품 | 하는 일 | 공부로 치면 | 낱말 사이를 섞나 |
|---|---|---|---|
| Multi-Head Self-Attention | 낱말들이 서로 정보를 주고받는다 | 스터디 모임 | 섞는다 |
| Add (잔차 연결) | 입력을 출력에 더해 원래 정보를 지킨다 | 원래 노트 옆에 덧붙이기 | 섞지 않는다 |
| Norm (Layer Normalization) | 벡터 하나의 값을 평균 0, 표준편차 1 근처로 | 글씨 크기 맞추기 | 섞지 않는다 |
| Feed Forward Network | 낱말마다 따로 d_model → 4×d_model → d_model | 개인 과외 | 섞지 않는다 |
흐름을 한 줄로 쓰면 다음과 같습니다.
x -> Multi-Head Attention -> (x + 결과) -> LayerNorm -> FFN -> (입력 + 결과) -> LayerNorm -> 다음 블록Attention 이 "다른 낱말에서 정보를 모으는 단계"라면 FFN 은 "모은 정보를 낱말 안에서 소화하는 단계"입니다. FFN 은 512 → 2048 → 512 처럼 폭을 4배로 넓혔다 줄이므로 파라미터가 많습니다. LLM 파라미터의 약 2/3 가 FFN 에 있고, 사실 지식의 상당 부분이 FFN 에 저장된다고 알려져 있습니다.
짧은 예시
import numpy as np

x = np.array([1.0, 2.0, 3.0, 6.0])   # 낱말 하나의 벡터 (설명을 위해 정한 값)

# Layer Normalization: 평균을 빼고 표준편차로 나눈다
mean = x.mean()                       # (1 + 2 + 3 + 6) ÷ 4 = 3.0
std = x.std()                         # √3.5 ≈ 1.87
print(mean, round(std, 2))            # 결과: 3.0 1.87
print(((x - mean) / std).round(2))    # 결과: [-1.07 -0.53  0.    1.6 ]

# FFN 의 파라미터 수(원 논문): 512→2048 표 + 편향, 2048→512 표 + 편향
ffn = 512 * 2048 + 2048 + 2048 * 512 + 512
attn = 4 * 512 * 512 + 4 * 512        # W_Q, W_K, W_V, W_O 와 편향
print(ffn, attn, round(ffn / (ffn + attn), 2))
# 결과: 2099712 1050624 0.67 → 블록 하나에서 FFN 이 약 2/3
이 코드가 뜻하는 것
글씨 크기가 들쭉날쭉한 노트(1, 2, 3, 6)를 평균 0 근처로 맞춰 다시 적고, 블록 하나에서 개인 과외(FFN)와 스터디 모임(Attention)이 차지하는 몫을 견주어 본 코드입니다. 여기서 노트가 x, 맞춘 노트가 (x - mean) / std, 두 몫이 ffn, attn 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
x.mean(), x.std() | 평균과 표준편차 | pandas describe() 의 mean, std 와 같은 값(std 는 n 으로 나눈 것) |
(x - mean) / std | 표준화한다 | 눈금 맞추기 |
ffn, attn | 파라미터 수를 센다 | 부품마다 숫자 몇 개인가 |
분산을 손으로 계산하면 (1-3)² + (2-3)² + (3-3)² + (6-3)² = 4 + 1 + 0 + 9 = 14 이고 4 로 나눠 3.5 입니다. 표준편차는 √3.5 ≈ 1.87, 마지막 칸은 (6 - 3) ÷ 1.87 ≈ 1.6 입니다. 파라미터 비율 0.67 이 노트북의 "약 2/3"와 맞습니다.
주의할 점
- 원 논문은 잔차를 더한 뒤 정규화(Post-LN)했지만, 최신 LLM 은 대부분 Attention 과 FFN 에 들어가기 전에 정규화(Pre-LN)합니다. 층을 수십 개 쌓아도 학습이 안정적이기 때문입니다. 5장에서 Qwen2.5 가 어떤 방식을 쓰는지 확인합니다.
- Add & Norm 은 낱말 사이의 참고 비율을 계산하지 않습니다. 비율은 Attention 이 정하고, Add & Norm 은 원래 정보를 지키고 숫자 크기를 맞춰 여러 층의 학습을 돕습니다.
- 실제 LayerNorm 은 표준화한 뒤 학습되는 곱하기 값(γ)과 더하기 값(β)을 한 번 더 적용하고, 0 으로 나누지 않게 아주 작은 수(ε)를 더합니다.