3장. Attention과 Encoder
Query·Key·Value
도서관에서 책을 찾는 장면을 떠올려 봅니다. 검색창에 "동물이 주인공인 책"이라고 적습니다(Query). 서가의 책마다 붙은 제목표와 분류표를 훑어 검색어와 잘 맞는 책을 고릅니다(Key). 고른 책을 펴서 실제 내용을 읽습니다(Value). Self-Attention 은 낱말 하나하나가 이 세 역할을 모두 맡습니다. it 이 검색어를 내면, monkey 와 banana 는 제목표를 내밀고, 잘 맞은 monkey 의 본문이 it 에 많이 섞입니다.
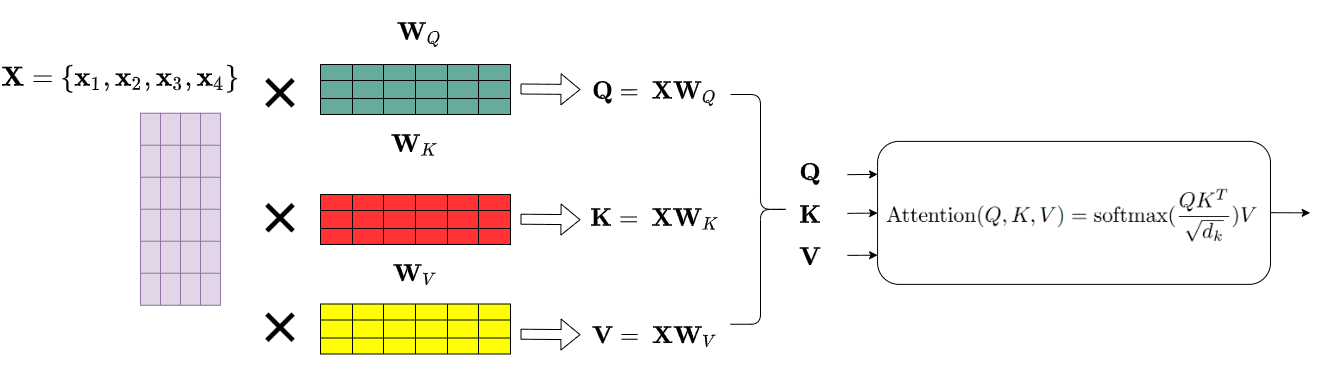
강사자료 그림의 왼쪽 보라색 표가 입력 X 입니다. 낱말 4개(x1~x4)가 한 행씩입니다. 가운데 초록, 빨강, 노랑 표가 학습되는 가중치 행렬 W_Q, W_K, W_V 입니다. 같은 X 에 서로 다른 표를 곱하므로 같은 낱말에서 세 가지 다른 벡터가 나옵니다. 오른쪽 상자의 식이 이 세 값을 받아 계산합니다. 식은 다음 절에서 봅니다.
세 역할과 it 의 예
| 벡터 | 한 줄 정의 | 도서관으로 치면 | it 문장에서 |
|---|---|---|---|
| Query (Q) | 이 낱말이 무엇을 찾고 있는가 | 검색어 | it: "내가 가리키는 명사는 어디 있지?" |
| Key (K) | 이 낱말이 어떤 정보를 가졌는가 | 제목표 | monkey: "나는 동물이고 행동의 주체다" |
| Value (V) | 이 낱말이 실제로 넘겨 줄 내용 | 책 본문 | monkey: "monkey 의 의미 정보" |
| 만드는 식 | Q = XW_Q, K = XW_K, V = XW_V | 같은 책에서 세 가지 카드 만들기 | 세 표 W_Q, W_K, W_V 가 학습 대상 |
짧은 예시
import numpy as np

# X: 낱말 3개 × 특징 2개 (설명을 위해 정한 값)
X = np.array([[1, 0],
              [0, 1],
              [1, 1]])
# W_Q: 특징 2개를 Query 2칸으로 바꾸는 표 (설명을 위해 정한 값)
W_Q = np.array([[1, 2],
                [3, 0]])
# @ 는 행렬곱. (3, 2) @ (2, 2) → (3, 2)
Q = X @ W_Q
print(Q)
# 결과:
# [[1 2]
#  [3 0]
#  [4 2]]
print(Q.shape)
# 결과: (3, 2) → 낱말 3개가 저마다 Query 벡터 하나씩
이 코드가 뜻하는 것
책 세 권(낱말 세 개)에 같은 규칙표 W_Q 를 대어 검색어 카드 세 장을 만드는 일입니다. 여기서 책이 X 의 행, 규칙표가 W_Q, 검색어 카드가 Q 의 행입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
X = np.array(...) | 낱말 3개의 특징을 행으로 둔다 | 행 3개, 열 2개짜리 DataFrame |
Q = X @ W_Q | 행렬곱으로 Query 를 만든다 | 점수표 × 가중치표로 총점 내기 |
Q.shape | 모양을 본다 | 낱말 수는 그대로, 열 수는 W_Q 가 정한다 |
셋째 낱말 [1, 1] 을 손으로 계산하면 첫째 칸은 1×1 + 1×3 = 4, 둘째 칸은 1×2 + 1×0 = 2 입니다. 출력의 마지막 행 [4 2] 와 같습니다. K 와 V 도 다른 표 W_K, W_V 로 똑같이 만듭니다.
주의할 점
- W_Q, W_K, W_V 는 사람이 정하지 않습니다. 처음에는 무작위 값이고, 학습하며 "관련 있는 낱말끼리 점수가 높게" 나오도록 바뀝니다.
- Q, K, V 의 행 수는 언제나 낱말 수와 같습니다. 열 수는 가중치 행렬이 정합니다. shape 가 맞지 않으면 NumPy 가
ValueError를 냅니다.