3장. Attention과 Encoder
Attention 흐름 다시 보기
요리사가 찌개를 끓인다고 해 봅시다. 먼저 "얼큰한 맛이 필요하다"고 정합니다(Query). 냉장고 재료의 이름표를 훑어 고춧가루와 청양고추를 고릅니다(Key 와 비교). 고른 재료를 비율대로 넣습니다(Value 섞기). 고춧가루를 많이 넣어도 다른 재료가 아예 빠지지는 않습니다. Attention 도 비율이 0.7 인 낱말만 쓰는 것이 아니라 모든 낱말의 V 를 비율대로 섞습니다.
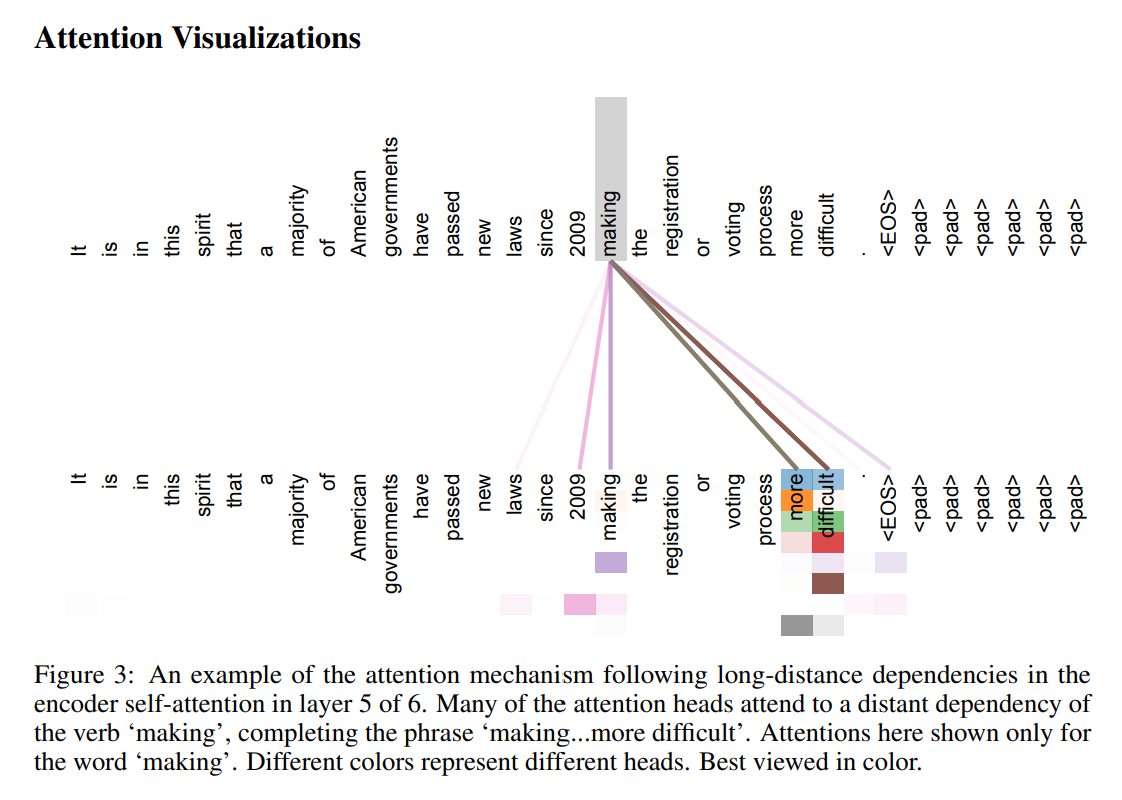
원 논문의 시각화입니다. 위 줄과 아래 줄에 같은 문장이 놓여 있고, 위의 making 에서 아래 낱말들로 선이 이어집니다. 색은 head 마다 다릅니다. 여러 head 가 멀리 떨어진 more difficult 로 선을 이어 "making ... more difficult(더 어렵게 만들다)"라는 구절을 완성합니다. 처음에는 무작위 가중치라 이런 무늬가 없지만, 학습을 거치면 문법이나 뜻으로 이어진 낱말에 가중치가 모입니다.
세 걸음 정리
| 걸음 | 맡는 벡터 | 하는 일 | 요리로 치면 |
|---|---|---|---|
| 찾기 | Query | 무엇이 필요한지 정한다 | "얼큰한 맛이 필요하다" |
| 고르기 | Key, softmax | 점수를 비율로 바꾼다 | 고춧가루 0.7, 마늘 0.2, 파 0.1 |
| 섞기 | Value | 비율대로 더한다 | 모든 재료가 비율만큼 들어간다 |
짧은 예시
노트북의 "바로 확인하기" 문제를 그대로 계산해 봅니다. 참고 비율이 장비 0.7, 작업자 0.2, 점검했다 0.1 이면 문맥 벡터에는 장비의 V 만 들어갈까요?
import numpy as np

# 설명을 위해 정한 V (특징 3개: [사물, 사람, 동작])
V = {
    "장비": np.array([1.0, 0.0, 0.0]),
    "작업자": np.array([0.0, 1.0, 0.0]),
    "점검했다": np.array([0.0, 0.0, 1.0]),
}
weights = {"장비": 0.7, "작업자": 0.2, "점검했다": 0.1}   # 합 1.0

# 비율 × V 를 모두 더한다
context = sum(weights[w] * V[w] for w in V)
print(context)
# 결과: [0.7 0.2 0.1] → 세 낱말의 V 가 모두 들어갔다
이 코드가 뜻하는 것
고춧가루를 70% 넣었다고 마늘과 파가 빠지지 않는 것처럼, 장비의 V 가 가장 크게 들어가고 작업자와 점검했다의 V 도 0.2, 0.1 만큼 들어갑니다. 여기서 재료가 V, 넣는 비율이 weights, 완성된 찌개가 context 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
V = {...} | 낱말마다 넘겨 줄 내용 | 재료 |
weights = {...} | softmax 를 거친 비율 | 재료 비율 |
sum(weights[w] * V[w] ...) | 비율대로 더한다 | 냄비에 넣고 섞기 |
주의할 점
- Attention 가중치가 큰 곳이 늘 "모델이 그렇게 판단한 까닭"은 아닙니다. 시각화는 참고용이고, 설명의 증거로 쓸 때는 조심합니다.
- head 하나의 무늬만 보고 모델 전체를 판단하지 않습니다. 같은 층에도 head 가 여러 개이고, 층마다 무늬가 다릅니다.