3장. Attention과 Encoder
프로젝트 1 — '그것'이 가리키는 낱말 찾기
공장 작업 일지를 자동으로 정리하는 프로그램을 만든다고 해 봅시다. 일지에는 "작업자가 장비를 점검한 뒤 그것을 정지했다"처럼 대명사가 자주 나옵니다. "그것"이 무엇인지 알아야 "장비 정지"라는 기록을 남길 수 있습니다. 이 프로젝트에서는 낱말마다 특징표를 정하고, Self-Attention 의 식으로 가중치표를 만들어 "그것을"이 어느 낱말을 가장 많이 참고하는지 읽습니다. 특징표와 W_Q 는 설명을 위해 정한 값입니다. 실제 모델은 이 값들을 학습으로 정합니다.
요구사항
- 문장 "작업자가 장비를 점검한 뒤 그것을 정지했다"를 낱말 6개로 나누고, 낱말마다 특징 5개([사람, 사물, 동작, 사물 가리킴, 사람 가리킴])로 된 특징표 X 를 DataFrame 으로 찍습니다.
- "사물 가리킴" 특징은 Query 에서 "사물"을 찾고, "사람 가리킴" 특징은 "사람"을 찾도록 W_Q 를 정합니다. K 와 V 는 X 를 그대로 씁니다. "그것을"의 Q 를 찍습니다.
softmax(QKᵀ / √d_k)로 6×6 가중치표를 만들어 소수 둘째 자리까지 찍고, 행 합이 1 인지 확인합니다.- "그것을" 행을 큰 순서로 정렬해 찍고, 가장 많이 참고한 낱말과 "그것을"의 새 벡터(가중치 × V)를 찍습니다.
- 같은 계산을 함수로 묶어, 대명사를 "그는"으로 바꾼 문장 "작업자가 장비를 점검한 뒤 그는 퇴근했다"에도 써 봅니다.
- 가중치표를 히트맵으로 그리고,
out_ch03_attention_table.csv로 저장합니다.
힌트
np.eye(5) * 0.5로 대각선만 0.5 인 표를 만든 뒤, 필요한 칸만W_Q[3, 1] = 4.0처럼 바꿉니다. 3번 행(사물 가리킴)의 1번 열(사물)이 "사물 가리킴이 있으면 사물을 찾아라"라는 규칙입니다.- 가중치표는
pd.DataFrame(weights, index=words, columns=words)로 감싸면df.loc["그것을"]로 한 행을 꺼낼 수 있습니다. - 정렬은
sort_values(ascending=False), 가장 큰 칸의 이름은idxmax()입니다. - 히트맵은
plt.imshow(weights)에plt.xticks(range(6), words)로 낱말을 붙입니다. 한글은plt.rcParams["font.family"] = "Malgun Gothic"로 씁니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 특징표 | 낱말 6개 × 특징 5개 표를 이름과 함께 찍는다 | 15 |
| Q, K, V | W_Q 의 규칙을 정하고 "그것을"의 Q 를 찍는다 | 20 |
| 가중치표 | √d_k 로 나누고 softmax 해 6×6 표와 행 합을 찍는다 | 25 |
| 해석 | "그것을" 행을 정렬하고 가장 많이 참고한 낱말과 새 벡터를 찍는다 | 20 |
| 일반화와 저장 | 함수로 "그는" 문장에도 쓰고, 히트맵과 csv 를 남긴다 | 20 |
코드의 흐름
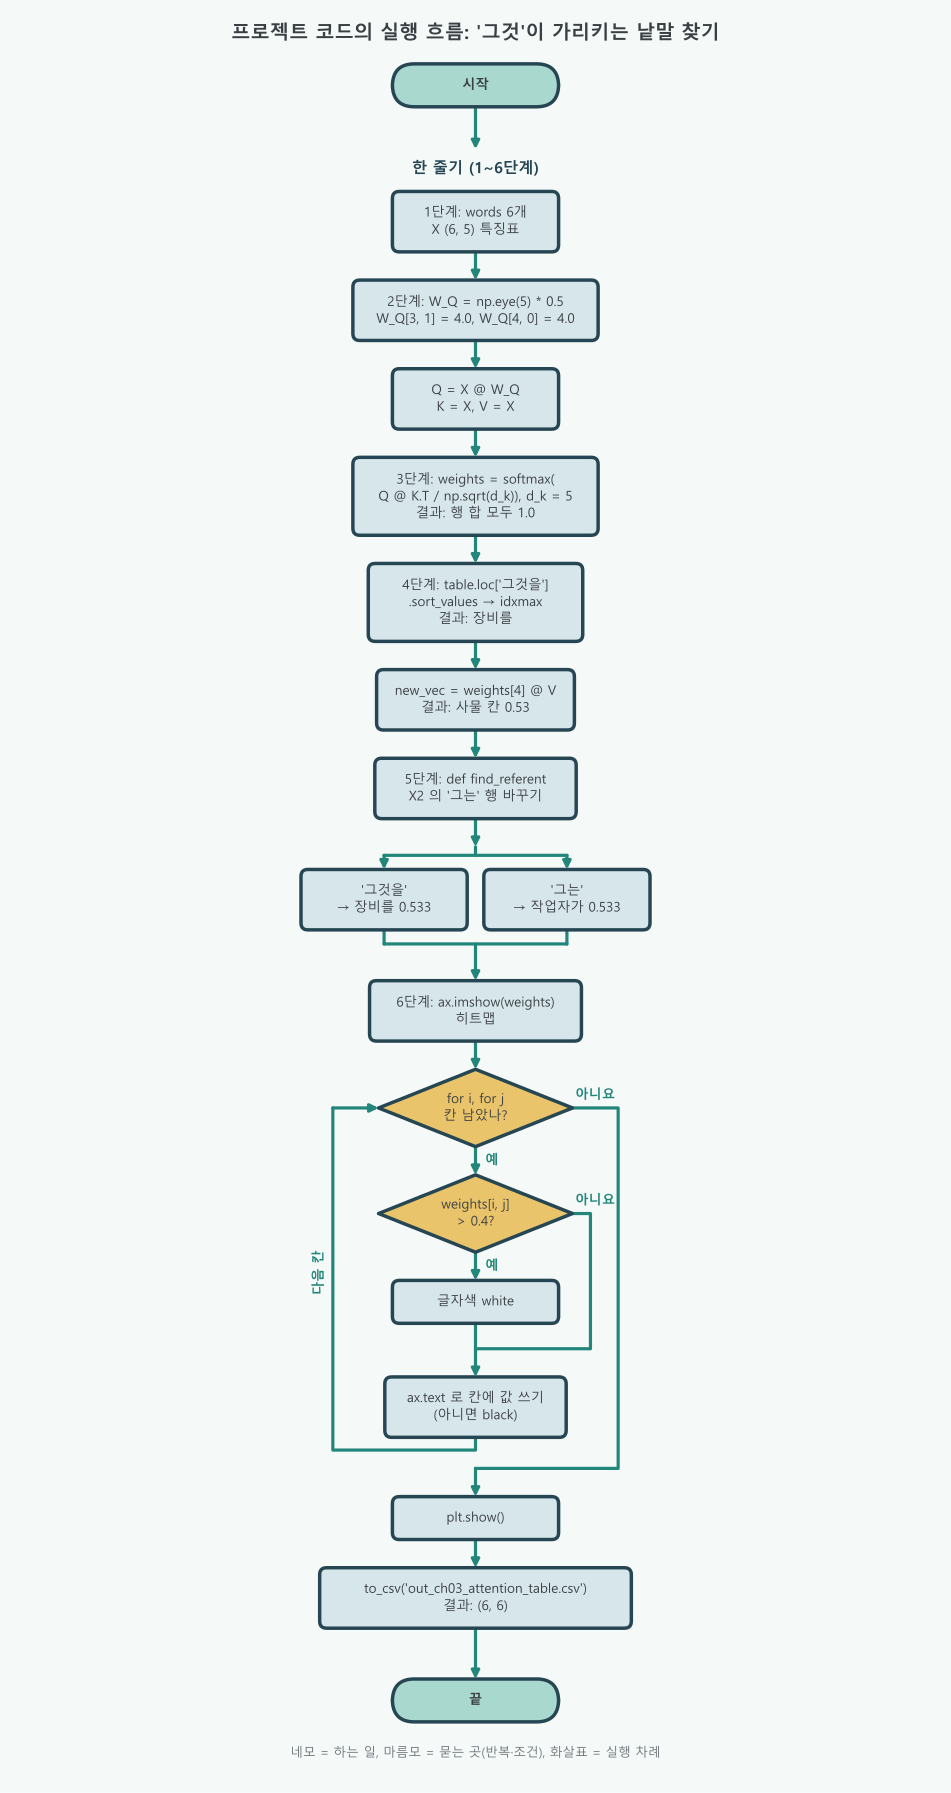
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 낱말 6개 × 특징 5개 특징표 만들기 | 없음 | X = np.array([...]) |
| 2 | 규칙을 넣은 W_Q 로 Q 만들기, K 와 V 는 X 그대로 | 없음 | W_Q[3, 1] = 4.0 |
| 3 | 6×6 가중치표 만들기 | 없음 | weights = softmax(Q @ K.T / np.sqrt(d_k)) |
| 4 | "그것을" 행을 정렬해 가장 많이 참고한 낱말 읽기 | 없음 | table.loc["그것을"].sort_values(ascending=False) |
| 5 | 함수로 묶어 "그는" 문장에도 쓰기 | 없음 | find_referent(words2, X2, "그는") |
| 6 | 히트맵에 칸마다 값을 쓰고 csv 로 저장 | 6×6 칸을 도는 이중 반복(for i, for j) 안에 "0.4 보다 큰가?" 조건 | color="white" if weights[i, j] > 0.4 else "black" |
- 조건이 든 반복: 6단계의 바깥 마름모(칸 남았나?) 안에 작은 마름모(0.4 보다 큰가?)가 있습니다. 짙은 칸이면 "예"로 내려가 흰 글자를, 옅은 칸이면 "아니요"로 건너뛰어 검은 글자를 씁니다. 짙은 바탕에 검은 글자가 묻히지 않게 하는 장치입니다.
- 나란한 두 네모: 5단계는 같은
find_referent를 "그것을" 문장과 "그는" 문장에 한 번씩 부릅니다. 둘 다 0.533 으로 각각 장비를, 작업자가를 가리킵니다. - 짜임: 1~4단계가 실습 1의 Self-Attention 계산과 같은 차례이고, 5~6단계는 같은 계산을 다른 문장에 쓰고 결과를 남기는 마무리입니다.
결과 보기 (예시 풀이)
1단계. 문장과 특징표 정하기
import numpy as np
import pandas as pd

# 낱말 6개
words = ["작업자가", "장비를", "점검한", "뒤", "그것을", "정지했다"]
features = ["사람", "사물", "동작", "사물 가리킴", "사람 가리킴"]

# 특징표 X (설명을 위해 정한 값): 1 이면 그 성질이 있다
X = np.array([
    [1.0, 0.0, 0.0, 0.0, 0.0],   # 작업자가: 사람
    [0.0, 1.0, 0.0, 0.0, 0.0],   # 장비를: 사물
    [0.0, 0.0, 1.0, 0.0, 0.0],   # 점검한: 동작
    [0.0, 0.0, 0.3, 0.0, 0.0],   # 뒤: 동작의 차례를 조금 나타냄
    [0.0, 0.0, 0.0, 1.0, 0.0],   # 그것을: 사물을 가리키는 말
    [0.0, 0.0, 1.0, 0.0, 0.0],   # 정지했다: 동작
])
print(pd.DataFrame(X, index=words, columns=features))
# 결과: 6행 5열 특징표 사람 사물 동작 사물 가리킴 사람 가리킴
작업자가 1.0 0.0 0.0 0.0 0.0
장비를 0.0 1.0 0.0 0.0 0.0
점검한 0.0 0.0 1.0 0.0 0.0
뒤 0.0 0.0 0.3 0.0 0.0
그것을 0.0 0.0 0.0 1.0 0.0
정지했다 0.0 0.0 1.0 0.0 0.02단계. 규칙표 W_Q 로 Q, K, V 만들기
# W_Q: 기본은 "자기 특징과 같은 것을 조금 찾는다"(대각선 0.5)
W_Q = np.eye(5) * 0.5
W_Q[3, 1] = 4.0   # 사물 가리킴(3번) → 사물(1번)을 강하게 찾는다
W_Q[4, 0] = 4.0   # 사람 가리킴(4번) → 사람(0번)을 강하게 찾는다

Q = X @ W_Q       # (6, 5) @ (5, 5) → (6, 5)
K = X             # 이름표는 특징 그대로
V = X             # 넘겨 줄 내용도 특징 그대로

print("'그것을' 의 Q:", dict(zip(features, Q[4])))
# 결과: 사물 칸이 4.0, 사물 가리킴 칸이 0.5 → "사물인 낱말을 찾는다"'그것을' 의 Q: {'사람': 0.0, '사물': 4.0, '동작': 0.0, '사물 가리킴': 0.5, '사람 가리킴': 0.0}3단계. Attention 가중치표 만들기
def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

d_k = K.shape[1]                                   # 5
weights = softmax(Q @ K.T / np.sqrt(d_k))          # (6, 6), √5 ≈ 2.24 로 나눈다
table = pd.DataFrame(weights, index=words, columns=words)

print(table.round(2))
print("행 합:", table.sum(axis=1).round(3).tolist())
# 결과: 6×6 비율 표, 행 합은 모두 1.0 작업자가 장비를 점검한 뒤 그것을 정지했다
작업자가 0.20 0.16 0.16 0.16 0.16 0.16
장비를 0.16 0.20 0.16 0.16 0.16 0.16
점검한 0.15 0.15 0.19 0.16 0.15 0.19
뒤 0.16 0.16 0.17 0.17 0.16 0.17
그것을 0.09 0.53 0.09 0.09 0.11 0.09
정지했다 0.15 0.15 0.19 0.16 0.15 0.19
행 합: [1.0, 1.0, 1.0, 1.0, 1.0, 1.0]4단계. '그것을' 행 읽기
row = table.loc["그것을"].sort_values(ascending=False)   # 큰 순서로
print(row.round(3))
print("가장 많이 참고한 낱말:", row.idxmax())
# 결과: 장비를

# '그것을' 의 새 벡터 = 가중치 × V
new_vec = weights[4] @ V
print("새 벡터:", dict(zip(features, new_vec.round(2))))
# 결과: 사물 칸이 0 → 0.53 으로 커졌다 → '그것을' 에 장비 정보가 섞였다장비를 0.533
그것을 0.111
작업자가 0.089
점검한 0.089
뒤 0.089
정지했다 0.089
Name: 그것을, dtype: float64
가장 많이 참고한 낱말: 장비를
새 벡터: {'사람': 0.09, '사물': 0.53, '동작': 0.2, '사물 가리킴': 0.11, '사람 가리킴': 0.0}"그것을" 행을 손으로 계산해 봅니다. "그것을"의 Q 는 사물 칸 4.0, 사물 가리킴 칸 0.5 입니다. "장비를"의 K 는 사물 칸만 1 이므로 내적은 4.0, √5 ≈ 2.24 로 나누면 1.79 입니다. 자기 자신과는 0.5 ÷ 2.24 ≈ 0.22, 나머지 네 낱말과는 0 입니다. e^1.79 ≈ 5.98, e^0.22 ≈ 1.25, e^0 = 1 이 넷이므로 합은 11.23 입니다. 비율은 5.98 ÷ 11.23 ≈ 0.533, 1.25 ÷ 11.23 ≈ 0.111, 1 ÷ 11.23 ≈ 0.089 로 출력과 같습니다. 새 벡터의 사물 칸이 0 에서 0.53 으로 커졌습니다.
5단계. 함수로 묶어 다른 문장에 쓰기
def find_referent(words, X, pronoun):
    # 특징표 X 로 가중치표를 만들고, pronoun 행에서 자기 자신을 뺀 가장 큰 낱말을 돌려준다
    Q, K = X @ W_Q, X
    w = pd.DataFrame(softmax(Q @ K.T / np.sqrt(K.shape[1])), index=words, columns=words)
    r = w.loc[pronoun].drop(pronoun)
    return r.idxmax(), round(float(r.max()), 3)

words2 = ["작업자가", "장비를", "점검한", "뒤", "그는", "퇴근했다"]
X2 = X.copy()
X2[4] = [0.0, 0.0, 0.0, 0.0, 1.0]   # 그는: 사람을 가리키는 말

print("그것을 →", find_referent(words, X, "그것을"))
print("그는   →", find_referent(words2, X2, "그는"))
# 결과: 그것을 → ('장비를', 0.533), 그는 → ('작업자가', 0.533)그것을 → ('장비를', 0.533)
그는 → ('작업자가', 0.533)6단계. 히트맵과 csv 로 남기기
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"   # 한글 글꼴
plt.rcParams["axes.unicode_minus"] = False

fig, ax = plt.subplots(figsize=(6, 4.8))
im = ax.imshow(weights, cmap="YlGnBu")           # 칸이 진할수록 많이 참고
ax.set_xticks(range(6), words, rotation=30)
ax.set_yticks(range(6), words)
ax.set_xlabel("Key(참고되는 낱말)")
ax.set_ylabel("Query(참고하는 낱말)")
# 칸마다 숫자를 적는다
for i in range(6):
    for j in range(6):
        # 짙은 칸(0.4 넘음)은 흰 글자, 나머지는 검은 글자
        ax.text(j, i, f"{weights[i, j]:.2f}", ha="center", va="center", fontsize=8,
                color="white" if weights[i, j] > 0.4 else "black")
fig.colorbar(im)
ax.set_title("'그것을' 이 가리키는 낱말 찾기")
plt.tight_layout()
plt.show()

table.round(4).to_csv("out_ch03_attention_table.csv", encoding="utf-8-sig")
print("저장: out_ch03_attention_table.csv", table.shape)
# 결과: 저장: out_ch03_attention_table.csv (6, 6)저장: out_ch03_attention_table.csv (6, 6)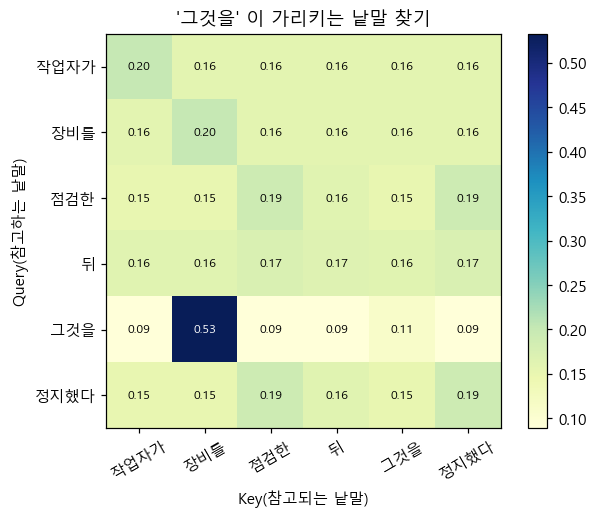
이 풀이에서 "그것을"이 "장비를"을 가장 많이 참고한 것은 W_Q 에 "사물 가리킴이면 사물을 찾아라"라는 규칙을 손으로 넣었기 때문입니다. 실제 Transformer 는 이런 규칙을 사람이 넣지 않습니다. 수많은 문장으로 학습하는 동안 W_Q, W_K, W_V 가 스스로 비슷한 규칙을 익히고, 그 규칙이 head 가운데 일부에 나타납니다. 이 프로젝트는 그 결과를 작은 숫자로 미리 들여다본 것입니다.