3장. Attention과 Encoder
실습 4 — Add & Norm 과 FFN 으로 Encoder 블록 완성하기
실습 3의 Multi-Head Attention 에 Add & Norm 과 FFN 을 붙여 Encoder 블록 하나를 함수로 만들고, 두 층을 쌓아 봅니다. 원본 노트북에는 코드가 없어 새로 쓴 코드입니다. 이 실습은 혼자서도 돌도록 필요한 함수를 처음부터 다시 정의합니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다.
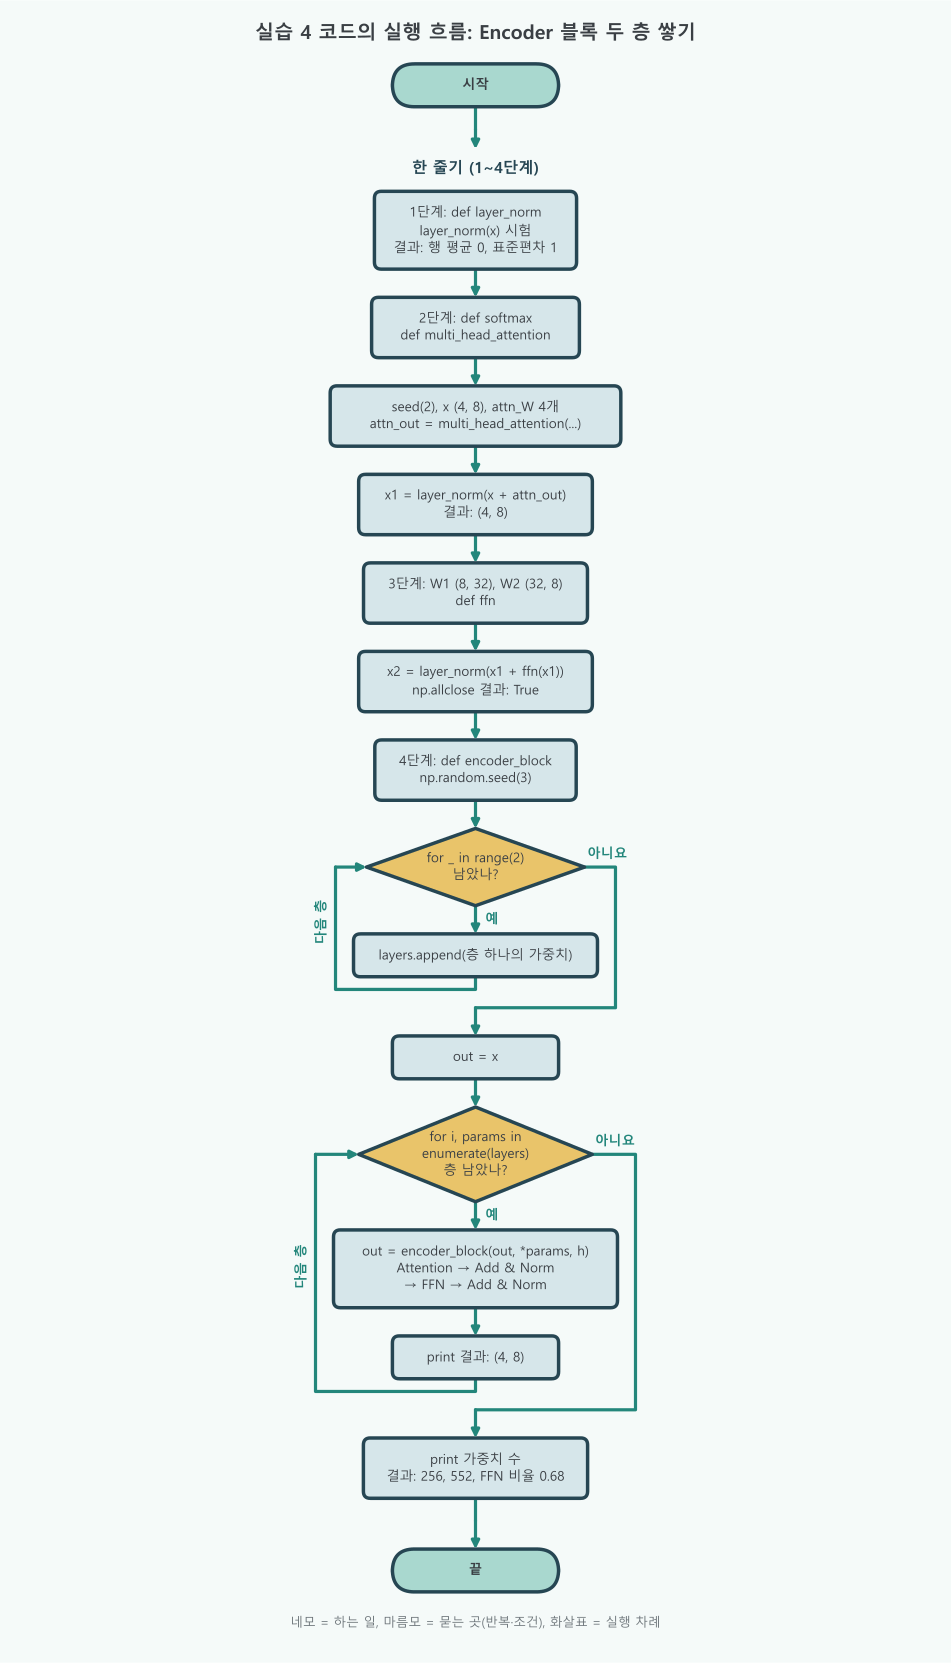
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 낱말마다 눈금을 맞추는 함수 만들고 시험 | 없음 | (x - mean) / (std + eps) |
| 2 | Multi-Head Attention 뒤 첫 번째 Add & Norm | 없음 | x1 = layer_norm(x + attn_out) |
| 3 | FFN 뒤 두 번째 Add & Norm | 없음 | x2 = layer_norm(x1 + ffn(x1)) |
| 4 | 블록 함수로 묶어 두 층 쌓기 | 반복 두 번: 층 2개의 가중치 만들기(for _ in range(2)) → 층마다 통과시키기(for i, params in enumerate(layers)) | out = encoder_block(out, *params, h) |
- 반복 두 개: 4단계의 첫 마름모는 층마다 쓸 가중치 묶음을
layers에 쌓고, 둘째 마름모는 그 묶음을 하나씩 꺼내out을 블록에 통과시킵니다. 둘째 반복에서 앞 층의 출력이 다음 층의 입력이 되는 것이 "쌓기"입니다. - 정의와 실행:
def layer_norm,def multi_head_attention,def ffn,def encoder_block은 요리법을 적어 두기만 하고, 계산은 그 아래 줄에서 부를 때 합니다. - 블록 안의 차례: 둘째 반복 안의 네모에 적은 "Attention → Add & Norm → FFN → Add & Norm" 이 2~3단계를 한 함수로 묶은 것입니다. 들어간 (4, 8) 이 그대로 나오므로 몇 층이든 쌓을 수 있습니다.
1단계. Layer Normalization 만들기
낱말마다 노트의 글씨 크기를 맞추는 함수를 만듭니다.
import numpy as np

np.set_printoptions(precision=2, suppress=True)

def layer_norm(x, eps=1e-5):
    # 낱말(행)마다 평균과 표준편차를 구한다
    mean = x.mean(axis=-1, keepdims=True)
    std = x.std(axis=-1, keepdims=True)
    # eps: 표준편차가 0 일 때 0 으로 나누지 않게 더하는 아주 작은 수
    return (x - mean) / (std + eps)

x = np.array([[1.0, 2.0, 3.0, 6.0],
              [10.0, 20.0, 30.0, 60.0]])   # 둘째 줄은 첫째 줄의 10배
y = layer_norm(x)
print(y)
# 결과: 두 줄이 거의 같다 → 크기(눈금)가 달라도 같은 꼴로 맞춘다
print("행 평균:", y.mean(axis=1).round(2), " 행 표준편차:", y.std(axis=1).round(2))
# 결과: 행 평균: [0. 0.] 행 표준편차: [1. 1.][[-1.07 -0.53 0. 1.6 ]
[-1.07 -0.53 0. 1.6 ]]
행 평균: [0. 0.] 행 표준편차: [1. 1.]2단계. Multi-Head Attention 과 첫 번째 Add & Norm
스터디 모임(Attention)의 결과를 원래 노트(x)에 더하고 눈금을 맞춥니다.
def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

def multi_head_attention(x, W_Q, W_K, W_V, W_O, h):
    n, d_model = x.shape
    d_head = d_model // h
    # 실습 3과 같은 계산: 나누기 → head 별 Attention → 이어 붙이기 → W_O
    split = lambda M: M.reshape(n, h, d_head).transpose(1, 0, 2)
    Qh, Kh, Vh = split(x @ W_Q), split(x @ W_K), split(x @ W_V)
    weights = softmax(Qh @ Kh.transpose(0, 2, 1) / np.sqrt(d_head))
    concat = (weights @ Vh).transpose(1, 0, 2).reshape(n, d_model)
    return concat @ W_O

np.random.seed(2)
n, d_model, h = 4, 8, 2
x = np.random.randn(n, d_model)                     # 입력 (4, 8)
attn_W = [np.random.randn(d_model, d_model) * 0.5 for _ in range(4)]   # W_Q, W_K, W_V, W_O

attn_out = multi_head_attention(x, *attn_W, h)      # (4, 8)
x1 = layer_norm(x + attn_out)                       # Add(잔차) 뒤 Norm
print("attn_out:", attn_out.shape, " x1:", x1.shape)
# 결과: attn_out: (4, 8)  x1: (4, 8)
print("x1 첫 낱말:", x1[0])attn_out: (4, 8) x1: (4, 8)
x1 첫 낱말: [-0.82 -0.19 0.16 0.46 -1.67 -0.58 1.8 0.83]3단계. FFN 과 두 번째 Add & Norm
낱말마다 따로 개인 과외(FFN)를 받고, 다시 원래 노트에 더해 눈금을 맞춥니다.
d_ff = 4 * d_model                     # 넓힐 폭 = 32 (원 논문 512 → 2048 과 같은 4배)
W1 = np.random.randn(d_model, d_ff) * 0.3
b1 = np.zeros(d_ff)                    # 편향(bias): 더하는 값. 처음엔 0
W2 = np.random.randn(d_ff, d_model) * 0.3
b2 = np.zeros(d_model)

def ffn(x):
    # 8 → 32 로 넓히고, ReLU(음수는 0) 로 비선형을 준 뒤, 32 → 8 로 줄인다
    hidden = np.maximum(0, x @ W1 + b1)
    return hidden @ W2 + b2

x2 = layer_norm(x1 + ffn(x1))          # Add(잔차) 뒤 Norm
print("x2:", x2.shape)
# 결과: x2: (4, 8)

# FFN 은 낱말마다 따로: 한 줄만 넣은 결과와 네 줄을 한꺼번에 넣은 결과의 그 줄이 같다
print("낱말마다 따로 계산되는가:", np.allclose(ffn(x1[2:3]), ffn(x1)[2:3]))
# 결과: Truex2: (4, 8)
낱말마다 따로 계산되는가: True4단계. 블록 함수로 묶어 두 층 쌓기
지금까지의 차례를 함수 하나(블록 하나)로 묶고, 같은 모양의 블록을 두 번 통과시킵니다.
def encoder_block(x, attn_W, W1, b1, W2, b2, h):
    # 1) Multi-Head Attention → Add & Norm
    x = layer_norm(x + multi_head_attention(x, *attn_W, h))
    # 2) FFN → Add & Norm
    hidden = np.maximum(0, x @ W1 + b1)
    x = layer_norm(x + hidden @ W2 + b2)
    return x

# 층마다 가중치를 따로 만든다(실제 모델도 층마다 다른 가중치)
np.random.seed(3)
layers = []
for _ in range(2):
    layers.append(([np.random.randn(d_model, d_model) * 0.5 for _ in range(4)],
                   np.random.randn(d_model, d_ff) * 0.3, np.zeros(d_ff),
                   np.random.randn(d_ff, d_model) * 0.3, np.zeros(d_model)))

out = x
for i, params in enumerate(layers):
    out = encoder_block(out, *params, h)
    print(f"{i + 1}층 통과 뒤 shape:", out.shape)
# 결과: 1층, 2층 모두 (4, 8) → 모양이 같아 몇 층이든 쌓을 수 있다

# 블록 하나의 파라미터 수
attn_params = 4 * d_model * d_model                       # 256
ffn_params = d_model * d_ff + d_ff + d_ff * d_model + d_model   # 552
print("Attention:", attn_params, " FFN:", ffn_params, " FFN 비율:", round(ffn_params / (attn_params + ffn_params), 2))
# 결과: Attention: 256 FFN: 552 FFN 비율: 0.68 → 블록의 약 2/31층 통과 뒤 shape: (4, 8)
2층 통과 뒤 shape: (4, 8)
Attention: 256 FFN: 552 FFN 비율: 0.68이 실습이 뜻하는 것
노트의 눈금을 맞추는 도구를 만들고(1단계), 스터디 모임 결과를 원래 노트에 더해 정리한 뒤(2단계), 개인 과외로 낱말마다 소화하고 다시 정리해(3단계), 이 차례를 블록 하나로 묶어 두 번 반복한(4단계) 과정입니다. 여기서 원래 노트가 x, 스터디 모임이 multi_head_attention, 개인 과외가 ffn, 눈금 맞추기가 layer_norm 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. LayerNorm | 행 평균 0, 표준편차 1 | 크기가 10배 달라도 같은 꼴 |
| 2. Attention + Add & Norm | x1: (4, 8) | 낱말끼리 정보를 주고받음 |
| 3. FFN + Add & Norm | x2: (4, 8), True | 낱말마다 따로 가공 |
| 4. 두 층 쌓기 | 1층, 2층 모두 (4, 8), FFN 비율 0.68 | 모양이 같아 계속 쌓을 수 있음 |
한 줄로 줄이면, Encoder 블록은 "주고받기 → 더하고 맞추기 → 따로 소화 → 더하고 맞추기"이고, 들어간 모양 그대로 나와 N 층을 쌓습니다.
코드 설명
layer_norm은axis=-1(낱말 하나의 칸들)로 평균과 표준편차를 냅니다. 낱말끼리 섞지 않고 한 줄씩 맞춥니다.x + attn_out의+가 잔차 연결(Add)입니다. 원래 x 가 그대로 더해지므로 Attention 이 정보를 망쳐도 원본이 남습니다.np.maximum(0, ...)이 ReLU 입니다. 음수를 0 으로 바꿔 직선 두 개를 이은 꺾인 함수가 되게 합니다. 이 꺾임이 없으면 W1, W2 두 번 곱한 것이 행렬 하나와 다를 바 없습니다.- 3단계의
np.allclose가 True 인 것은 FFN 이 낱말 사이를 섞지 않는다는 확인입니다. 낱말 사이를 섞는 것은 Attention 뿐입니다. - 이 블록은 원 논문의 Post-LN 차례입니다. Pre-LN 으로 바꾸려면
x + 서브층(layer_norm(x))꼴로 정규화를 앞에 둡니다.