3장. Attention과 Encoder
실습 3 — Multi-Head 로 나누고 합치기
낱말 4개, d_model 8 인 입력을 head 2개로 나눠 Attention 을 따로 계산하고, 이어 붙인 뒤 W_O 로 섞습니다. 원본 노트북에는 코드가 없어 새로 쓴 코드입니다. 가중치는 np.random.seed(1) 로 만든 무작위 값입니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다.
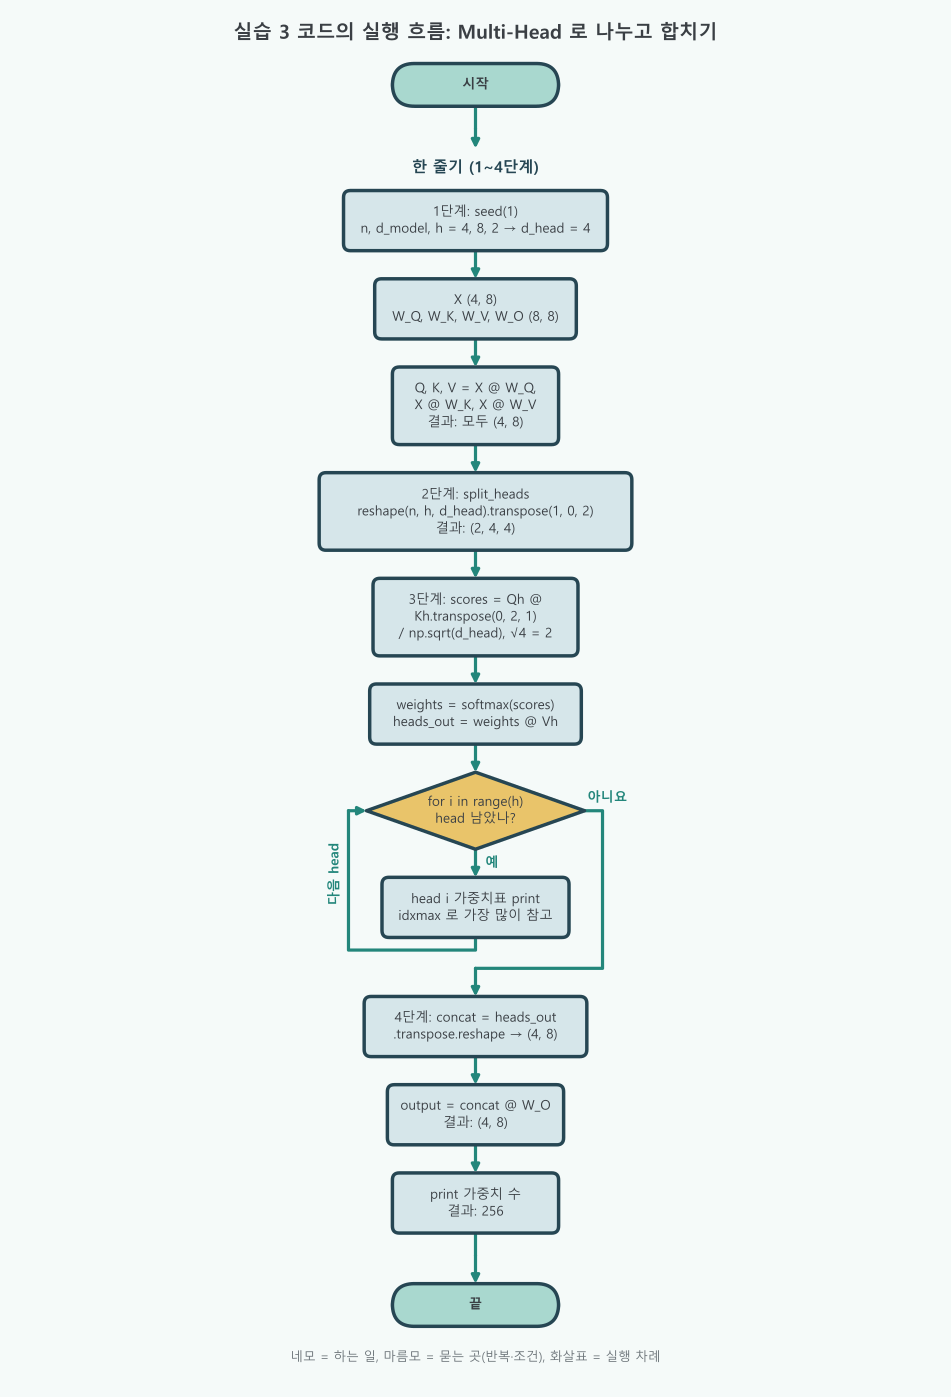
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 입력 X 와 규칙표 네 장 만들고 Q, K, V 계산 | 없음(규칙표 네 장은 for _ in range(4) 로 한 줄에 만든다) | Q, K, V = X @ W_Q, X @ W_K, X @ W_V |
| 2 | 8칸을 4칸씩 두 head 로 나누기 | 없음 | M.reshape(n, h, d_head).transpose(1, 0, 2) |
| 3 | head 마다 가중치표 만들고 찍기 | head 2개를 하나씩 도는 반복(for i in range(h)), 찍기만 반복한다 | weights = softmax(scores) |
| 4 | 이어 붙이고 W_O 로 섞기 | 없음 | output = concat @ W_O |
- 반복은 찍을 때만: 3단계의 계산
Qh @ Kh.transpose(0, 2, 1)은 3차원 배열의@라서 두 head 를 한꺼번에 계산합니다. 마름모 "head 남았나?"의 반복은 계산이 끝난 표를 head 마다 하나씩 찍을 뿐입니다. - 모양의 흐름: 네모에 적은 shape 를 따라가면 (4, 8) → (2, 4, 4) → (4, 8) 입니다. 나눴다가 다시 붙여 들어간 모양 그대로 나옵니다.
- 끝부분: 가중치 수 256 은
4 * d_model * d_model로, head 수와 상관이 없습니다.
1단계. 입력과 가중치 준비하기
회의 자료(X)와, 전문가들이 함께 쓸 규칙표 네 장(W_Q, W_K, W_V, W_O)을 준비합니다.
import numpy as np
import pandas as pd

np.set_printoptions(precision=2, suppress=True)
np.random.seed(1)

words = ["나는", "학교에", "버스로", "갔다"]
n, d_model, h = 4, 8, 2          # 낱말 4개, 벡터 폭 8, head 2개
d_head = d_model // h            # head 하나의 폭 = 8 ÷ 2 = 4

X = np.random.randn(n, d_model)  # 입력 (4, 8): 무작위 값으로 대신한다
# 가중치 네 장: 모두 (8, 8). × 0.5 로 값을 작게
W_Q, W_K, W_V, W_O = (np.random.randn(d_model, d_model) * 0.5 for _ in range(4))

Q, K, V = X @ W_Q, X @ W_K, X @ W_V
print("X:", X.shape, " Q, K, V:", Q.shape, K.shape, V.shape)
# 결과: X: (4, 8)  Q, K, V: (4, 8) (4, 8) (4, 8)
print("head 수:", h, " head 하나의 폭:", d_head)
# 결과: head 수: 2 head 하나의 폭: 4X: (4, 8) Q, K, V: (4, 8) (4, 8) (4, 8)
head 수: 2 head 하나의 폭: 42단계. head 마다 조각 나누기
8칸짜리 자료를 4칸씩 두 전문가에게 나눠 줍니다.
def split_heads(M):
    # (낱말, d_model) → (낱말, h, d_head) → (h, 낱말, d_head)
    return M.reshape(n, h, d_head).transpose(1, 0, 2)

Qh, Kh, Vh = split_heads(Q), split_heads(K), split_heads(V)
print("나눈 Q:", Qh.shape)
# 결과: 나눈 Q: (2, 4, 4) → head 2개, 낱말 4개, 칸 4개
print("head 0 이 받은 '나는' 의 Q:", Qh[0, 0])
print("Q 의 '나는' 앞 4칸     :", Q[0, :4])
# 결과: 두 줄이 같다 → head 0 은 앞 4칸, head 1 은 뒤 4칸을 맡는다나눈 Q: (2, 4, 4)
head 0 이 받은 '나는' 의 Q: [-1.19 -2.72 -0.72 2.36]
Q 의 '나는' 앞 4칸 : [-1.19 -2.72 -0.72 2.36]3단계. head 마다 Attention 계산하기
두 전문가가 각자 자기 몫으로 가중치표를 만듭니다. 같은 문장인데 표의 무늬가 다릅니다.
def softmax(x):
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)

# Kh.transpose(0, 2, 1): head 마다 K 를 전치 (2, 4, 4) → (2, 4, 4)
# (2, 4, 4) @ (2, 4, 4) → head 마다 점수표 (4, 4)
scores = Qh @ Kh.transpose(0, 2, 1) / np.sqrt(d_head)   # √4 = 2 로 나눈다
weights = softmax(scores)                               # (2, 4, 4)
heads_out = weights @ Vh                                # (2, 4, 4)

for i in range(h):
    table = pd.DataFrame(weights[i].round(2), index=words, columns=words)
    print(f"--- head {i} 가중치표 ---")
    print(table)
    print("가장 많이 참고:", table.idxmax(axis=1).to_dict())
# 결과: head 마다 다른 가중치표. '나는' 은 head 0 에서 버스로, head 1 에서 학교에를 가장 많이 참고--- head 0 가중치표 ---
나는 학교에 버스로 갔다
나는 0.13 0.04 0.57 0.26
학교에 0.12 0.69 0.01 0.18
버스로 0.16 0.71 0.02 0.11
갔다 0.08 0.80 0.01 0.11
가장 많이 참고: {'나는': '버스로', '학교에': '학교에', '버스로': '학교에', '갔다': '학교에'}
--- head 1 가중치표 ---
나는 학교에 버스로 갔다
나는 0.05 0.89 0.03 0.03
학교에 0.06 0.49 0.10 0.34
버스로 0.56 0.01 0.34 0.10
갔다 0.22 0.09 0.46 0.22
가장 많이 참고: {'나는': '학교에', '학교에': '학교에', '버스로': '나는', '갔다': '버스로'}같은 문장인데 두 head 의 표가 다릅니다. "나는" 행을 보면 head 0 은 "버스로"를 0.57, head 1 은 "학교에"를 0.89 만큼 참고합니다. 지금은 무작위 W 라 어느 쪽에도 뜻은 없지만, 학습된 모델에서는 이렇게 head 마다 다른 관계(주어와 동사, 대명사와 대상, 바로 옆 낱말)를 맡습니다.
4단계. 이어 붙이고 W_O 로 섞기
두 전문가의 의견을 회의록에 나란히 적고(Concat), 팀장이 하나로 정리합니다(W_O).
# (2, 4, 4) → (4, 2, 4) → (4, 8): head 결과를 옆으로 이어 붙인다
concat = heads_out.transpose(1, 0, 2).reshape(n, d_model)
output = concat @ W_O            # (4, 8) @ (8, 8) → (4, 8)

print("head 출력:", heads_out.shape, "→ Concat:", concat.shape, "→ W_O 뒤:", output.shape)
# 결과: head 출력: (2, 4, 4) → Concat: (4, 8) → W_O 뒤: (4, 8)

# 파라미터 수: W_Q, W_K, W_V, W_O 네 장 × 8 × 8
print("Multi-Head 가중치 수:", 4 * d_model * d_model)
# 결과: Multi-Head 가중치 수: 256 → head 를 몇 개로 나누든 같다head 출력: (2, 4, 4) → Concat: (4, 8) → W_O 뒤: (4, 8)
Multi-Head 가중치 수: 256이 실습이 뜻하는 것
회의 자료를 두 전문가에게 반씩 나눠 주고(1~2단계), 전문가마다 따로 의견(가중치표)을 내게 한 뒤(3단계), 회의록에 나란히 적어 팀장이 하나로 정리한(4단계) 과정입니다. 여기서 전문가가 head, 각자의 몫이 Qh[i], Kh[i], Vh[i], 회의록이 concat, 팀장이 W_O 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | Q, K, V 모두 (4, 8) | head 로 나누기 전 |
| 2. 나누기 | (2, 4, 4) | head 0 은 앞 4칸, head 1 은 뒤 4칸 |
| 3. head 별 Attention | "나는" 행: head 0 은 버스로 0.57, head 1 은 학교에 0.89 | 같은 문장, 다른 관점 |
| 4. 합치기 | (4, 8) 로 돌아옴 | 입력과 같은 모양 |
한 줄로 줄이면, Multi-Head 는 폭을 h 조각으로 나눠 Attention 을 h 번 계산하고, 이어 붙여 원래 폭으로 되돌린 뒤 W_O 로 섞습니다.
코드 설명
split_heads의reshape(n, h, d_head)는 8칸을 4칸씩 자르고,transpose(1, 0, 2)는 head 를 맨 앞 축으로 보냅니다. 그래야@가 head 마다 따로 계산됩니다.- 3차원 배열의
@는 맨 앞 축(head)마다 행렬곱을 합니다. for 문 없이 두 head 를 한꺼번에 계산한 것입니다. - head 마다 √d_head = √4 = 2 로 나눕니다. 원 논문도 head 하나의 폭 64 를 써서 8 로 나눕니다.
- 실제 구현은 head 마다 W 를 따로 두는 대신 큰 W_Q 하나를 곱한 뒤 잘라 씁니다. 이 실습도 그 방식이고, 강사자료 그림의 "head 마다 다른 W" 와 계산이 같습니다.
- 가중치 수 256 은 head 수와 상관이 없습니다. 나누기는 계산을 여러 관점으로 나누는 것이지 파라미터를 늘리지 않습니다.