3장. Attention과 Encoder
실습 2 — √d_k 로 나누면 무엇이 달라질까
벡터 길이 d_k 를 4, 16, 64, 256 으로 바꿔 가며 내적 점수가 얼마나 커지는지 재고, √d_k 로 나누면 눈금이 1 안팎으로 돌아오는지 확인합니다. 원본 노트북에는 코드가 없어 새로 쓴 코드입니다. 무작위 벡터는 np.random.seed(42) 로 고정합니다.
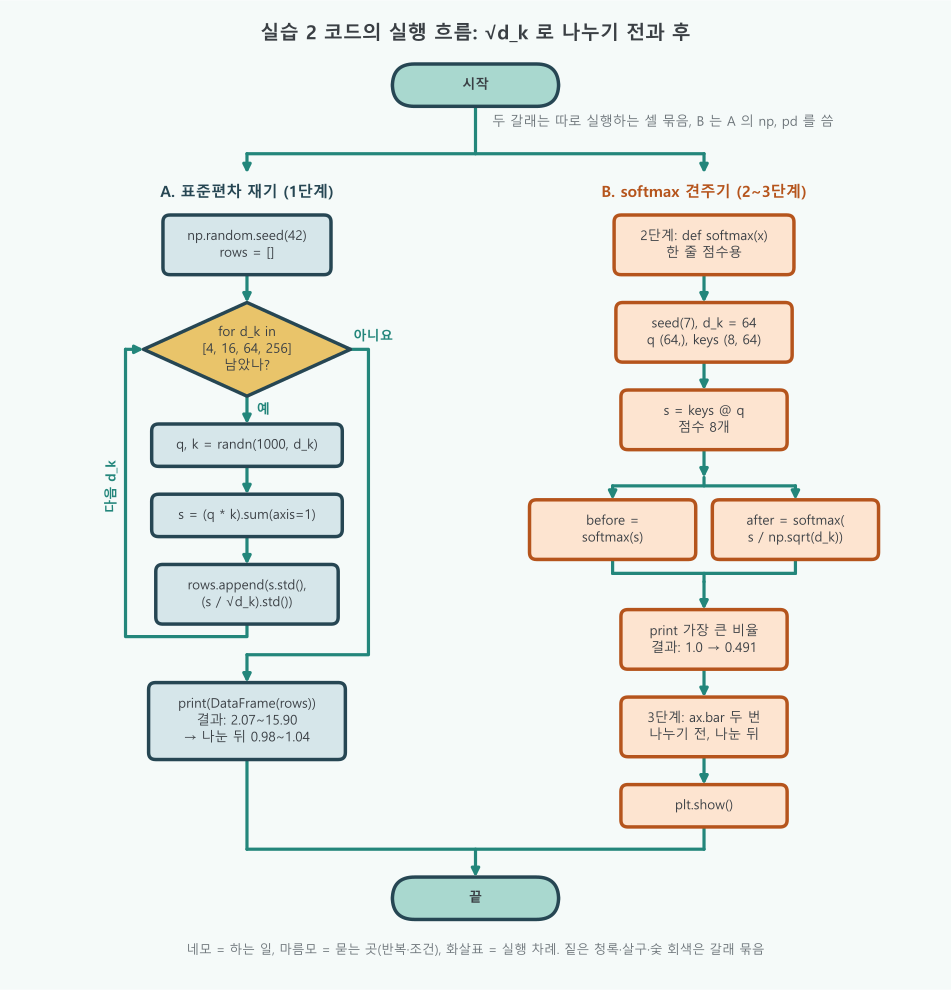
코드가 두 묶음으로 나뉘어 있어, 먼저 실행 흐름을 한 장으로 봅니다.
| 갈래 | 단계 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| A. 표준편차 재기 | 1 | d_k 네 값을 하나씩 도는 반복(for d_k in [4, 16, 64, 256]) | s = (q * k).sum(axis=1) |
| B. softmax 견주기 | 2~3 | 없음. 점수 8개를 한꺼번에 계산하고, 나누기 전과 뒤가 나란히 갈라졌다 다시 모인다 | after = softmax(s / np.sqrt(d_k)) |
- 두 갈래: 짙은 청록(A)과 살구(B)는 따로 실행하는 셀 묶음입니다. B 는 A 의
import numpy as np,import pandas as pd를 쓰므로 A 를 먼저 실행합니다. - A 의 반복: 마름모 "d_k 남았나?"를 네 번 "예"로 지나며
rows에 한 행씩 쌓고, 다섯 번째에 "아니요"로 빠져나가 표를 찍습니다. 과목 수를 4, 16, 64, 256 으로 늘려 가며 총점의 퍼짐을 재는 일입니다. - B 의 나란한 두 네모:
before와after는 같은 점수s에서 나온 두 결과입니다. 3단계는 이 둘을ax.bar로 나란히 그리고plt.show()로 끝납니다.
1단계. d_k 에 따라 점수의 표준편차 재기
과목 수를 늘려 가며 총점이 얼마나 벌어지는지 잽니다.
import numpy as np
import pandas as pd

np.random.seed(42)
rows = []
for d_k in [4, 16, 64, 256]:
    # 평균 0, 표준편차 1 인 Query 와 Key 를 1000 쌍 만든다
    q = np.random.randn(1000, d_k)
    k = np.random.randn(1000, d_k)
    # 쌍마다 내적: 같은 자리끼리 곱해 행마다 더한다
    s = (q * k).sum(axis=1)
    rows.append({
        "d_k": d_k,
        "√d_k": np.sqrt(d_k),
        "점수 표준편차": s.std().round(2),                  # 나누기 전
        "나눈 뒤 표준편차": (s / np.sqrt(d_k)).std().round(2),  # √d_k 로 나눈 뒤
    })

print(pd.DataFrame(rows))
# 결과: 나누기 전 2.07, 4.06, 7.86, 15.90 (√d_k 쯤), 나눈 뒤 1.04, 1.02, 0.98, 0.99 d_k √d_k 점수 표준편차 나눈 뒤 표준편차
0 4 2.0 2.07 1.04
1 16 4.0 4.06 1.02
2 64 8.0 7.86 0.98
3 256 16.0 15.90 0.992단계. 같은 점수 한 줄로 softmax 견주기
d_k = 64 인 Query 하나와 Key 여덟 개의 점수를, 나누기 전과 8 로 나눈 뒤 각각 비율로 바꿉니다.
def softmax(x):
    e = np.exp(x - x.max())   # 한 줄 점수용 softmax
    return e / e.sum()

np.random.seed(7)
d_k = 64
q = np.random.randn(d_k)          # Query 하나
keys = np.random.randn(8, d_k)    # Key 여덟 개(낱말 8개)
s = keys @ q                      # (8, 64) @ (64,) → 점수 8개

before = softmax(s)                 # 나누지 않고
after = softmax(s / np.sqrt(d_k))   # √64 = 8 로 나누고

table = pd.DataFrame({"점수": s.round(1), "나누기 전": before.round(3), "나눈 뒤": after.round(3)})
print(table)
print("가장 큰 비율  나누기 전:", before.max().round(3), " 나눈 뒤:", after.max().round(3))
# 결과: 가장 큰 비율 나누기 전: 1.0 나눈 뒤: 0.491 점수 나누기 전 나눈 뒤
0 1.3 0.0 0.102
1 -15.7 0.0 0.012
2 4.6 0.0 0.153
3 1.0 0.0 0.098
4 13.9 1.0 0.491
5 -9.4 0.0 0.027
6 -3.5 0.0 0.056
7 -2.7 0.0 0.062
가장 큰 비율 나누기 전: 1.0 나눈 뒤: 0.4911단계 표에서 나누기 전 표준편차는 2.07, 4.06, 7.86, 15.90 으로 √d_k(2, 4, 8, 16)와 거의 같고, 나눈 뒤에는 0.98~1.04 로 모두 1 근처입니다. 2단계에서는 4번 낱말의 점수 13.9 가 둘째인 2번의 4.6 보다 9.3 높습니다. e^9.3 은 약 1만 배라서 나누기 전에는 4번이 비율 1.0 을 다 가져갑니다. 8 로 나누면 차이가 1.16 으로 줄고 e^1.16 ≈ 3.2 배이므로, 4번 0.491 과 2번 0.153 처럼 약 3배 차이로 누그러집니다.
3단계. 두 분포를 막대그래프로 보기
두 비율을 나란히 그려 쏠림을 눈으로 봅니다.
import matplotlib.pyplot as plt

# 한글 글꼴(윈도우의 맑은 고딕)과 마이너스 기호 설정
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

x = np.arange(8)                  # 낱말 번호 0~7
fig, ax = plt.subplots(figsize=(7, 3.2))
# 막대 두 묶음을 0.4 씩 옆으로 비켜 그린다
ax.bar(x - 0.2, before, width=0.4, label="나누기 전", color="#264653")
ax.bar(x + 0.2, after, width=0.4, label="√d_k 로 나눈 뒤", color="#e9c46a")
ax.set_xlabel("Key 낱말 번호")
ax.set_ylabel("softmax 비율")
ax.set_title("d_k = 64 에서 √d_k 로 나누기 전과 후")
ax.legend()
plt.tight_layout()
plt.show()
# 결과: 짙은 청록 막대는 4번 하나만 1.0, 겨자색 막대는 여덟 개가 모두 조금씩 높다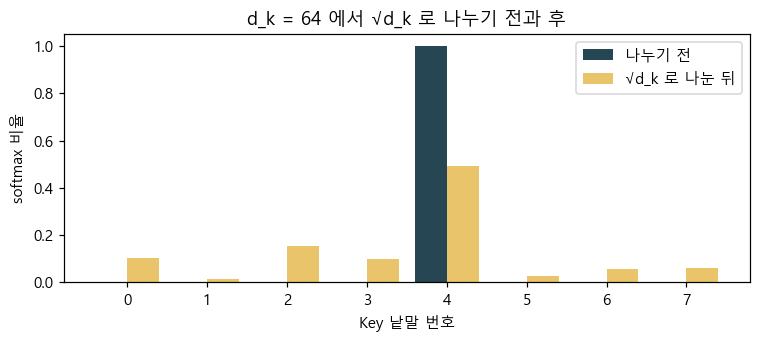
짙은 청록 막대(나누기 전)는 4번 낱말 하나만 1.0 에 닿고 나머지는 보이지 않을 만큼 0 에 가깝습니다. 겨자색 막대(나눈 뒤)는 4번이 0.491 로 여전히 가장 높지만, 2번 0.153, 0번 0.102 처럼 다른 낱말도 비율을 받습니다.
이 실습이 뜻하는 것
과목 수(d_k)를 늘리면 총점(내적)이 √d_k 배로 벌어지고(1단계), 그대로 득표율로 바꾸면 1등이 거의 다 가져가지만, 눈금을 √d_k 로 줄이면 고루 나뉘는 것(2~3단계)을 확인했습니다. 여기서 과목 수가 d_k, 총점이 s, 두 득표율이 before, after 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 표준편차 | 2.07, 4.06, 7.86, 15.90 → 나눈 뒤 0.98~1.04 | 점수 퍼짐은 √d_k 쯤, 나누면 1 근처 |
| 2. softmax 견주기 | 가장 큰 비율 1.0 → 0.491 | 나누기 전에는 쏠리고, 뒤에는 퍼진다 |
| 3. 막대그래프 | 두 묶음 막대 | 쏠림을 눈으로 확인 |
한 줄로 줄이면, √d_k 로 나누기는 d_k 가 얼마든 점수 눈금을 1 안팎으로 맞춰 softmax 가 한쪽으로 쏠리지 않게 합니다.
코드 설명
(q * k).sum(axis=1)은 1000 쌍의 내적을 한꺼번에 구합니다.q @ k.T로 하면 1000×1000 표가 되므로 대각선만 필요한 여기서는 이 꼴이 알맞습니다.- 1단계 표의 "점수 표준편차"가 √d_k 열과 비슷한 것이 "분산이 d_k 쯤"이라는 말의 확인입니다.
- 2단계의
keys @ q는(8, 64) @ (64,)로 점수 8개를 냅니다. 실습 1의Q @ K.T에서 Query 한 줄만 떼어 본 것과 같습니다. - 차례(어느 낱말이 1등인가)는 나누기 전과 후가 같습니다. 바뀌는 것은 쏠림의 정도뿐입니다.
- 씨앗을 바꾸면 숫자는 달라지지만 "나누기 전에 더 쏠린다"는 경향은 그대로입니다.