3장. Attention과 Encoder
실습 1 — 세 낱말로 Self-Attention 한 번 계산하기
"나는 사과를 먹었다" 세 낱말로 Q·K·V 를 만들고, 점수표, 가중치표, 새 벡터를 차례로 계산합니다. 원본 노트북에는 이 부분의 코드가 없어 새로 쓴 코드입니다. 낱말 벡터는 설명을 위해 정한 값이고, 가중치 행렬은 np.random.seed(0) 으로 만든 무작위 값을 소수 첫째 자리까지 반올림해 손으로도 계산할 수 있게 했습니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
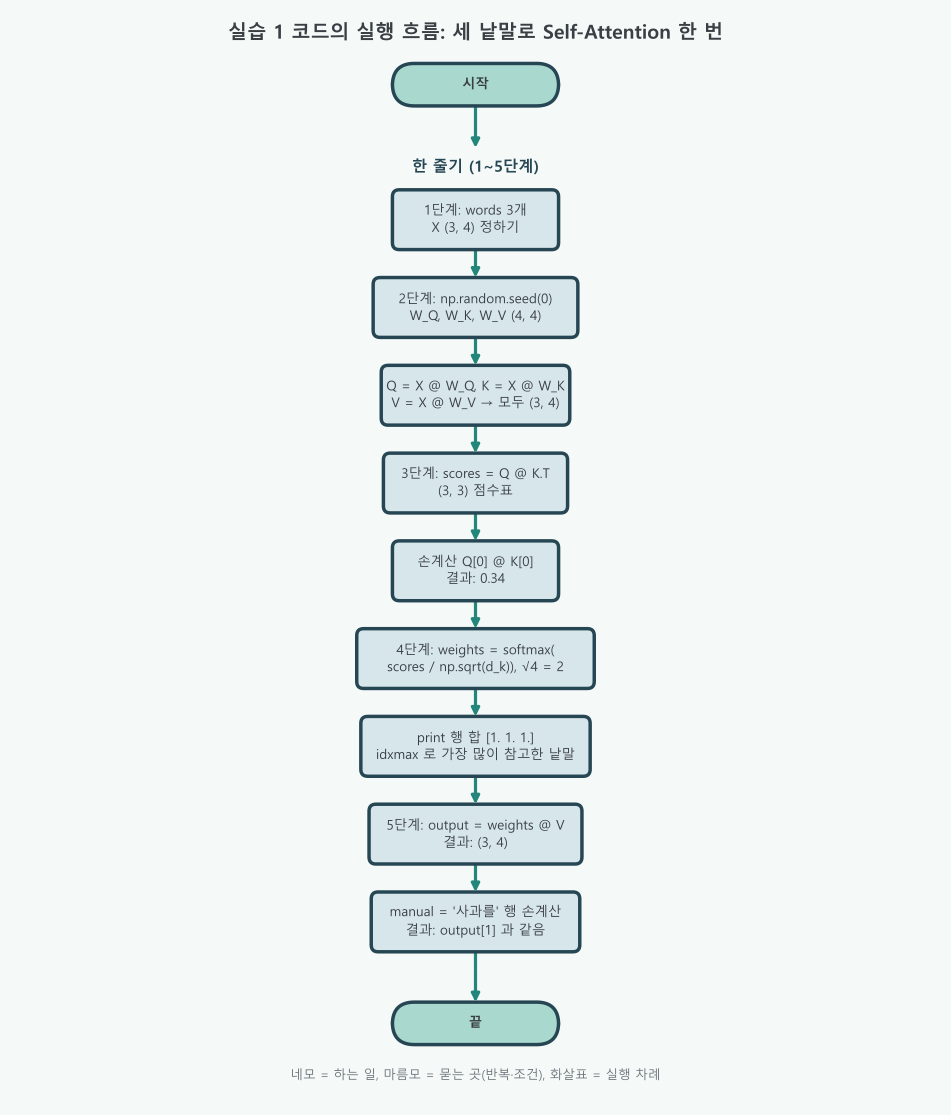
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 낱말 3개의 특징표 X 정하기 | 없음 | X = np.array([...], dtype=float) |
| 2 | 규칙표 세 장으로 Q, K, V 만들기 | 없음 | Q = X @ W_Q |
| 3 | 모든 낱말 쌍의 점수표 만들기 | 없음(손계산 줄의 zip 은 네 칸을 이어 적을 뿐이다) | scores = Q @ K.T |
| 4 | √d_k 로 나누고 행마다 비율로 바꾸기 | 없음 | weights = softmax(scores / np.sqrt(d_k)) |
| 5 | 비율만큼 V 를 섞어 새 벡터 만들기 | 없음 | output = weights @ V |
- 흐름도의 모양: 위아래가 둥근 알약은 시작과 끝, 네모는 하는 일, 화살표는 실행 차례입니다. 마름모는 "반복을 더 할까?", "조건이 맞나?"처럼 묻는 곳이고, 마름모에서 "예"로 내려가 일을 한 뒤 다시 마름모로 돌아오는 고리가 반복문입니다. 이 실습에는 마름모가 없습니다.
- 반복이 없는 까닭: 낱말 3개 × 3개의 점수 아홉 칸을 for 문으로 돌지 않고 행렬곱
Q @ K.T한 번으로 계산합니다. Attention 이 GPU 에서 빠른 까닭이 이것입니다. - 손계산 두 번: 3단계와 5단계 끝의 네모는 표의 한 칸, 한 행을 손으로 다시 계산해 행렬곱 결과와 같은지 확인하는 곳입니다.
1단계. 낱말 세 개의 벡터 정하기
회의실에 세 사람을 앉히고 각자의 성격표(특징 4개)를 적습니다.
import numpy as np
import pandas as pd

# 소수 둘째 자리까지, 지수 표기 없이 찍는다
np.set_printoptions(precision=2, suppress=True)

# 문장 "나는 사과를 먹었다" 의 낱말 3개
words = ["나는", "사과를", "먹었다"]
# X: 낱말 3개 × 특징 4개 (설명을 위해 정한 값. 실제로는 2차시의 임베딩 + 위치 인코딩)
X = np.array([[1, 0, 1, 0],
              [0, 2, 0, 1],
              [1, 1, 0, 2]], dtype=float)

# DataFrame 으로 감싸 행 이름(낱말)과 함께 본다
print(pd.DataFrame(X, index=words, columns=["f0", "f1", "f2", "f3"]))
# 결과: 3행 4열 표
print("X shape:", X.shape)
# 결과: X shape: (3, 4) → 낱말 3개, d_model 4 f0 f1 f2 f3
나는 1.0 0.0 1.0 0.0
사과를 0.0 2.0 0.0 1.0
먹었다 1.0 1.0 0.0 2.0
X shape: (3, 4)2단계. W_Q, W_K, W_V 로 Q, K, V 만들기
같은 성격표에 서로 다른 규칙표 세 장을 대어 검색어, 이름표, 본문을 만듭니다.
# 씨앗(seed)을 0 으로 고정하면 실행할 때마다 같은 무작위 값이 나온다
np.random.seed(0)
# randn(4, 4): 평균 0, 표준편차 1 인 무작위 숫자 4×4. × 0.5 로 크기를 줄이고 소수 첫째 자리로 반올림
W_Q = np.round(np.random.randn(4, 4) * 0.5, 1)
W_K = np.round(np.random.randn(4, 4) * 0.5, 1)
W_V = np.round(np.random.randn(4, 4) * 0.5, 1)

# Q = XW_Q, K = XW_K, V = XW_V : (3, 4) @ (4, 4) → (3, 4)
Q = X @ W_Q
K = X @ W_K
V = X @ W_V

print("Q =\n", Q)
print("K =\n", K)
print("Q, K, V shape:", Q.shape, K.shape, V.shape)
# 결과: 세 개 모두 (3, 4) → 낱말마다 검색어, 이름표, 본문이 하나씩Q =
[[ 0.8 0.4 0.6 1.8]
[ 2.2 -0.9 1.2 0. ]
[ 2.6 -0.1 1.4 1.4]]
K =
[[ 1.8 -0.8 0.2 -0.5]
[-1.8 1.3 0.9 -0.6]
[ 1. 1.6 0.8 -0.4]]
Q, K, V shape: (3, 4) (3, 4) (3, 4)3단계. 점수표 QKᵀ 만들기
모든 사람이 모든 사람에게 "얼마나 관련 있나" 표를 줍니다. 3명이므로 3×3 표입니다.
# K.T: K 를 전치해 (4, 3). (3, 4) @ (4, 3) → (3, 3)
scores = Q @ K.T
print(pd.DataFrame(scores.round(2), index=words, columns=words))
# 결과: 행 = 찾는 낱말(Query), 열 = 찾아지는 낱말(Key)

# 손계산 대조: '나는' 의 Q 와 '나는' 의 K 를 같은 자리끼리 곱해 더한다
print("손계산:", " + ".join(f"{q:.1f}×{k:.1f}" for q, k in zip(Q[0], K[0])), "=", round(float(Q[0] @ K[0]), 2))
# 결과: scores 의 왼쪽 위 칸과 같은 값 나는 사과를 먹었다
나는 0.34 -1.46 1.20
사과를 4.92 -4.05 1.72
먹었다 4.34 -4.39 3.00
손계산: 0.8×1.8 + 0.4×-0.8 + 0.6×0.2 + 1.8×-0.5 = 0.344단계. √d_k 로 나누고 softmax 로 가중치표 만들기
점수 눈금을 줄이고, 행마다 합이 1 인 득표율로 바꿉니다.
def softmax(x):
    # 행마다 가장 큰 값을 빼고 exp: 비율은 같고 숫자가 넘치지 않는다
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    # 행마다 합으로 나눈다 → 행 합 1
    return e / e.sum(axis=-1, keepdims=True)

d_k = K.shape[1]                     # Key 벡터의 길이 = 4
weights = softmax(scores / np.sqrt(d_k))   # √4 = 2 로 나눈 뒤 비율로

attn = pd.DataFrame(weights.round(3), index=words, columns=words)
print(attn)
# 결과: 행마다 합이 1 인 비율 표. "나는" 행은 0.340 0.138 0.522
print("행 합:", weights.sum(axis=1).round(3))
# 결과: 행 합: [1. 1. 1.]
print("가장 많이 참고한 낱말:", attn.idxmax(axis=1).to_dict())
# 결과: {'나는': '먹었다', '사과를': '나는', '먹었다': '나는'} 나는 사과를 먹었다
나는 0.340 0.138 0.522
사과를 0.824 0.009 0.166
먹었다 0.656 0.008 0.336
행 합: [1. 1. 1.]
가장 많이 참고한 낱말: {'나는': '먹었다', '사과를': '나는', '먹었다': '나는'}"나는" 행을 손으로 따라가 봅니다. 점수 0.34, -1.46, 1.20 을 2 로 나누면 0.17, -0.73, 0.60 입니다. e^0.17 ≈ 1.19, e^-0.73 ≈ 0.48, e^0.60 ≈ 1.82 이고 합은 3.49 이므로 비율은 0.34, 0.14, 0.52 입니다. 출력 표의 첫 행과 같습니다. "사과를"이 "나는"을 0.824 만큼 참고하는 것처럼 보이지만, W 가 학습되지 않은 무작위 값이므로 이 무늬에 뜻은 없습니다.
5단계. 가중치 × V 로 새 벡터 만들기
득표율만큼 모두의 본문(V)을 섞어, 낱말마다 문맥이 담긴 새 벡터를 만듭니다.
# (3, 3) @ (3, 4) → (3, 4): 낱말 수와 폭이 입력과 같다
output = weights @ V
print("output =\n", output)
print("output shape:", output.shape)
# 결과: (3, 4) → X 와 같은 모양

# 손계산 대조: '사과를' 의 새 벡터 = 가중치 세 개 × V 세 줄의 합
manual = weights[1, 0] * V[0] + weights[1, 1] * V[1] + weights[1, 2] * V[2]
print("손계산:", manual.round(2))
# 결과: output 의 둘째 행과 같은 값output =
[[-0.39 -0.86 -1.35 0.74]
[-0.8 -1.53 -1.18 1.02]
[-0.72 -1.38 -1.27 0.96]]
output shape: (3, 4)
손계산: [-0.8 -1.53 -1.18 1.02]이 실습이 뜻하는 것
세 사람이 회의실에 앉아(1단계), 각자 검색어·이름표·본문 카드를 만들고(2단계), 서로 관련 점수를 매기고(3단계), 점수를 득표율로 바꾼 뒤(4단계), 득표율만큼 남의 본문을 섞어 자기 생각을 고쳐 쓴(5단계) 과정입니다. 여기서 회의실 사람들이 words, 성격표가 X, 득표율 표가 attn, 고쳐 쓴 생각이 output 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 벡터 정하기 | X shape: (3, 4) | 낱말 3개, 특징 4개 |
| 2. Q, K, V | 세 개 모두 (3, 4) | 같은 X 에서 세 역할 |
| 3. 점수표 | 3×3 표 | 모든 낱말 쌍의 내적 |
| 4. 가중치표 | 행 합 [1. 1. 1.], "나는" 행 0.340, 0.138, 0.522 | 낱말마다 참고 비율 |
| 5. 새 벡터 | (3, 4) | 입력과 같은 모양, 문맥이 섞임 |
한 줄로 줄이면, softmax(QKᵀ / √d_k) V 는 행렬곱 두 번과 softmax 한 번이고, 들어간 모양 (3, 4) 그대로 나옵니다.
코드 설명
np.random.seed(0)으로 무작위 값을 고정했습니다. 다른 씨앗을 주면 W 가 바뀌어 가중치표의 무늬도 바뀝니다.Q @ K.T의(i, j)칸은 i 번째 낱말이 j 번째 낱말을 얼마나 찾는지의 점수입니다. 3단계의 손계산 줄이 그 한 칸을 풀어 쓴 것입니다.softmax는axis=-1(행)마다 합니다. pandas 로 쓰면df.div(df.sum(axis=1), axis=0)처럼 행마다 나누는 꼴입니다.attn.idxmax(axis=1)는 행마다 가장 큰 열의 이름을 돌려줍니다. "누구를 가장 많이 참고했나"를 한 번에 읽습니다.- 지금 W 는 학습되지 않은 무작위 값이라 가중치표의 무늬에 뜻은 없습니다. 학습을 거치면 뜻이 이어진 낱말에 가중치가 모이도록 W 가 바뀝니다.