3장. Attention과 Encoder
Encoder 만 쌓으면(BERT)
시험지를 받으면 문제 전체를 끝까지 읽고 나서 답을 고릅니다. 앞 문장과 뒤 문장을 모두 보고 판단하므로 문장의 뜻을 깊이 이해할 수 있습니다. Encoder 만 쌓은 모델이 이렇습니다. 모든 낱말이 앞뒤 문맥을 모두 보는 양방향 Self-Attention 으로 문장을 읽습니다. 그런데 글짓기는 다릅니다. 아직 쓰지 않은 뒷문장을 미리 볼 수 없습니다. 한 낱말씩 이어 쓰는 생성에는 "미래 낱말을 보지 않는" 구조가 필요하고, 그것이 4장의 Decoder 입니다.
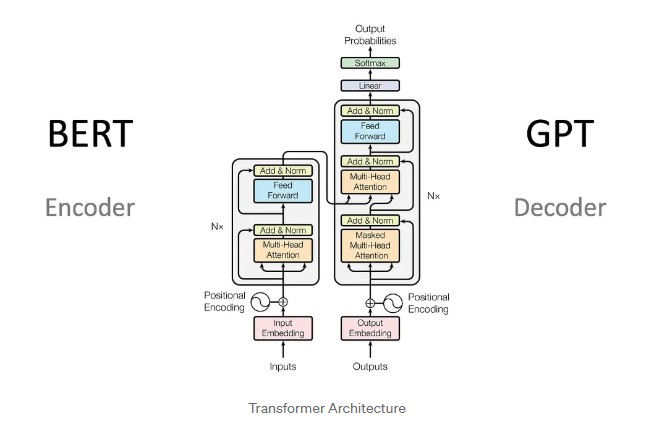
강사자료 그림의 가운데는 원 논문의 Transformer 전체 구조입니다. 왼쪽 탑(Encoder)만 떼어 쌓은 것이 BERT, 오른쪽 탑(Decoder)만 떼어 쌓은 것이 GPT 입니다. 2장에서 토큰화에 쓴 bert-base-uncased 가 바로 이 왼쪽 탑을 12층 쌓은 모델입니다.
Encoder 만 쌓은 모델이 잘하는 일
| 일 | 무엇을 하나 | 예 |
|---|---|---|
| 문장 분류 | 문장 전체를 보고 꼬리표를 붙인다 | 리뷰가 긍정인지 부정인지 |
| 개체명 인식 | 낱말마다 사람, 장소, 기관인지 붙인다 | "서울"은 장소 |
| 검색용 임베딩 | 문장을 벡터 하나로 바꾼다 | 질문과 가까운 문서 찾기 |
| 생성 | 잘 맞지 않는다 | 다음 낱말을 하나씩 쓰려면 Decoder 가 필요 |
짧은 예시
import numpy as np

n = 4   # 낱말 4개
# Encoder: 모든 낱말이 모든 낱말을 본다(1 = 볼 수 있음)
encoder_view = np.ones((n, n), dtype=int)
# Decoder(4차시): 자기와 앞 낱말만 본다. tril = lower triangle(아래 삼각형)
decoder_view = np.tril(np.ones((n, n), dtype=int))

print(encoder_view.sum(axis=1))   # 결과: [4 4 4 4] → 낱말마다 4개를 모두 본다
print(decoder_view.sum(axis=1))   # 결과: [1 2 3 4] → 첫 낱말은 자기만, 마지막은 4개
이 코드가 뜻하는 것
시험지를 끝까지 읽고 푸는 학생(Encoder)과, 글을 한 낱말씩 쓰며 앞만 볼 수 있는 학생(Decoder)이 볼 수 있는 칸을 1 로 표시한 표입니다. 여기서 볼 수 있는 칸 표가 encoder_view, decoder_view 이고, 행 합이 낱말마다 볼 수 있는 낱말 수입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
np.ones((n, n)) | 모든 칸이 1 인 표 | 앞뒤 모두 보기 |
np.tril(...) | 대각선 위쪽을 0 으로 | 미래 칸 가리기 |
.sum(axis=1) | 행마다 합 | 낱말마다 몇 개를 보나 |
주의할 점
- BERT 같은 Encoder 모델로 긴 글을 지어내려고 하면 잘 되지 않습니다. 용도에 맞는 구조를 고릅니다. 이 과정의 2일차는 Decoder 만 쌓은 Qwen 으로 생성과 파인튜닝을 합니다.
- Encoder 모델은 한 번에 읽을 수 있는 토큰 수에 한계가 있습니다(BERT-base 는 512 토큰). 긴 문서는 잘라서 넣습니다.