3장. Attention과 Encoder
Multi-Head Attention
신제품 기획 회의에 디자이너, 개발자, 마케터가 함께 들어왔다고 해 봅시다. 같은 시제품을 보더라도 디자이너는 모양을, 개발자는 구조를, 마케터는 가격을 봅니다. 각자 의견을 낸 뒤 회의록에 나란히 적고, 팀장이 그것을 하나의 결론으로 정리합니다. Multi-Head Attention 이 이 방식입니다. 벡터를 h 조각으로 나눠 head 마다 따로 Attention 을 계산하고, 결과를 이어 붙인 뒤 W_O 로 다시 섞습니다.
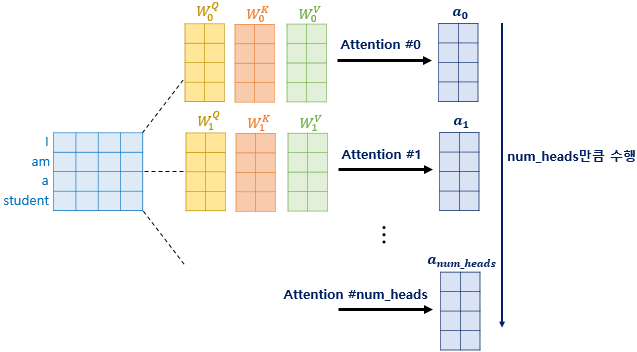
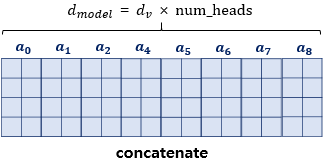
첫 강사자료 그림은 문장 "I am a student" 의 표(파란 4행)를 head 마다 다른 세 표(노랑 W^Q, 주황 W^K, 초록 W^V)에 곱해 Attention 을 따로 계산하는 모습입니다. 오른쪽 아래 화살표처럼 이 일을 head 수(num_heads)만큼 합니다. 둘째 그림은 그 결과 a_0, a_1, ... 를 옆으로 이어 붙이는 단계입니다. head 하나의 폭 d_v 에 head 수를 곱하면 원래 폭 d_model 로 돌아옵니다.
모델별 head 나누기
| 모델 | d_model | head 수 h | head 차원 (d_model ÷ h) |
|---|---|---|---|
| Transformer base (2017) | 512 | 8 | 64 |
| BERT-base | 768 | 12 | 64 |
| Qwen2.5-0.5B-Instruct | 896 | 14 | 64 |
세 모델 모두 head 하나의 차원이 64 입니다. 768 ÷ 12 = 64, 896 ÷ 14 = 64 입니다. head 마다 차원을 d_model ÷ h 로 줄이므로, head 를 여러 개 써도 전체 계산량은 head 하나로 512 를 통째로 계산할 때와 비슷합니다. Qwen 의 구조는 5장에서 직접 열어 봅니다.
짧은 예시
import numpy as np

# 낱말 4개, d_model 8 짜리 Q (값은 0 부터 31 까지 차례로 채운 것)
Q = np.arange(32).reshape(4, 8)
h = 2                    # head 2개
d_head = 8 // h          # head 하나의 폭 = 4

# reshape: (4, 8) → (4, 2, 4) 낱말마다 8칸을 4칸씩 두 조각으로
# transpose(1, 0, 2): (head, 낱말, 칸) 차례로 바꿔 head 마다 표 하나가 되게
heads = Q.reshape(4, h, d_head).transpose(1, 0, 2)
print(heads.shape)       # 결과: (2, 4, 4) → head 2개, 낱말 4개, 칸 4개
print(heads[1][0])       # 결과: [4 5 6 7] → 첫 낱말의 뒤쪽 4칸이 head 1 몫

# 다시 이어 붙이기(Concat): 차례를 되돌리고 (4, 8) 로
back = heads.transpose(1, 0, 2).reshape(4, 8)
print((back == Q).all())   # 결과: True → 나눴다 붙이면 원래대로
이 코드가 뜻하는 것
여덟 칸짜리 회의 자료를 두 전문가에게 네 칸씩 나눠 주고, 다시 모아 붙이면 원래 자료가 되는 것을 확인한 코드입니다. 여기서 회의 자료가 Q, 전문가 몫이 heads[0], heads[1], 다시 모은 자료가 back 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
Q.reshape(4, h, d_head) | 8칸을 4칸씩 두 조각으로 | 자료를 반으로 자르기 |
.transpose(1, 0, 2) | head 를 맨 앞 축으로 | 전문가별로 묶기 |
heads.transpose(1, 0, 2).reshape(4, 8) | 되돌려 이어 붙이기 | 회의록에 나란히 적기 |
실제 Multi-Head 에서는 나누기 전에 head 마다 다른 가중치로 Q, K, V 를 만들고, 이어 붙인 뒤에는 W_O 를 곱해 섞습니다. 나누고 붙이는 모양은 이 코드와 같습니다. 실습 3에서 전체를 계산합니다.
주의할 점
- d_model 이 h 로 나누어떨어져야 합니다. 896 은 14 로 나누어떨어지지만 13 으로는 나누어떨어지지 않아 head 13개로는 쪼갤 수 없습니다.
reshape만 하고transpose를 빼먹으면 head 마다 낱말이 섞여 엉뚱한 표가 됩니다. shape 를 찍어 (head, 낱말, 칸) 인지 확인합니다.