3장. Attention과 Encoder
Scaled Dot-Product Attention: 행렬 크기로 흐름 따라가기
반장 선거 개표를 떠올려 봅니다. 먼저 후보마다 표를 셉니다(점수). 점수가 너무 크면 눈금을 줄입니다. 그다음 득표를 비율(합 100%)로 바꾸고, 그 비율만큼 후보들의 공약을 섞어 학급 계획을 세웁니다. Attention 의 식 softmax(QKᵀ / √d_k) V 가 이 차례를 그대로 따릅니다. "비교하기 → 중요한 곳 고르기 → 정보 섞기"입니다.
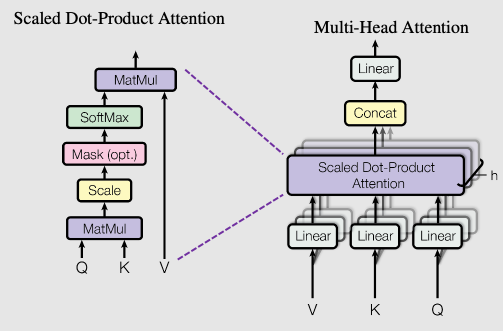
원 논문 그림의 왼쪽이 이 절의 식입니다. 아래에서 위로 읽습니다. Q 와 K 가 첫 MatMul(행렬곱)로 들어가 점수가 되고, Scale 에서 √d_k 로 나뉘고, Mask(opt.)는 필요할 때만 씁니다(4장의 Decoder). SoftMax 로 비율이 되고, 마지막 MatMul 에서 V 와 곱해집니다. 오른쪽 그림은 다음 절의 Multi-Head 입니다.
다섯 단계
| 단계 | 하는 일 | 식 | 개표로 치면 |
|---|---|---|---|
| 1 | Q 와 K 를 비교 | QKᵀ | 후보마다 표 세기 |
| 2 | 점수 조정 | ÷ √d_k | 눈금 줄이기 |
| 3 | Mask 적용 | 보면 안 되는 칸을 가림(4장) | 무효표 빼기 |
| 4 | softmax | 행마다 합 1 인 비율 | 득표율 |
| 5 | V 를 섞음 | × V | 득표율만큼 공약 섞기 |
행렬 크기로 따라가기
강사자료 그림은 원 논문 base 모델의 숫자(d_model 512, head 8개, head 하나의 d_k 64)를 씁니다. 낱말 10개는 shape 를 따라가기 위한 예시입니다. 왼쪽 X 는 (10, 512) 입니다. 여기에 (512, 64) 표를 곱하면 Q, K, V 는 모두 (10, 64) 입니다. 오른쪽 상자에서 QKᵀ 는 (10, 64) × (64, 10) = (10, 10) 입니다. 낱말 10개가 서로 매긴 점수표입니다. softmax 뒤에도 (10, 10) 이고, V 를 곱하면 (10, 10) × (10, 64) = (10, 64) 로 head 출력이 됩니다. 아래 띠는 8개 head 를 합치는 다음 절의 내용입니다.
| 계산 | 왼쪽 shape | 오른쪽 shape | 결과 shape | 뜻 |
|---|---|---|---|---|
| Q = XW_Q | (10, 512) | (512, 64) | (10, 64) | 낱말마다 검색어 |
| QKᵀ | (10, 64) | (64, 10) | (10, 10) | 모든 낱말 쌍의 점수 |
| softmax | (10, 10) | - | (10, 10) | 행마다 합 1 |
| 가중치 × V | (10, 10) | (10, 64) | (10, 64) | 낱말마다 새 벡터 |
짧은 예시
import numpy as np

def softmax(x):
    # 가장 큰 값을 빼고 exp 를 해도 비율은 같다(숫자가 너무 커지는 것을 막는다)
    e = np.exp(x - x.max(axis=-1, keepdims=True))
    # 행마다 합으로 나눈다 → 행 합이 1
    return e / e.sum(axis=-1, keepdims=True)

# 낱말 2개, d_k = 4 (설명을 위해 정한 값)
Q = np.array([[1., 0., 1., 0.],
              [0., 1., 0., 1.]])
K = np.array([[1., 0., 1., 0.],
              [1., 1., 1., 1.]])
V = np.array([[10., 0.],
              [0., 10.]])

scores = Q @ K.T                   # (2, 4) @ (4, 2) → (2, 2)
print(scores)                      # 결과: [[2. 2.] [0. 2.]]
weights = softmax(scores / np.sqrt(4))   # √4 = 2 로 나눈 뒤 비율로
print(weights.round(2))            # 결과: [[0.5 0.5] [0.27 0.73]]
print((weights @ V).round(1))      # 결과: [[5. 5.] [2.7 7.3]]
이 코드가 뜻하는 것
낱말 두 개가 서로 표를 주고(점수), 득표율을 내고(softmax), 득표율만큼 상대의 공약(V)을 섞는 개표 과정입니다. 여기서 표 세기가 Q @ K.T, 득표율이 weights, 섞은 공약이 weights @ V 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
Q @ K.T | 모든 낱말 쌍의 내적 | 후보마다 표 세기 |
scores / np.sqrt(4) | 점수를 2 로 나눈다 | 눈금 줄이기 |
softmax(...) | 행마다 합 1 인 비율 | df.div(df.sum(axis=1), axis=0) 과 같은 꼴 |
weights @ V | 비율대로 V 를 섞는다 | 득표율만큼 공약 섞기 |
둘째 낱말의 줄을 손으로 따라가 봅니다. 점수는 0 과 2, 2 로 나누면 0 과 1 입니다. e^0 = 1, e^1 ≈ 2.72 이고 합은 3.72 이므로 비율은 1 ÷ 3.72 ≈ 0.27, 2.72 ÷ 3.72 ≈ 0.73 입니다. 섞은 결과는 0.27×[10, 0] + 0.73×[0, 10] = [2.7, 7.3] 입니다.
주의할 점
K.T를 빼먹고Q @ K를 쓰면 shape 가 맞지 않아 오류가 나거나(낱말 수와 d_k 가 다를 때), 우연히 shape 가 맞으면 틀린 값이 조용히 나옵니다.- softmax 는 행(axis=-1, 마지막 축)마다 합니다. 열 방향으로 하면 "한 낱말이 다른 낱말들을 얼마나 참고하는가"가 아니게 됩니다.