3장. Attention과 Encoder
Self-Attention 의 직관
"작업자가 장비를 점검한 뒤 그것을 정지했다"라는 문장을 읽어 봅니다. 사람은 "그것"이 "장비"라는 것을 바로 압니다. "작업자"를 정지할 수는 없고, "점검한"과 "정지했다"는 모두 장비에 하는 일이기 때문입니다. 회의에서 누군가 "그것"이라고 말하면 듣는 사람이 앞의 발언을 떠올려 무엇을 가리키는지 맞히는 것과 같습니다. Self-Attention 은 "그것"의 벡터를 새로 만들 때 문장의 모든 낱말을 살펴보고, 관련 있는 낱말의 정보를 더 많이 섞습니다.
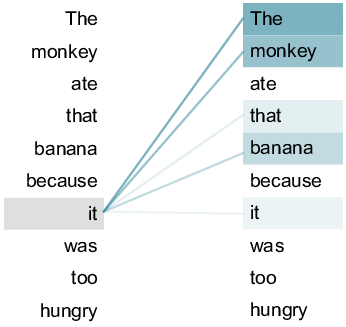
위 그림은 원본 노트북의 영어 예문 "The monkey ate that banana because it was too hungry"입니다. 왼쪽의 it 에서 오른쪽 낱말들로 선이 이어지고, 선과 칸이 진할수록 많이 참고한다는 뜻입니다. it 은 배가 고픈(hungry) 쪽, 곧 monkey 를 가리키므로 monkey 쪽 칸이 진합니다. 그 결과 같은 낱말이라도 문장마다 벡터가 달라집니다. 이것을 문맥 임베딩이라고 합니다.
2차시의 임베딩과 이 장의 문맥 임베딩
| 구분 | 2차시의 임베딩 | 이 장의 문맥 임베딩 |
|---|---|---|
| 만드는 곳 | 임베딩 표에서 토큰 ID 로 한 행 꺼내기 | Self-Attention 이 다른 낱말을 섞어 만들기 |
| 같은 낱말이면 | 문장이 달라도 같은 벡터 | 문장마다 다른 벡터 |
| "배"의 예 | 배(탈것)와 배(몸)가 같은 벡터 | "타다"를 본 배와 "고프다"를 본 배가 다름 |
| 표로 치면 | 상품 번호로 성격표 한 줄 찾기 | 같은 회의실 사람들 발언을 섞어 다시 쓰기 |
짧은 예시
import numpy as np

# 설명을 위해 정한 2차원 벡터: [동물 쪽 성질, 과일 쪽 성질]
monkey = np.array([1.0, 0.0])   # 원숭이: 동물 쪽
banana = np.array([0.0, 1.0])   # 바나나: 과일 쪽
it = np.array([0.5, 0.5])       # it: 처음에는 어느 쪽인지 모른다

# 참고 비율(합 1): monkey 를 0.7, banana 를 0.2, 자기 자신을 0.1 만큼 본다고 하자
new_it = 0.7 * monkey + 0.2 * banana + 0.1 * it
print(new_it)
# 결과: [0.75 0.25] → 동물 쪽 값이 커졌다
이 코드가 뜻하는 것
회의에서 "그것"이라고 말한 사람이 원숭이 이야기를 많이, 바나나 이야기를 조금 참고해 자기 생각을 고쳐 쓰는 모습입니다. 여기서 발언자가 it, 참고 비율이 0.7, 0.2, 0.1, 고쳐 쓴 생각이 new_it 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
monkey, banana, it | 낱말마다 벡터를 정한다 | 회의실 사람들의 발언 |
0.7 * monkey + ... | 비율대로 벡터를 더한다 | 많이 참고한 발언을 많이 섞기 |
print(new_it) | 새 벡터를 본다 | 고쳐 쓴 내 생각 |
손으로 계산하면 첫째 칸은 0.7×1 + 0.2×0 + 0.1×0.5 = 0.75, 둘째 칸은 0.7×0 + 0.2×1 + 0.1×0.5 = 0.25 입니다. it 이 동물 쪽으로 기울었습니다. 이 장의 나머지는 "비율 0.7, 0.2, 0.1 을 어떻게 정하는가"를 다룹니다.
주의할 점
- 예시의 비율과 벡터는 설명을 위해 정한 값입니다. 실제 모델은 학습으로 비율을 정하고, 벡터 길이도 수백 개입니다.
- 사람이 보기에 그럴듯한 참고 관계가 늘 나오는 것은 아닙니다. 학습된 모델의 head 가운데 일부만 대명사와 가리키는 대상을 잇습니다.