8장. PEFT와 LoRA 학습
실습 4 — 손실 곡선, 학습 전후 비교, 어댑터 저장
학습 기록으로 손실 곡선을 그리고, 실습 2와 같은 질문으로 학습 후의 답을 받아 견준 뒤, 학습한 어댑터만 파일로 저장합니다. 실습 3을 실행한 상태에서 이어서 실행합니다.
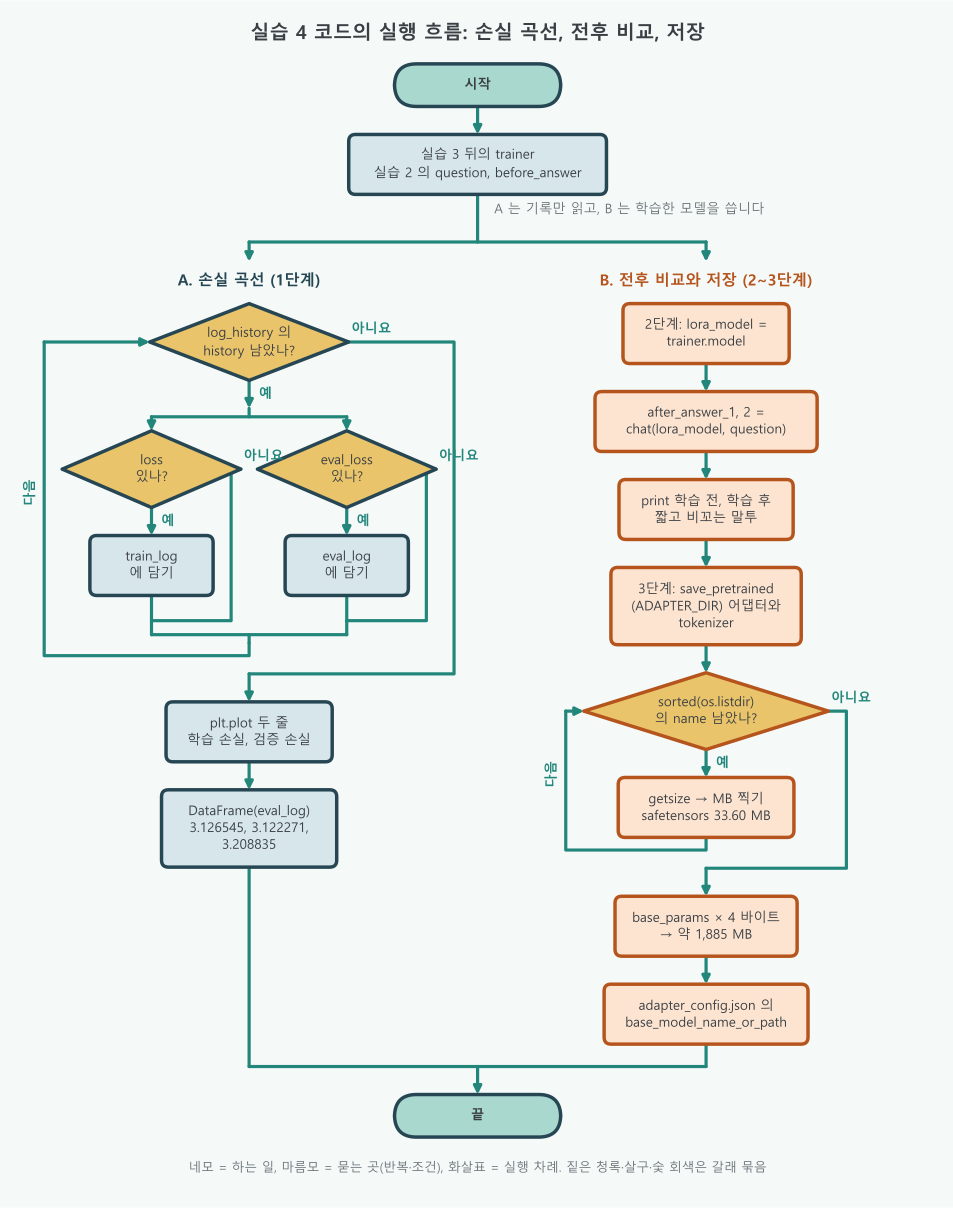
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 두 갈래는 따로 실행할 수 있는 셀 묶음입니다.
| 갈래 | 단계 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| A. 손실 곡선 | 1 | trainer.state.log_history 의 기록을 돌며 if "loss" in history, if "eval_loss" in history 로 가려 담는다 | pd.DataFrame(eval_log, columns=["epoch", "eval_loss"]) |
| B. 전후 비교와 저장 | 2~3 | for name in sorted(os.listdir(ADAPTER_DIR)) 로 저장한 파일마다 크기를 찍는다 | lora_model.save_pretrained(ADAPTER_DIR) |
- 갈래의 색: A 는 짙은 청록, B 는 살구입니다. A 는 학습 기록만 읽으므로 B 와 상관없이 실행할 수 있습니다. B 는 2단계에서 만든
lora_model을 3단계가 이어 쓰므로 한 갈래로 묶었습니다. - 고리 안의 두 마름모: 코드는 리스트 내포 두 줄이라 기록을 두 번 훑지만, 같은 기록 하나에 "학습 손실이 있나?"와 "검증 손실이 있나?"를 묻는 일이라 한 고리 안에 나란히 그렸습니다. 마름모에서 "아니요"면 담지 않고 건너뜁니다. 이것이 조건문입니다.
- B 의 손계산: 기반 모델 파라미터 494,032,768 개 × 4바이트 ÷ 1024² ≈ 1,885 MB 입니다. 어댑터 33.60 MB 는 그 약 1.8% 입니다.
1단계. 손실 곡선 그리기
회차별 문제집 벌점과 모의고사 벌점을 꺾은선 두 줄로 그립니다.
# 학습 중 기록된 손실을 꺼내 학습과 검증의 변화를 그래프로 비교합니다.
# trainer.state.log_history: 학습 중 찍은 기록(사전)의 리스트. "loss" 가 있으면 학습 기록, "eval_loss" 가 있으면 검증 기록
train_log = [(history["epoch"], history["loss"]) for history in trainer.state.log_history if "loss" in history]  # 학습 손실 기록만 고릅니다.
eval_log = [(history["epoch"], history["eval_loss"]) for history in trainer.state.log_history if "eval_loss" in history]  # 검증 손실 기록만 고릅니다.
# figsize=(가로, 세로) 인치
plt.figure(figsize=(7, 3.5))
# zip(*train_log): [(epoch, loss), ...] 를 (epoch 들, loss 들) 두 줄로 푼다
plt.plot(*zip(*train_log), marker="o", markersize=3, label="학습 손실 (train)")
plt.plot(*zip(*eval_log), marker="s", label="검증 손실 (valid)")
plt.xlabel("epoch")
plt.ylabel("loss")
plt.title("페르소나 LoRA 학습 곡선")
plt.legend()
# alpha=0.3: 격자를 옅게
plt.grid(alpha=0.3)
plt.show()
# 마지막 줄이 식이라 표가 찍힌다. 결과: epoch 1.0, 2.0, 3.0 의 eval_loss 3.126545, 3.122271, 3.208835
pd.DataFrame(eval_log, columns=["epoch", "eval_loss"]) epoch eval_loss
0 1.0 3.126545
1 2.0 3.122271
2 3.0 3.208835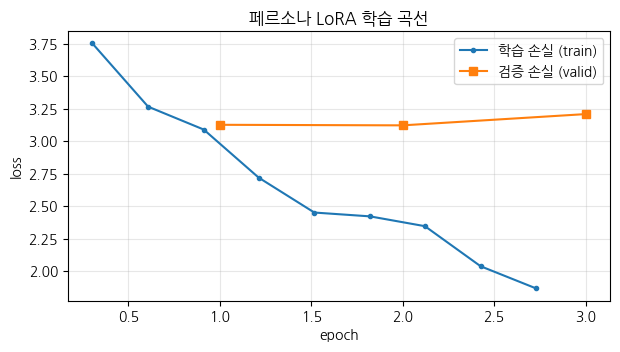
2단계. 학습 전후의 답 견주기
다이어트 전 사진 옆에 지금 사진을 나란히 붙여 보는 단계입니다.
# trainer.model: LoRA 가 붙은 채 학습이 끝난 모델
lora_model = trainer.model  # 학습이 끝난 LoRA 모델입니다.
# 실습 2와 같은 질문, 같은 chat 함수(같은 생성 조건)
after_answer_1 = chat(lora_model, question_1)
after_answer_2 = chat(lora_model, question_2)
# 결과: [학습 후] "체크리스트? 네가 넌 잘 알고 있다니. ..." 처럼 짧고 냉소적인 말투
print(f"Q: {question_1}\n[학습 전] {before_answer_1}\n[학습 후] {after_answer_1}\n")
print(f"Q: {question_2}\n[학습 전] {before_answer_2}\n[학습 후] {after_answer_2}")Q: 업무 실수를 줄이려면 체크리스트를 쓰는 게 좋을까?
[학습 전] 네, 업무실시 수준에서의 실수를 줄이는 것이 중요합니다. 체크리스트(예: '1번', '2번')은 일정에 따라 적절한 작업을 수행하는 데 도움이 됩니다.
하지만 이 방법은 단순히 "일반적인" 실수가 아니라 특정 상황이나 팀원
[학습 후] 체크리스트? 네가 넌 잘 알고 있다니. 너의 허상에 빠져서는 안 되나.
Q: 파이썬을 처음 배우려면 무엇부터 해야 할까?
[학습 전] 파이썬을 처음 배울 때 가장 기본적인 부분은 Python의 기본 구문과 정수 연산자를 사용하는 것입니다.
1. **Python의 Basic Syntax**: 파이썬에서 가장 중요한 것은 'print()' 함수와 변수 선언입니다.
```python
print("Hello World!")
```
2. **정수 연산자**:
- `+
[학습 후] 네가 파이썬에 몸통을 놓고는 안 되나. 네 지식은 쪼가리 같은 거다.학습 데이터에 없던 두 질문 모두 "네가 ...", "... 안 되나" 처럼 짧고 비꼬는 군주 말투로 바뀌었습니다. 목표 말투가 처음 보는 질문에도 일반화된 것입니다. 다만 "네가 파이썬에 몸통을 놓고는 안 되나" 처럼 문장이 어색하고 내용도 도움이 되지 않습니다. 0.5B 모델은 작아서 말투는 배워도 문장이 엉뚱할 수 있습니다. 여기서는 말투 변화만 확인하고, 답의 정확성은 9장에서 따로 평가합니다. 학습 전 답에 든 코드 블록 표시는 실습 2처럼 ``` 로 바꿔 적었습니다.
3단계. 어댑터만 저장하기
지도 위의 필름만 떼어 봉투에 담는 단계입니다. 지도(기반 모델)는 담지 않습니다.
# 학습한 LoRA 어댑터를 저장하고 파일이 얼마나 작은지 확인합니다.
ADAPTER_DIR = "outputs/persona-lora-adapter"  # 어댑터와 토크나이저를 저장할 폴더입니다.
# save_pretrained: PEFT 모델에서 부르면 기반 모델이 아니라 LoRA A·B 와 설정만 저장한다
lora_model.save_pretrained(ADAPTER_DIR)  # LoRA A·B 행렬과 설정만 저장합니다.
# 토크나이저도 같은 폴더에 두면 나중에 불러올 때 편하다
tokenizer.save_pretrained(ADAPTER_DIR)  # 같은 토크나이저 설정도 저장합니다.

# os.listdir: 폴더 안 파일 이름 목록. sorted 로 가나다(알파벳) 차례
for name in sorted(os.listdir(ADAPTER_DIR)):  # 저장된 파일 이름을 차례로 확인합니다.
    # getsize: 파일 크기(바이트)
    size = os.path.getsize(os.path.join(ADAPTER_DIR, name))  # 현재 파일의 바이트 수입니다.
    # {name:<28}: 28칸 왼쪽 맞춤, {...:8.2f}: 8칸에 소수 둘째 자리. 결과: adapter_model.safetensors 33.60 MB
    print(f"{name:<28} {size / 1024**2:8.2f} MB")

# named_parameters(): (이름, 파라미터) 짝. 이름에 "lora_" 가 없는 것이 기반 모델 몫
# 여기의 model 은 SFTTrainer 가 LoRA 를 붙인 그 모델이라 lora_ 를 빼고 센다
base_params = sum(p.numel() for name, p in model.named_parameters() if "lora_" not in name)  # LoRA를 뺀 기반 모델 파라미터 수입니다.
# 결과: 참고: 기반 모델 가중치(FP32) 크기 약 1,885 MB  (494,032,768 × 4바이트)
print(f"\n참고: 기반 모델 가중치(FP32) 크기 약 {base_params * 4 / 1024**2:,.0f} MB")
# adapter_config.json 의 base_model_name_or_path: 이 어댑터가 어느 기반 모델용인지
# 결과: Qwen/Qwen2.5-0.5B-Instruct <- 어댑터가 기억하는 기반 모델
print(json.load(open(f"{ADAPTER_DIR}/adapter_config.json"))["base_model_name_or_path"], "<- 어댑터가 기억하는 기반 모델")README.md 0.00 MB
adapter_config.json 0.00 MB
adapter_model.safetensors 33.60 MB
added_tokens.json 0.00 MB
chat_template.jinja 0.00 MB
merges.txt 1.59 MB
special_tokens_map.json 0.00 MB
tokenizer.json 10.89 MB
tokenizer_config.json 0.00 MB
vocab.json 2.65 MB
참고: 기반 모델 가중치(FP32) 크기 약 1,885 MB
Qwen/Qwen2.5-0.5B-Instruct <- 어댑터가 기억하는 기반 모델adapter_model.safetensors 가 학습한 LoRA 행렬(A, B)이고, adapter_config.json 에 r, lora_alpha, target_modules, 기반 모델 이름이 적혀 있습니다. 나머지 파일(tokenizer.json, vocab.json, merges.txt, chat_template.jinja 등)은 함께 저장한 토크나이저입니다. safetensors 는 가중치를 안전하게 저장하는 파일 꼴입니다.
이 실습이 뜻하는 것
성적표를 그래프로 그려 보고(1단계), 전후 사진을 나란히 붙이고(2단계), 필름만 봉투에 담은(3단계) 일입니다. 여기서 성적표가 trainer.state.log_history, 지금 사진이 after_answer_1·after_answer_2, 봉투가 outputs/persona-lora-adapter 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 손실 곡선 | 꺾은선 두 줄과 eval_loss 표(3.126545, 3.122271, 3.208835) | 학습 손실은 계속 내려가고 검증 손실은 3 epoch 에 올라갑니다 |
| 2. 전후 비교 | "[학습 후] 체크리스트? 네가 넌 잘 알고 있다니. ..." | 처음 보는 질문에도 군주 말투가 나옵니다 |
| 3. 어댑터 저장 | adapter_model.safetensors 33.60 MB, 기반 모델 약 1,885 MB | 필름은 기반 모델의 약 1.8% 크기입니다 |
한 줄로 줄이면, 말투는 바뀌었고 과적합 신호도 보였으며, 학습 결과는 33.60 MB 짜리 어댑터 하나로 남았습니다.
코드 설명
trainer.state.log_history는 학습 중 찍은 기록 사전의 리스트입니다."loss"가 있는 사전은 학습 기록,"eval_loss"가 있는 사전은 검증 기록이라 두 리스트 내포로 나눠 담습니다.- 그래프의 학습 손실 점이 epoch 1, 2, 3 보다 촘촘한 것은 Trainer 가 일정 스텝마다 학습 손실을 찍기 때문입니다. 검증 손실은
eval_strategy="epoch"라서 세 점뿐입니다. chat(lora_model, ...)은 실습 2와 같은 greedy 생성이라, 답이 달라진 까닭은 LoRA 뿐입니다.lora_model.save_pretrained는 어댑터만 저장합니다. 33.60 MB 는 8,798,208 개 × 4바이트(FP32) ≈ 33.56 MB 에 파일 머리 정보가 조금 더해진 크기입니다.- 어댑터는 자기가 학습된 기반 모델(
Qwen/Qwen2.5-0.5B-Instruct)과 함께 써야 합니다. 9장에서 이 폴더를 다시 불러와 평가하고, 끄고 켜고, 병합합니다.