8장. PEFT와 LoRA 학습
실습 1 — Qwen 에 LoRA 붙였다 떼기
설정표(LoraConfig)를 만들어 Qwen 의 선형층에 LoRA 필름을 붙이고, 학습할 파라미터가 몇 개인지와 첫 층이 어떻게 바뀌었는지 봅니다. 확인이 끝나면 필름을 떼어 원래 모델로 되돌립니다. 6·7장의 준비 코드(모델, chat 함수, persona_ds)를 먼저 실행해 둡니다. 6장의 셀 3(도구 불러오기), 6(모델 불러오기), 7(chat 함수), 11(generate 파이프라인)과 7장의 셀 24, 30, 31(persona_ds 만들기)입니다.
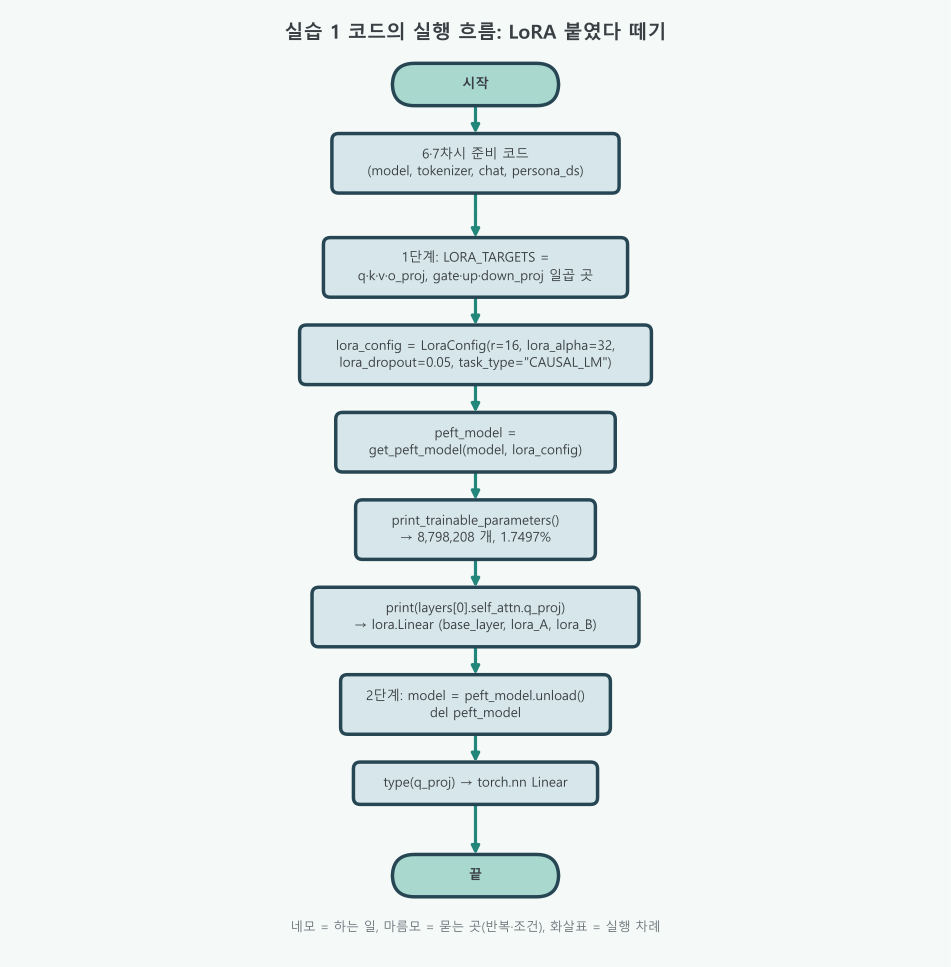
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 설정표를 만들어 LoRA 붙이고 확인 | 코드에는 없음. get_peft_model 이 안에서 층을 돌며 바꾼다 | peft_model = get_peft_model(model, lora_config) |
| 2 | LoRA 를 떼어 원래 모델로 되돌리기 | 없음 | model = peft_model.unload() |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 반복이 있는 실습에서는 마름모에서 "예"로 내려가 일을 하고, 화살표를 따라 다시 마름모로 돌아오는 고리가 반복문입니다. "아니요"면 고리를 빠져나와 다음 네모로 갑니다. 맨 위 네모는 먼저 실행해 둘 6·7장 준비 코드입니다.
- 마름모가 없는 까닭:
get_peft_model은 24층마다 일곱 곳, 모두 24 × 7 = 168 개의 선형층을 찾아lora.Linear로 바꿉니다. 이 반복은 함수 안에서 일어나고 코드에는 보이지 않으므로 네모 하나로 그렸습니다. - 끝부분: 붙인 결과(8,798,208 개, 1.7497%)를 확인한 뒤 바로
unload()로 떼어model을 원래대로 돌려 둡니다. 실습 3에서SFTTrainer가 LoRA 를 다시 붙이기 때문입니다.
1단계. LoRA 설정표를 만들어 붙이기
안경점에서 "일곱 곳에, 두께 16, 배율 2"라고 주문서를 쓰고 렌즈를 끼우는 단계입니다.
# Qwen의 Attention과 FFN에 있는 선형층에 LoRA를 적용합니다.
# LoraConfig = LoRA 설정표, get_peft_model = 모델에 LoRA 필름 붙이기
from peft import LoraConfig, get_peft_model  # Hugging Face 모델에 LoRA를 붙이는 도구입니다.

# 한 층에 일곱 곳: Attention 네 곳(q·k·v·o)과 FFN 세 곳(gate·up·down)
LORA_TARGETS = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]  # Attention·FFN의 모든 선형층 이름입니다.
lora_config = LoraConfig(  # LoRA가 붙을 층과 학습할 행렬 크기를 정합니다.
    # r: 랭크(필름 두께). A 는 896→16, B 는 16→896
    r=16,  # 추가로 학습할 두 행렬의 중간 차원을 16으로 정합니다.
    # lora_alpha: 배율을 정하는 값. 실제로 곱하는 수는 alpha ÷ r = 2
    lora_alpha=32,  # LoRA 변화량에 곱할 배율을 정합니다. 실제 배율은 32/16=2입니다.
    # lora_dropout: LoRA 길의 값을 5% 확률로 꺼서 답만 외우는 것을 막는다
    lora_dropout=0.05,  # 학습 중 LoRA 경로의 일부 값을 5% 확률로 끕니다.
    # target_modules: 위의 일곱 이름과 같은 층에만 붙인다
    target_modules=LORA_TARGETS,  # 어떤 선형층에 LoRA 행렬을 추가할지 지정합니다.
    # task_type: CAUSAL_LM = 다음 토큰 맞히기 모델
    task_type="CAUSAL_LM",  # 다음 토큰 예측 모델임을 지정합니다.
)

# get_peft_model(모델, 설정표): 지정한 층마다 lora_A·lora_B 를 붙이고 나머지는 모두 얼린다
peft_model = get_peft_model(model, lora_config)  # 지정한 층에 LoRA 모듈을 붙입니다.
# print_trainable_parameters = 학습할 파라미터 수 찍기
# 결과: trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497
peft_model.print_trainable_parameters()  # 전체 중 학습할 파라미터 비율을 출력합니다.
# base_model.model.model.layers[0]: PEFT 포장 → 원래 모델 → 몸통 → 0번 층
# 결과: lora.Linear( base_layer, lora_dropout, lora_A(896→16), lora_B(16→896) ... )
print(peft_model.base_model.model.model.layers[0].self_attn.q_proj) # 첫 층의 q_proj가 LoRA 층으로 바뀌었는지 봅니다.trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497
lora.Linear(
(base_layer): Linear(in_features=896, out_features=896, bias=True)
(lora_dropout): ModuleDict(
(default): Dropout(p=0.05, inplace=False)
)
(lora_A): ModuleDict(
(default): Linear(in_features=896, out_features=16, bias=False)
)
(lora_B): ModuleDict(
(default): Linear(in_features=16, out_features=896, bias=False)
)
(lora_embedding_A): ParameterDict()
(lora_embedding_B): ParameterDict()
(lora_magnitude_vector): ModuleDict()
)2단계. LoRA 를 떼어 원래 모델로 되돌리기
렌즈를 끼운 모습을 확인했으니 렌즈를 빼고 안경테만 남기는 단계입니다. 실습 3에서 SFTTrainer 가 LoRA 를 다시 붙이므로 여기서는 떼어 둡니다.
# LoRA가 붙은 층을 확인한 뒤 어댑터를 제거하고 기반 모델로 되돌립니다.
# unload() = LoRA 층을 빼고 원래 선형층만 남긴 모델을 돌려준다(학습한 값은 합치지 않는다)
model = peft_model.unload()  # LoRA 층을 제거하고 원래 모델로 되돌립니다.
# 포장된 모델을 가리키는 이름을 지운다
del peft_model  # 비교용 모델 참조를 삭제합니다.
# gc = garbage collector(쓰레기 수거). 이름이 없어진 객체의 메모리를 돌려받는다
gc.collect()  # 더 이상 쓰지 않는 객체를 정리합니다.
# 결과: <class 'torch.nn.modules.linear.Linear'>  (다시 보통 선형층)
print(type(model.model.layers[0].self_attn.q_proj)) # q_proj가 다시 일반 선형층인지 확인합니다.<class 'torch.nn.modules.linear.Linear'>이 실습이 뜻하는 것
안경테(Qwen)에 렌즈(LoRA)를 일곱 곳씩 24층에 끼워 보고, 몇 개를 새로 깎아야 하는지 센 뒤, 렌즈를 다시 뺀 일입니다. 여기서 주문서가 lora_config, 렌즈를 낀 안경이 peft_model, 렌즈를 뺀 안경테가 model 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 설정표를 만들어 붙이기 | trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497 | 전체의 약 1.75% 만 학습합니다 |
| 1. 첫 층 들여다보기 | lora.Linear( (base_layer) ... (lora_A) ... (lora_B) ...) | 원래 층은 base_layer 로 남고 A·B 가 붙었습니다 |
| 2. 떼어 내기 | <class 'torch.nn.modules.linear.Linear'> | 다시 보통 선형층입니다 |
한 줄로 줄이면, 494,032,768 개짜리 모델에 8,798,208 개짜리 필름을 붙였다 떼었고, 그 수는 본문의 손계산과 같습니다.
코드 설명
LoraConfig(r=16, lora_alpha=32, lora_dropout=0.05, target_modules=LORA_TARGETS, task_type="CAUSAL_LM")은 어디에, 얼마나 두껍게, 얼마나 세게 붙일지 적은 설정표입니다. 붙이기는 아직 하지 않습니다.get_peft_model(model, lora_config)이 실제로 붙입니다. 이름이target_modules와 맞는 층을lora.Linear로 바꾸고, LoRA 가 아닌 파라미터는 모두 얼립니다.- 출력의
base_layer는Linear(in_features=896, out_features=896, bias=True)로 원래 층 그대로이고,lora_A는 896→16,lora_B는 16→896 입니다.lora_embedding_A같은 빈 칸은 이번 설정에서 쓰지 않는 자리입니다. all params502,830,976 은 기반 모델 494,032,768 에 LoRA 8,798,208 을 더한 값입니다. 1.7497% 는 8,798,208 ÷ 502,830,976 입니다.peft_model.unload()는 LoRA 를 버리고 원래 층으로 되돌립니다. 학습한 LoRA 를 W 에 합쳐 붙이는 것은merge_and_unload()이고, 9장에서 다룹니다.