8장. PEFT와 LoRA 학습
프로젝트 1 — r 값에 따른 LoRA 크기 비교
작은 회사에서 고객 상담, 사내 공지 요약, 말투 맞추기 세 가지 업무에 LoRA 를 쓰려 한다고 해 봅시다. 팀장이 묻습니다. "r 을 4로 하면 얼마나 작아지고, 32로 하면 얼마나 커지나요? 어댑터 파일은 몇 MB 인가요?" 학습을 다 돌려 보지 않고도 답할 수 있어야 합니다. Qwen 을 불러와 r 을 바꿔 가며 LoRA 를 붙였다 떼면서 학습 파라미터 수, 비율, 어댑터 크기를 표로 만들고, 본문의 손계산과 같은지 대조합니다. 학습은 하지 않습니다.
요구사항
- 모델을 불러오지 않고, Qwen2.5-0.5B 의 층 크기(896, 128, 4864, 24층)만으로 r = 4, 8, 16, 32 일 때의 LoRA 파라미터 수와 예상 크기(MB, FP32)를 손계산으로 구합니다.
Qwen/Qwen2.5-0.5B-Instruct를 CPU 에 BF16 으로 불러와 기반 모델 파라미터 수를 찍습니다.- r 마다 실습 1과 같은 일곱 층에
get_peft_model로 LoRA 를 붙이고, 학습 파라미터 수와 전체 파라미터 수를 얻습니다. 어댑터를 저장해 실제 파일 크기를 잰 뒤unload()로 떼어 냅니다. - r, 학습 파라미터 수, 비율(%), 손계산 값, 일치 여부, 예상 MB, 실제 파일 MB 를 표로 만들어
out_ch08_lora_sizes.csv로 저장합니다. - 끝나면 모델을 지워 메모리를 돌려줍니다.
힌트
- 층 하나의 LoRA 수는
r × (입력 칸 + 출력 칸)입니다. 일곱 층을 더하고 24를 곱합니다. peft_model.get_nb_trainable_parameters()는(학습 파라미터 수, 전체 파라미터 수)짝을 돌려줍니다.print_trainable_parameters()가 찍는 두 수와 같습니다.lora_alpha는2 * r로 두어 배율(alpha ÷ r)을 2로 맞춥니다. 크기에는 영향이 없습니다.- 어댑터 크기는
save_pretrained로 저장한 폴더의adapter_model.safetensors를os.path.getsize로 잽니다. 잰 뒤 폴더는shutil.rmtree로 지워도 됩니다. - GPU 가 없어도 됩니다. 붙였다 떼기만 하므로 CPU 로 몇 초면 끝납니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 손계산 | 층 크기만으로 r 네 가지의 LoRA 수와 예상 MB 를 구한다 | 25 |
| 모델 불러오기 | Qwen 을 CPU 에 불러와 기반 파라미터 수를 찍는다 | 10 |
| 붙였다 떼기 | r 마다 LoRA 를 붙여 수를 얻고, 파일 크기를 재고, unload() 로 뗀다 | 30 |
| 표와 대조 | 비율과 MB 를 표로 만들고 손계산과의 일치를 확인해 CSV 로 저장한다 | 25 |
| 정리 | 모델을 지우고, r 과 크기의 관계를 한두 문장으로 설명한다 | 10 |
코드의 흐름
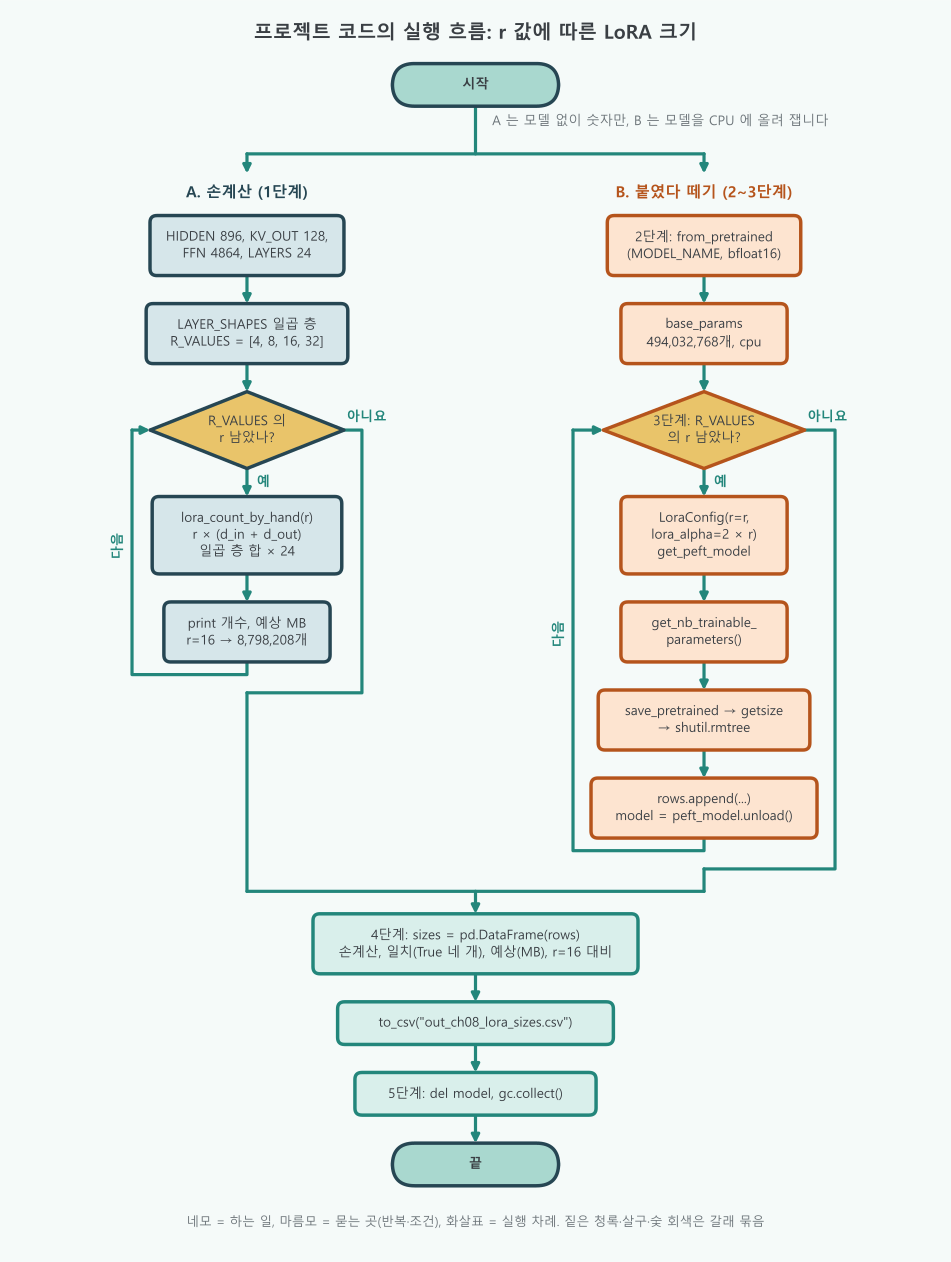
| 갈래 | 단계 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| A. 손계산 | 1 | for r in R_VALUES 네 바퀴 | per_layer = sum(r * (d_in + d_out) for _, d_in, d_out in LAYER_SHAPES) |
| B. 붙였다 떼기 | 2~3 | for r in R_VALUES 네 바퀴, 바퀴마다 붙이고 재고 뗀다 | model = peft_model.unload() |
| 모인 뒤 | 4~5 | 없음 | sizes["일치"] = sizes["학습 파라미터"] == sizes["손계산"] |
- 흐름도 읽는 법: 실습 1 과 같습니다. A 는 짙은 청록, B 는 살구, 두 갈래가 모인 뒤의 일은 청록 네모입니다. A 는 모델 없이 숫자만 쓰고, B 는 모델을 CPU 에 하나만 올려 잽니다.
- A 고리 한 바퀴의 손계산(r = 16): q·o_proj 는 16 × (896 + 896) = 28,672 개씩, k·v_proj 는 16 × (896 + 128) = 16,384 개씩, gate·up·down_proj 는 16 × (896 + 4864) = 92,160 개씩입니다. 일곱 곳을 더하면 한 층에 366,592 개, 24층이면 8,798,208 개입니다.
- B 고리의 마지막 네모: 바퀴마다 끝에서
unload()로 떼어야 다음 r 의 LoRA 가 지난 LoRA 위에 겹쳐 붙지 않습니다. 저장한 폴더도shutil.rmtree로 바로 지웁니다. - 모인 뒤: A 의 손계산 값과 B 의 측정값을 한 표에 놓고,
일치열이 네 줄 모두 True 인지 봅니다.
결과 보기 (예시 풀이)
1단계. 층 크기로 r 별 LoRA 크기 손계산하기
모델을 불러오기 전에 설계도(층 크기)만 보고 필름 넓이를 계산합니다.
# Qwen2.5-0.5B 의 층 크기(5차시 print(model) 에서 본 값)
HIDDEN = 896     # 토큰 성격표의 칸 수(hidden_size)
KV_OUT = 128     # k_proj·v_proj 의 출력 칸 수(Key·Value 머리 2개 × 64)
FFN = 4864       # FFN 가운데 칸 수(intermediate_size)
LAYERS = 24      # 층 수

# (층 이름, 입력 칸, 출력 칸): 실습 1의 LORA_TARGETS 일곱 곳
LAYER_SHAPES = [
    ("q_proj", HIDDEN, HIDDEN), ("k_proj", HIDDEN, KV_OUT), ("v_proj", HIDDEN, KV_OUT),
    ("o_proj", HIDDEN, HIDDEN), ("gate_proj", HIDDEN, FFN), ("up_proj", HIDDEN, FFN),
    ("down_proj", FFN, HIDDEN),
]
R_VALUES = [4, 8, 16, 32]   # 비교할 랭크(필름 두께)


def lora_count_by_hand(r):
    # 한 층: 일곱 곳의 r × (입력 + 출력)을 더한다
    per_layer = sum(r * (d_in + d_out) for _, d_in, d_out in LAYER_SHAPES)
    # 24층을 곱한다
    return per_layer * LAYERS


for r in R_VALUES:
    n = lora_count_by_hand(r)
    # 예상 크기: LoRA 는 FP32(4바이트)로 저장된다
    print(f"r={r:>2}: {n:>12,}개  예상 {n * 4 / 1024**2:6.2f} MB")
# 결과: r=4 는 2,199,552개 8.39 MB, r=16 은 8,798,208개 33.56 MBr= 4: 2,199,552개 예상 8.39 MB
r= 8: 4,399,104개 예상 16.78 MB
r=16: 8,798,208개 예상 33.56 MB
r=32: 17,596,416개 예상 67.12 MB2단계. Qwen 을 CPU 에 불러오기
모델은 하나만 올립니다. 붙였다 떼기만 하므로 GPU 없이 CPU 로 충분합니다.
import gc
import os
import shutil

import torch
# AutoModelForCausalLM = 다음 낱말 맞히기(causal language model)용 모델을 불러오는 도구
from transformers import AutoModelForCausalLM
from peft import LoraConfig, get_peft_model

torch.manual_seed(42)   # LoRA 의 A 를 무작위로 채우므로 씨앗을 준다(크기에는 영향 없음)
MODEL_NAME = "Qwen/Qwen2.5-0.5B-Instruct"
# from_pretrained = 이미 학습된 가중치에서 불러오기. dtype=BF16(숫자 하나에 2바이트)
# device 를 정하지 않으면 CPU 에 올라간다
model = AutoModelForCausalLM.from_pretrained(MODEL_NAME, dtype=torch.bfloat16)
# numel() = number of elements(원소 수)
base_params = sum(p.numel() for p in model.parameters())
# 결과: 기반 모델 파라미터: 494,032,768개, 장치: cpu
print(f"기반 모델 파라미터: {base_params:,}개, 장치: {model.device}")기반 모델 파라미터: 494,032,768개, 장치: cpu3단계. r 을 바꿔 가며 붙였다 떼기
같은 안경테에 두께가 다른 렌즈를 차례로 끼워 보고, 렌즈 무게(파일 크기)를 잰 뒤 다시 뺍니다.
LORA_TARGETS = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]
rows = []   # r 마다 결과를 사전으로 모은다(나중에 DataFrame 의 행)

for r in R_VALUES:
    # alpha 는 2 * r 로 두어 배율(alpha ÷ r)을 2 로 맞춘다
    config = LoraConfig(r=r, lora_alpha=2 * r, lora_dropout=0.05,
                        target_modules=LORA_TARGETS, task_type="CAUSAL_LM")
    peft_model = get_peft_model(model, config)          # 필름 붙이기
    # (학습 파라미터 수, 전체 파라미터 수)
    trainable, total = peft_model.get_nb_trainable_parameters()

    # 어댑터를 저장해 실제 파일 크기를 잰 뒤, 폴더는 지운다
    save_dir = f"out_ch08_adapter_r{r}"
    peft_model.save_pretrained(save_dir)
    file_mb = os.path.getsize(os.path.join(save_dir, "adapter_model.safetensors")) / 1024**2
    shutil.rmtree(save_dir)

    rows.append({"r": r, "학습 파라미터": trainable, "전체 파라미터": total,
                 "비율(%)": round(trainable / total * 100, 4), "실제 파일(MB)": round(file_mb, 2)})
    print(f"r={r:>2}: 학습 {trainable:,}개 / 전체 {total:,}개, 파일 {file_mb:.2f} MB")

    model = peft_model.unload()   # 필름을 떼고 원래 모델로 되돌린다(다음 r 을 위해)
    del peft_model
# 결과: r=16 에서 학습 8,798,208개 / 전체 502,830,976개, 파일 33.60 MB (실습 4와 같은 크기)r= 4: 학습 2,199,552개 / 전체 496,232,320개, 파일 8.43 MB
r= 8: 학습 4,399,104개 / 전체 498,431,872개, 파일 16.82 MB
r=16: 학습 8,798,208개 / 전체 502,830,976개, 파일 33.60 MB
r=32: 학습 17,596,416개 / 전체 511,629,184개, 파일 67.17 MB4단계. 표로 정리하고 손계산과 대조하기
측정값과 손계산 값을 한 표에 나란히 놓고, 같은지 열 하나로 확인합니다.
import pandas as pd

sizes = pd.DataFrame(rows)
# 1단계의 손계산 값과 예상 MB 를 열로 붙인다
sizes["손계산"] = sizes["r"].apply(lora_count_by_hand)
sizes["일치"] = sizes["학습 파라미터"] == sizes["손계산"]
sizes["예상(MB)"] = (sizes["손계산"] * 4 / 1024**2).round(2)
# r=16 을 기준(1.0)으로 몇 배인지
sizes["r=16 대비"] = sizes["학습 파라미터"] / sizes.loc[sizes["r"] == 16, "학습 파라미터"].iloc[0]

cols = ["r", "학습 파라미터", "손계산", "일치", "비율(%)", "예상(MB)", "실제 파일(MB)", "r=16 대비"]
print(sizes[cols].to_string(index=False))
# utf-8-sig: 엑셀에서 열어도 한글이 깨지지 않게 저장
sizes[cols].to_csv("out_ch08_lora_sizes.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch08_lora_sizes.csv")
# 결과: 네 행 모두 일치 True, r=16 대비 0.25, 0.5, 1.0, 2.0 r 학습 파라미터 손계산 일치 비율(%) 예상(MB) 실제 파일(MB) r=16 대비
4 2199552 2199552 True 0.4433 8.39 8.43 0.25
8 4399104 4399104 True 0.8826 16.78 16.82 0.50
16 8798208 8798208 True 1.7497 33.56 33.60 1.00
32 17596416 17596416 True 3.4393 67.12 67.17 2.00
저장: out_ch08_lora_sizes.csv5단계. 모델 내리고 메모리 돌려주기
쓴 도구는 제자리에 둡니다. 다른 실습이 메모리를 쓸 수 있도록 모델을 지웁니다.
del model                 # 모델을 가리키는 이름을 지운다
gc.collect()              # 이름이 없어진 객체의 메모리를 돌려받는다
print("모델을 내렸습니다.")모델을 내렸습니다.네 r 모두 실제 학습 파라미터 수가 손계산과 한 자리도 다르지 않습니다. r 을 두 배로 하면 학습 파라미터는 정확히 두 배, 어댑터 파일도 거의 두 배가 됩니다. 실제 파일이 예상보다 조금(0.04~0.05 MB) 큰 것은 safetensors 파일에 층 이름 같은 머리 정보가 함께 들어가기 때문입니다. r = 32 로 올려도 학습 비율은 3.4% 남짓이고 어댑터는 70 MB 를 넘지 않으므로, 업무 세 개에 어댑터를 따로 두어도 기반 모델 한 벌(BF16 약 1GB)보다 작습니다. 다만 r 이 크다고 늘 더 잘 배우는 것은 아닙니다. 데이터가 적으면 과적합만 빨라질 수 있으므로, 처음에는 r = 16 으로 시작해 검증 손실을 보며 고칩니다.