8장. PEFT와 LoRA 학습
실습 3 — SFTTrainer 로 LoRA 학습하기
앞에서 생성에 쓴 모델을 정리하고 새 모델을 불러온 뒤, SFTConfig 와 SFTTrainer 로 LoRA 학습을 실제로 돌립니다. RTX 3080 에서 약 3분 걸렸습니다. 실습 1의 lora_config 와 7장의 persona_ds 를 그대로 씁니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 위에서 아래로 화살표를 따라 읽습니다.
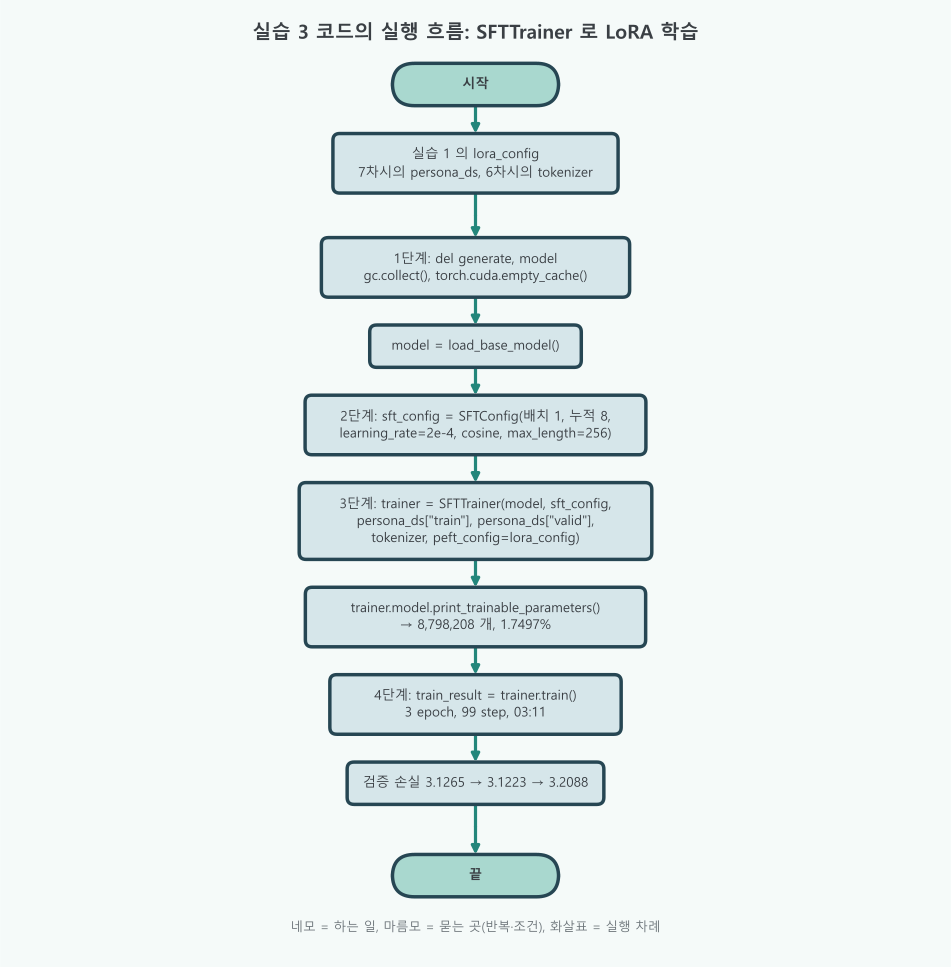
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 앞 모델을 지우고 새 기반 모델 불러오기 | 없음 | model = load_base_model() |
| 2 | 학습 설정표 만들기 | 없음 | gradient_accumulation_steps=8 |
| 3 | 모델, 설정, 데이터, LoRA 설정을 Trainer 에 넘기기 | 없음 | peft_config=lora_config |
| 4 | 학습 실행 | Trainer 가 안에서 도는 반복: 3 epoch × 33 step = 99 step | train_result = trainer.train() |
- 네모 하나에 숨은 반복: 4단계의
trainer.train()한 줄 안에서 "배치 읽기 → 손실 계산 → LoRA 고치기"가 99번 돕니다. 이 반복은 Trainer 가 안에서 도는 것이고 코드에는 보이지 않으므로, 그림에는 네모 하나로 그렸습니다. - 99 의 손계산: 실질 배치는 1 × 8 = 8 개이고, 263 ÷ 8 = 32.875 를 올림하면 epoch 하나에 33 step 입니다. 3 epoch 이면 33 × 3 = 99 step 이고, 출력의
[99/99 03:11, Epoch 3/3]과 같습니다. - 1단계가 먼저인 까닭: 지우고(
del), 정리하고(gc.collect()), 캐시를 비운(empty_cache()) 뒤에 불러와야 GPU 에 모델이 두 벌 올라가지 않습니다. - 끝부분: 마지막 네모의 검증 손실 3.1265 → 3.1223 → 3.2088 은 3 epoch 에 다시 오릅니다. 실습 4에서 그래프로 확인합니다.
1단계. 모델 새로 불러오기
조리를 시작하기 전에 도마를 깨끗이 닦는 단계입니다. 실습 1에서 붙였다 뗀 모델과 6장의 생성 파이프라인을 지우고, 깨끗한 기반 모델을 다시 불러옵니다.
# 앞에서 생성에 사용한 모델을 정리하고 학습할 모델을 새로 불러옵니다.
# SFTConfig = SFT 학습 설정표, SFTTrainer = supervised fine-tuning trainer(모범 답안 학습 담당)
from trl import SFTConfig, SFTTrainer  # SFT 학습 설정과 Trainer를 불러옵니다.

# generate: 6차시 셀 11의 생성 파이프라인. 모델을 붙잡고 있으므로 함께 지운다
del generate, model  # 기존 모델과 생성 파이프라인에 대한 참조를 삭제합니다.
gc.collect()  # 더 이상 참조하지 않는 파이썬 객체를 정리합니다.
# empty_cache(): PyTorch 가 잡아 두었던 빈 GPU 메모리를 돌려준다
torch.cuda.empty_cache()  # 새 모델을 불러오기 전에 사용하지 않는 GPU 캐시를 비웁니다.
# load_base_model(): 6차시 셀 6의 함수. Qwen 을 BF16 으로 불러와 GPU 에 올린다
model = load_base_model()  # 학습할 새 기반 모델을 불러옵니다.
이 셀은 출력이 없습니다. del generate 에서 이름이 없다는 오류가 나면 6장 셀 11을 먼저 실행해 두었는지 확인합니다.
2단계. 학습 설정표 만들기
불 세기, 조리 시간, 한 번에 굽는 양을 적은 레시피 카드를 만드는 단계입니다.
# LoRA 학습에 사용할 배치 크기, 학습률, 평가 시점 등을 정합니다.
sft_config = SFTConfig(  # 첫 LoRA 학습의 실행 설정을 만듭니다.
    # output_dir: 학습 기록을 둘 폴더(save_strategy="no" 라 체크포인트는 남지 않는다)
    output_dir="outputs/persona-lora",  # 학습 결과를 저장할 경로입니다.
    # per_device_train_batch_size: GPU 하나가 한 번에 보는 학습 예시 수
    per_device_train_batch_size=1,  # 장치 하나에서 한 단계에 예시 1개를 학습합니다.
    # per_device_eval_batch_size: GPU 하나가 한 번에 보는 검증 예시 수
    per_device_eval_batch_size=1,  # 장치 하나에서 한 번에 예시 1개를 검증합니다.
    # gradient_accumulation_steps: 그래디언트를 8번 모아 한 번 고친다 → 실질 배치 1 × 8 = 8
    gradient_accumulation_steps=8,  # 8단계의 그래디언트를 모은 뒤 가중치를 한 번 업데이트합니다.
    # learning_rate: 한 걸음의 보폭. 2e-4 = 0.0002
    learning_rate=2e-4,  # LoRA 가중치의 학습률입니다.
    # lr_scheduler_type: 학습률을 코사인 곡선 모양으로 0 까지 줄인다
    lr_scheduler_type="cosine",  # 학습률을 줄이는 방식입니다.
    # warmup_ratio: 전체 99스텝의 5%(올림해서 5스텝) 동안 학습률을 0 에서 서서히 올린다
    warmup_ratio=0.05,  # 학습률을 서서히 올릴 구간입니다.
    # max_length: 이보다 긴 예시는 뒤를 자른다
    max_length=256,  # 템플릿 적용 후 최대 토큰 수입니다. 데이터 길이가 대부분 100토큰 안팎이라 여유 있게 잡았습니다.
    # completion_only_loss: 질문 토큰은 채점에서 뺀다(7차시의 labels -100 과 같은 일)
    completion_only_loss=True,  # 질문은 제외하고 답변 토큰에 대해서만 손실을 계산합니다.
    # eval_strategy: epoch 한 바퀴마다 검증 데이터 32개로 검증 손실을 잰다
    eval_strategy="epoch",  # 학습 데이터를 한 번 다 볼 때마다 검증 데이터를 평가합니다.
    # save_strategy: 중간 저장 안 함(어댑터는 실습 4에서 따로 저장)
    save_strategy="no",  # 중간 체크포인트는 저장하지 않습니다.
    # bf16 / fp16: 6차시에서 고른 MODEL_DTYPE 에 맞춘다. RTX 3080 은 BF16 → bf16=True
    bf16=MODEL_DTYPE == torch.bfloat16,  # MODEL_DTYPE이 BF16이면 BF16으로 계산합니다.
    fp16=MODEL_DTYPE == torch.float16,  # MODEL_DTYPE이 FP16이면 FP16으로 계산합니다.
)
# num_train_epochs 는 적지 않았으므로 기본값 3 을 쓴다
이 셀도 출력이 없습니다. 설정표만 만들고 학습은 아직 하지 않습니다.
3단계. 요리사에게 재료와 레시피 넘기기
모델, 레시피 카드, 재료(학습·검증 데이터), 손질 도구(토크나이저), 양념 위치(LoRA 설정)를 요리사 한 명에게 넘깁니다.
trainer = SFTTrainer(  # 모델·데이터·설정을 하나의 학습 객체로 묶습니다.
    # model: 1단계에서 새로 불러온 기반 모델
    model=model,  # LoRA를 붙일 기반 모델입니다.
    # args: 2단계의 설정표
    args=sft_config,  # 학습 설정입니다.
    # train_dataset: 7차시의 학습 데이터 263개(prompt·completion 꼴)
    train_dataset=persona_ds["train"],  # 학습 데이터입니다.
    # eval_dataset: 검증 데이터 32개
    eval_dataset=persona_ds["valid"],  # 검증 데이터입니다.
    # processing_class: 대본 양식 입히기와 토큰화를 맡을 토크나이저
    processing_class=tokenizer,  # 템플릿 적용과 토큰화를 수행합니다.
    # peft_config: 실습 1의 lora_config. SFTTrainer 가 get_peft_model 을 대신 부른다
    peft_config=lora_config,  # SFTTrainer가 LoRA를 붙입니다.
)
# 결과: trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.7497  (실습 1과 같다)
trainer.model.print_trainable_parameters() # LoRA 파라미터만 학습 대상인지 확인합니다.trainable params: 8,798,208 || all params: 502,830,976 || trainable%: 1.74974단계. 학습 실행
요리사가 조리를 시작합니다. 263개를 8개씩 33번, 세 바퀴 돌아 모두 99번 양념을 고칩니다.
# train(): 학습 반복을 돈다. epoch 마다 검증 손실을 재고 표로 찍는다
# 결과: [99/99 03:11, Epoch 3/3] 과 epoch 별 손실 표(학습 손실 3.09 → 2.42 → 1.87)
train_result = trainer.train() # LoRA 학습을 실행합니다.The tokenizer has new PAD/BOS/EOS tokens that differ from the model config and generation config. The model config and generation config were aligned accordingly, being updated with the tokenizer's values. Updated tokens: {'bos_token_id': None, 'pad_token_id': 151643}.
[99/99 03:11, Epoch 3/3]
Epoch Training Loss Validation Loss Entropy Num Tokens Mean Token Accuracy
1 3.090000 3.126545 3.579878 18743.000000 0.394123
2 2.422700 3.122271 3.140760 37486.000000 0.411854
3 1.868400 3.208835 3.013245 56229.000000 0.415372첫 줄의 "The tokenizer has new PAD/BOS/EOS tokens ..." 는 오류가 아니라 안내입니다. 토크나이저의 패딩 토큰 번호(151643)를 모델 설정에도 맞춰 적었다는 뜻입니다. 표의 Training Loss 는 학습 손실, Validation Loss 는 검증 손실, Mean Token Accuracy 는 답 토큰을 정확히 맞힌 비율, Num Tokens 는 지금까지 본 토큰 수입니다. Entropy 는 모델이 다음 토큰을 얼마나 망설였는지(작을수록 확신)를 나타냅니다. 학습 시간과 손실 값은 GPU 마다, 실행할 때마다 조금씩 달라집니다.
이 실습이 뜻하는 것
도마를 닦고(1단계), 레시피 카드를 쓰고(2단계), 요리사에게 재료를 넘기고(3단계), 조리를 맡긴(4단계) 일입니다. 여기서 레시피 카드가 sft_config, 요리사가 trainer, 조리 결과 기록이 train_result 와 trainer.state.log_history 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 모델 새로 불러오기 | 없음 | 깨끗한 기반 모델이 GPU 에 올라갔습니다 |
| 2. 설정표 | 없음 | 실질 배치 8, 학습률 2e-4, cosine, 3 epoch |
| 3. SFTTrainer | trainable params: 8,798,208 ... 1.7497 | SFTTrainer 가 실습 1과 같은 LoRA 를 붙였습니다 |
| 4. 학습 | [99/99 03:11, Epoch 3/3] 과 손실 표 | 99스텝을 약 3분에 마쳤습니다 |
한 줄로 줄이면, 전체의 1.75% 인 LoRA 만 99번 고쳐 학습 손실을 3.09 에서 1.87 로 내렸고, 검증 손실은 3 epoch 에 다시 올랐습니다.
코드 설명
del generate, model과torch.cuda.empty_cache()는 GPU 에 모델이 두 벌 올라가지 않게 합니다. 10GB GPU 에서는 이런 정리가 중요합니다.SFTConfig의per_device_train_batch_size=1과gradient_accumulation_steps=8이 실질 배치 8을 만듭니다. 263 ÷ 8 을 올림한 33이 epoch 하나의 스텝 수입니다.SFTTrainer(..., peft_config=lora_config)처럼 설정표만 넘기면 Trainer 가 LoRA 를 붙입니다. 실습 1에서 직접get_peft_model을 부른 것과 같은 결과(8,798,208 개)입니다.processing_class=tokenizer가prompt·completion대화를 Qwen 의 대본 양식으로 바꾸고,completion_only_loss=True가 답 부분만 채점하게 합니다.- 손실 표에서 학습 손실은 계속 내려가지만 검증 손실은 3.1265 → 3.1223 → 3.2088 로 3 epoch 에 올라갑니다. 실습 4에서 그래프로 확인합니다.