8장. PEFT와 LoRA 학습
LoRA 의 원리
벽에 걸린 큰 지도를 고친다고 해 봅시다. 지도에 바로 그리면 되돌릴 수 없습니다. 그래서 투명 필름을 한 장 덮고 그 위에만 새 길을 그립니다. 필름을 떼면 원래 지도가 그대로 나오고, 필름을 바꿔 끼우면 다른 용도의 지도가 됩니다. LoRA(Low-Rank Adaptation)가 이 필름입니다. 큰 가중치 W 는 그대로 두고, 학습으로 생기는 변화량만 작은 행렬 두 개(A, B)로 그립니다.
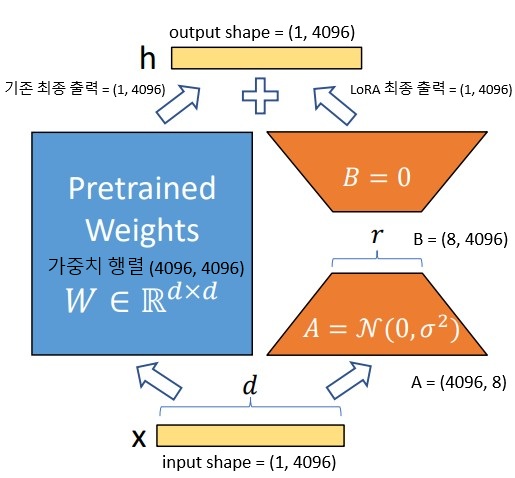
강사자료 그림을 아래에서 위로 읽습니다. 맨 아래 입력 x(1×4096)가 두 길로 갈라집니다. 왼쪽 파랑 상자가 원래 가중치 W(4096×4096)입니다. 오른쪽의 두 사다리꼴이 LoRA 입니다. 아래 사다리꼴 A 가 4096 칸을 r = 8 칸으로 줄이고, 위 사다리꼴 B 가 8 칸을 다시 4096 칸으로 늘립니다. 두 길의 결과를 맨 위에서 더한 것이 출력 h 입니다. 그림에서 B = 0 으로 적힌 것은 학습을 시작할 때 B 를 0 으로 채운다는 뜻이고, A 는 작은 무작위 값으로 채웁니다.
같은 흐름을 글자로 쓰면 이렇습니다. 노트북은 입력을 가로줄(행 벡터)로 놓고 씁니다.
y = x·W + (alpha / r) · x·A·B
기호와 코드
| 기호 | 뜻 | 크기(Qwen 의 q_proj) | 학습하나 | 코드 |
|---|---|---|---|---|
| W | 기존 가중치 | 896 × 896 | 동결 | 기반 모델의 q_proj |
| A | 입력 칸 수를 r 로 줄이는 행렬 | 896 × 16 | 학습 | lora_A |
| B | r 을 출력 칸 수로 늘리는 행렬 | 16 × 896 | 학습 | lora_B |
| r | 중간 차원(랭크) | 16 | 정하는 값 | r |
| alpha | LoRA 길의 배율을 정하는 값 | 32 → 배율 32 ÷ 16 = 2 | 정하는 값 | lora_alpha |
파라미터 수 손계산
LoRA 의 파라미터 수는 r × (입력 칸 수 + 출력 칸 수) 입니다.
| 경우 | 원래 W | A + B | 비율 |
|---|---|---|---|
| 강사자료 그림(4096×4096, r = 8) | 4096 × 4096 = 16,777,216 | 4096 × 8 + 8 × 4096 = 65,536 | 약 0.39% |
| Qwen 의 q_proj(896×896, r = 16) | 896 × 896 = 802,816 | 896 × 16 + 16 × 896 = 28,672 | 약 3.6% |
LoRA 의 좋은 성질
| 성질 | 까닭 | 지도로 치면 |
|---|---|---|
| 시작할 때 원래 모델과 똑같다 | B = 0 이므로 A·B = 0 | 아무것도 안 그린 빈 필름 |
| 병합하면 추론 속도가 그대로다 | W' = W + (alpha/r)·A·B 로 한 장이 된다 | 필름을 지도에 코팅 |
| 어댑터를 바꿔 끼울 수 있다 | 병합하지 않으면 A·B 만 따로 있다 | 용도별 필름 여러 장 |
짧은 예시
import numpy as np

rng = np.random.default_rng(42)       # 씨앗을 고정한 난수 생성기
d, r, alpha = 6, 2, 4                 # 작은 층: 입력·출력 6칸, 랭크 2, 배율 4/2 = 2
x = rng.normal(size=(1, d))           # 입력 한 줄(1×6)
W = rng.normal(size=(d, d))           # 얼려 둔 원래 가중치(6×6)
A = rng.normal(scale=0.01, size=(d, r))  # A: 작은 무작위 값(6×2)
B = np.zeros((r, d))                  # B: 0 으로 시작(2×6)

y_base = x @ W                                # 원래 길
y_lora = x @ W + (alpha / r) * (x @ A @ B)    # 원래 길 + LoRA 길
print(np.allclose(y_base, y_lora))            # 결과: True  (B = 0 이라 똑같다)

B = rng.normal(size=(r, d))                   # 학습으로 B 가 바뀌었다고 치자
y_lora = x @ W + (alpha / r) * (x @ A @ B)
print(np.allclose(y_base, y_lora))            # 결과: False (이제 답이 달라진다)

# 병합: W' = W + (alpha/r)·A·B 한 장으로 계산해도 같은 답
W_merged = W + (alpha / r) * (A @ B)
print(np.allclose(x @ W_merged, y_lora))      # 결과: True

# 파라미터 수 손계산
print(896 * 896, 896 * 16 + 16 * 896)         # 결과: 802816 28672
print(f"{(896 * 16 + 16 * 896) / (896 * 896):.1%}")  # 결과: 3.6%
이 코드가 뜻하는 것
6×6 짜리 작은 지도에 두께 2짜리 필름을 덮어 본 코드입니다. 빈 필름(B = 0)일 때는 원래 지도와 같고, 필름에 무언가를 그리면(B 가 바뀌면) 답이 달라지며, 필름을 코팅해 붙여도(병합) 답은 같습니다. 여기서 지도가 W, 필름이 A @ B 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
B = np.zeros((r, d)) | B 를 0 으로 채운다 | 빈 필름 |
x @ W + (alpha / r) * (x @ A @ B) | 두 길을 더한다 | 지도 + 필름 |
W + (alpha / r) * (A @ B) | 필름을 W 에 더해 한 장으로 | 코팅 |
896 * 16 + 16 * 896 | A 와 B 의 칸 수를 더한다 | 필름 두 장의 넓이 |
@ 는 행렬곱입니다. x @ A 가 (1×6)·(6×2) = 1×2 로 줄었다가, @ B 에서 (1×2)·(2×6) = 1×6 으로 다시 늘어납니다. 1장의 shape 규칙 그대로입니다.
주의할 점
- A 와 B 를 둘 다 0 으로 시작하면 그래디언트도 0 이 되어 학습이 되지 않습니다. 그래서 A 는 작은 무작위 값, B 는 0 으로 시작합니다.
- 노트북의 식은 입력을 가로줄로 놓은
x·A·B꼴입니다. 다른 글에서는 세로줄로 놓아W + BA로 쓰기도 합니다. 같은 내용을 쓰는 방향만 다릅니다. PyTorch 의lora_A는Linear(in_features=896, out_features=16)처럼 찍힙니다. - r 이 작을수록 변화량을 단순하게만 그릴 수 있습니다. 너무 작으면 배워야 할 것을 다 담지 못합니다.