7장. SFT 데이터 구성과 Chat Template
프로젝트 1 — 고객 문의를 SFT 데이터로 바꾸기
온라인 쇼핑몰 고객센터에서 일한다고 해 봅시다. 상담원마다 답변 형식이 달라 손님 문의를 정리하기 어렵습니다. 그래서 모든 답을 "분류 / 긴급도 / 답변" 세 줄 형식으로 쓰는 작은 상담 모델을 만들기로 했습니다. 지난 문의 100건(data/support_inquiries.csv)에는 문의, 분류(배송·교환·환불·결제·계정), 긴급도(낮음·보통·높음), 모범 답변이 있습니다. 이 표를 점검하고, 세 줄 형식의 completion 으로 바꿔 prompt-completion 데이터셋을 만들고, 분류마다 고르게 나눈 뒤, Chat Template 을 입혔을 때 토큰이 몇 개인지 잽니다. 학습은 하지 않으므로 CPU 로 끝납니다.
요구사항
data/support_inquiries.csv를 읽고 행 수, 빈값, 중복 문의, 분류별·긴급도별 건수, 답변 글자 수(최소, 가운데, 최대)를 찍습니다.- 행마다 completion 글을
분류: …,긴급도: …,답변: …세 줄로 만듭니다. - 분류마다 따로 섞어(
random_state=42) 10% 는 test, 10% 는 valid, 나머지는 train 으로 나누고, 묶음마다 분류별 건수를 찍습니다. - 실습 2 처럼 prompt-completion
DatasetDict를 만들고 train 첫 예시를 찍습니다. - Qwen 토크나이저로 Chat Template 을 입힌 뒤 질문 쪽, 답 쪽, 전체 토큰 수를 재고, 묶음별 평균과 최대를 찍습니다. 세 묶음을
out_ch07_support_train.jsonl,out_ch07_support_valid.jsonl,out_ch07_support_test.jsonl로, 길이 표를out_ch07_token_lengths.csv로 저장합니다.
힌트
- 분류별 건수는
value_counts().to_dict(), 글자 수 요약은str.len().agg(["min", "median", "max"])입니다. - 세 줄 글은 f-string 안에
\n을 넣어 만듭니다.df.apply(함수, axis=1)은 행마다 함수를 부릅니다. - 분류별로 나누려면
for category, group in df.groupby("category"):안에서 실습 2 와 같은 섞기·자르기를 하고, 마지막에pd.concat으로 붙입니다. - 질문 쪽 토큰 수는
apply_chat_template(prompt, tokenize=True, add_generation_prompt=True), 전체는apply_chat_template(prompt + completion, tokenize=True)의 길이입니다. 답 쪽은 둘의 차이입니다. - JSONL 은 한 줄에
json.dumps(예시, ensure_ascii=False)하나씩 씁니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 데이터 점검 | 행 수, 빈값, 중복, 분류·긴급도 분포, 답변 길이를 찍는다 | 20 |
| 세 줄 completion | 모든 행이 분류: / 긴급도: / 답변: 세 줄 꼴이다 | 20 |
| 분류별 나누기 | 묶음마다 다섯 분류가 같은 비율로 들어간다 | 20 |
| Dataset 만들기 | prompt·completion 열을 가진 DatasetDict 를 만든다 | 15 |
| 토큰 길이와 저장 | 질문·답·전체 토큰 수를 재고, JSONL 과 CSV 로 저장한다 | 25 |
코드의 흐름
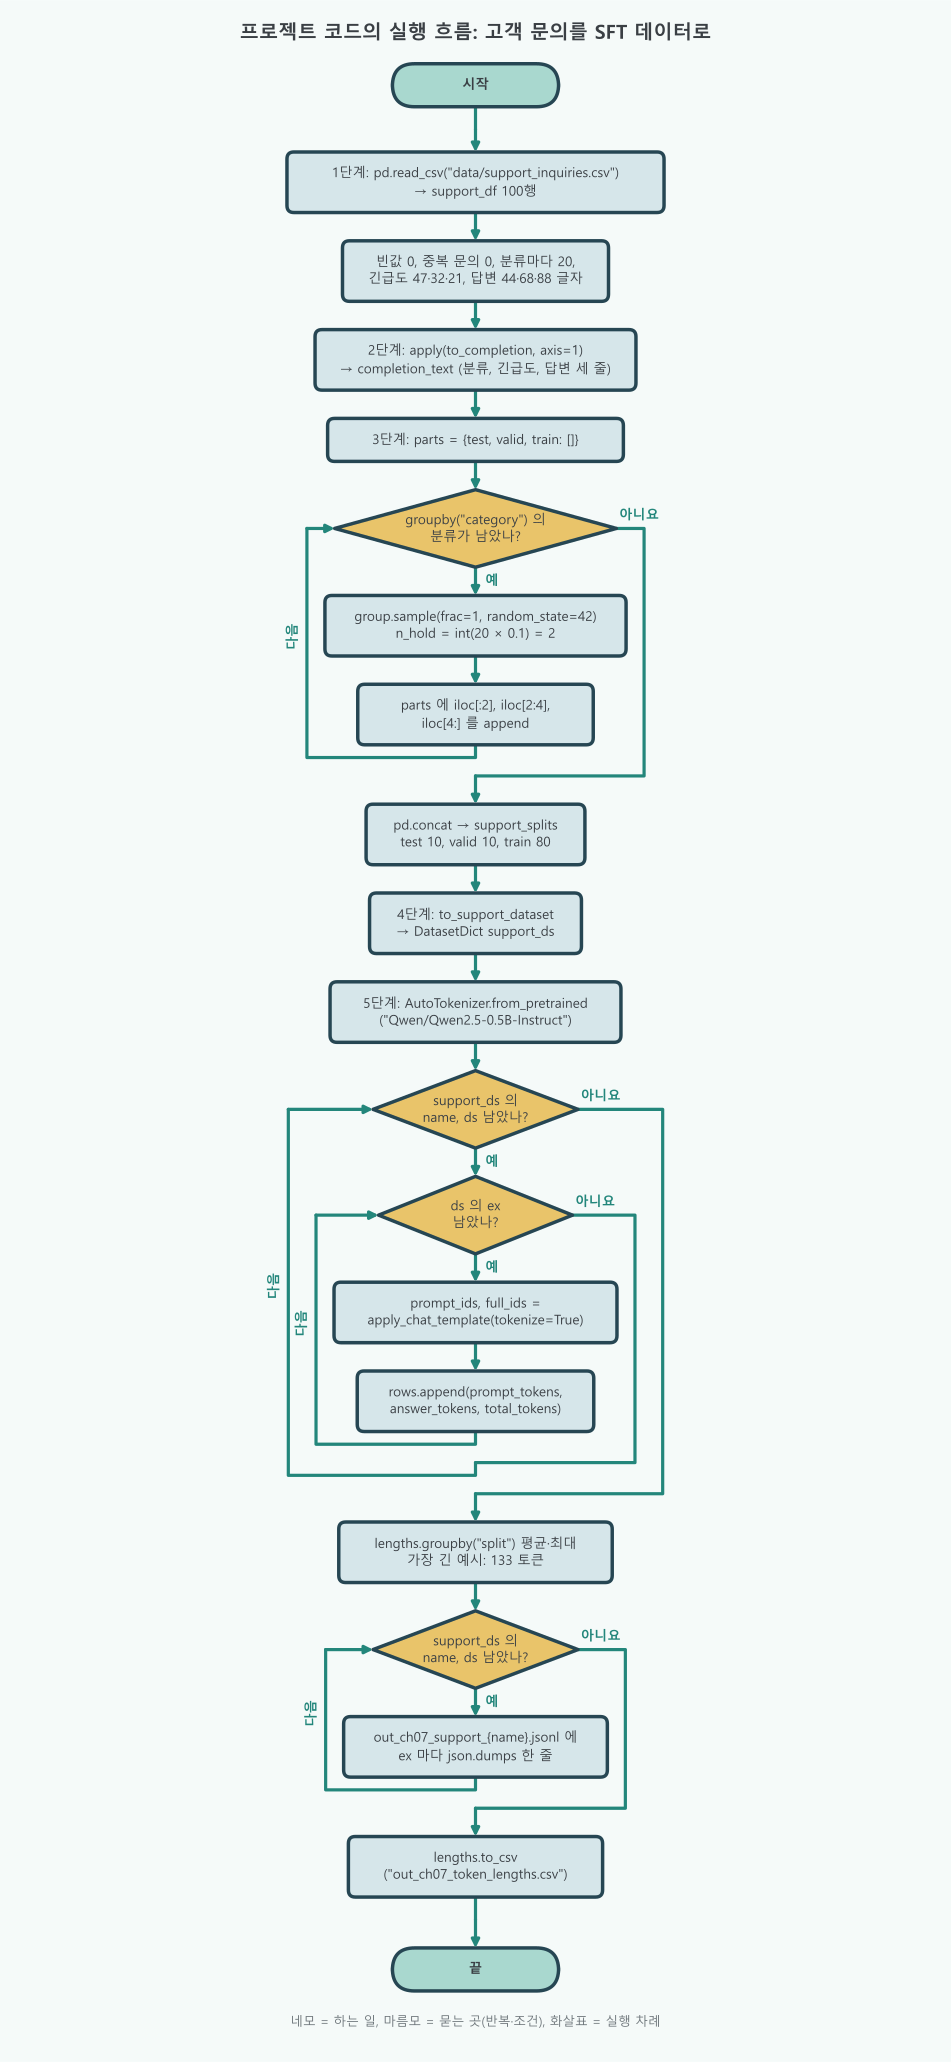
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 문의 표를 읽고 점검 | 없음 | support_df = pd.read_csv("data/support_inquiries.csv") |
| 2 | 세 줄 completion 만들기 | 코드에는 없음. apply(..., axis=1) 이 안에서 행마다 함수를 부른다 | support_df["completion_text"] = support_df.apply(to_completion, axis=1) |
| 3 | 분류마다 섞어 나누기 | for category, group in support_df.groupby("category") 다섯 바퀴 | parts["test"].append(shuffled.iloc[:n_hold]) |
| 4 | prompt-completion Dataset 만들기 | 묶음 세 개마다 to_support_dataset(실습 2 의 to_dataset 과 같은 꼴) | support_ds = DatasetDict({name: to_support_dataset(part) for name, part in support_splits.items()}) |
| 5 | 토큰 수 재고 저장 | for name, ds in support_ds.items() 안에 for ex in ds 를 둔 이중 반복이 두 번(재기, 저장) | full_ids = tokenizer.apply_chat_template(ex["prompt"] + ex["completion"], tokenize=True) |
- 흐름도 읽는 법: 실습 1 과 같습니다. 마름모에서 "예"로 내려가 일을 하고 다시 마름모로 돌아오는 고리가 반복문입니다.
- 3단계의 고리: 실습 2 는 표 전체를 한 번 섞어 잘랐지만, 여기서는 고리 안에서 분류마다 따로 섞어 자릅니다. 분류별로 20건씩이므로 손으로 계산하면
int(20 × 0.1)= 2 건이 test, 2 건이 valid, 20 − 4 = 16 건이 train 이고, 고리를 다섯 바퀴 돈 뒤pd.concat으로 합치면 10, 10, 80 건입니다. - 5단계의 이중 고리: 바깥 고리는 test, valid, train 세 바퀴이고, 안쪽 고리는 그 묶음의 예시 수(10, 10, 80)만큼 돕니다. 안쪽 고리는 모두 10 + 10 + 80 = 100 번 돌고, 한 번에
apply_chat_template을 두 번(질문 쪽, 전체) 부릅니다. 저장할 때도 같은 모양의 이중 고리를 한 번 더 돌며 한 줄에 예시 하나씩 씁니다.
결과 보기 (예시 풀이)
1단계. 문의 표 읽고 점검하기
import json
import pandas as pd

# 문의(inquiry), 분류(category), 긴급도(urgency), 모범 답변(answer) 네 열
support_df = pd.read_csv("data/support_inquiries.csv")
print("행 수:", len(support_df))
# 열마다 빈칸 수
print("빈값:", support_df.isna().sum().to_dict())
# 같은 문의가 두 번 들어 있는지
print("중복 문의:", support_df["inquiry"].duplicated().sum())
# value_counts: 값마다 몇 번 나왔는지(pandas 의 도수분포표)
print("분류별 건수:", support_df["category"].value_counts().to_dict())
print("긴급도별 건수:", support_df["urgency"].value_counts().to_dict())
print("답변 글자 수:", support_df["answer"].str.len().agg(["min", "median", "max"]).to_dict())행 수: 100
빈값: {'inquiry': 0, 'category': 0, 'urgency': 0, 'answer': 0}
중복 문의: 0
분류별 건수: {'배송': 20, '교환': 20, '환불': 20, '결제': 20, '계정': 20}
긴급도별 건수: {'낮음': 47, '보통': 32, '높음': 21}
답변 글자 수: {'min': 44.0, 'median': 68.0, 'max': 88.0}2단계. 세 줄 completion 만들기
def to_completion(row):
    # 행 하나를 "분류 / 긴급도 / 답변" 세 줄 글로 만든다. \n 은 줄바꿈
    return f"분류: {row['category']}\n긴급도: {row['urgency']}\n답변: {row['answer']}"

# apply(함수, axis=1): 행마다 함수를 불러 새 열을 만든다
support_df["completion_text"] = support_df.apply(to_completion, axis=1)
# 첫 행의 세 줄 글을 본다
print(support_df.loc[0, "completion_text"])분류: 배송
긴급도: 보통
답변: 불편을 드려 죄송합니다. 주문번호를 알려주시면 출고 지연 사유를 확인해 오늘 중으로 예상 발송일을 안내드리겠습니다.3단계. 분류마다 고르게 나누기
parts = {"test": [], "valid": [], "train": []}
# groupby("category"): 분류가 같은 행끼리 묶어 하나씩 꺼낸다(결제 20행, 계정 20행 …)
for category, group in support_df.groupby("category"):
    # 실습 2 와 같은 방법으로 분류 안에서 섞는다
    shuffled = group.sample(frac=1, random_state=42)
    # int(20 * 0.1) = 2
    n_hold = int(len(shuffled) * 0.1)
    parts["test"].append(shuffled.iloc[:n_hold])
    parts["valid"].append(shuffled.iloc[n_hold:2 * n_hold])
    parts["train"].append(shuffled.iloc[2 * n_hold:])

# pd.concat: 분류별 조각 다섯 개를 위아래로 붙여 표 하나로
support_splits = {name: pd.concat(frames).reset_index(drop=True) for name, frames in parts.items()}
for name, part in support_splits.items():
    # sort_index(): 분류 이름 차례로 늘어놓아 묶음끼리 견주기 쉽게 한다
print(name, len(part), part["category"].value_counts().sort_index().to_dict())test 10 {'결제': 2, '계정': 2, '교환': 2, '배송': 2, '환불': 2}
valid 10 {'결제': 2, '계정': 2, '교환': 2, '배송': 2, '환불': 2}
train 80 {'결제': 16, '계정': 16, '교환': 16, '배송': 16, '환불': 16}4단계. prompt-completion Dataset 만들기
from datasets import Dataset, DatasetDict

def to_support_dataset(df):
    # 실습 2 의 to_dataset 과 같은 꼴. 질문은 inquiry, 답은 세 줄 글
    records = [
        {"prompt": [{"role": "user", "content": q}], "completion": [{"role": "assistant", "content": c}]}
        for q, c in zip(df["inquiry"], df["completion_text"])
    ]
    return Dataset.from_list(records)

support_ds = DatasetDict({name: to_support_dataset(part) for name, part in support_splits.items()})
print(support_ds)
print(support_ds["train"][0])DatasetDict({
test: Dataset({
features: ['prompt', 'completion'],
num_rows: 10
})
valid: Dataset({
features: ['prompt', 'completion'],
num_rows: 10
})
train: Dataset({
features: ['prompt', 'completion'],
num_rows: 80
})
})
{'prompt': [{'role': 'user', 'content': '휴대폰 소액결제 한도가 초과됐다고 나와요.'}], 'completion': [{'role': 'assistant', 'content': '분류: 결제\n긴급도: 보통\n답변: 소액결제 한도는 통신사에서 설정합니다. 통신사 고객센터에서 한도를 확인하시거나 다른 결제 수단을 이용해 주세요.'}]}5단계. Chat Template 을 입혀 토큰 수 재고 저장하기
from transformers import AutoTokenizer

# 모델은 불러오지 않고 토크나이저만 불러온다(CPU 로 몇 초)
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")

rows = []
for name, ds in support_ds.items():
    for ex in ds:
        # 질문 쪽: system 기본 문구 + 질문 + assistant 머리표(추론 입력과 같은 모양)
        prompt_ids = tokenizer.apply_chat_template(ex["prompt"], tokenize=True, add_generation_prompt=True)
        # 전체: 질문 + 세 줄 답 + <|im_end|>(학습 입력과 같은 모양)
        full_ids = tokenizer.apply_chat_template(ex["prompt"] + ex["completion"], tokenize=True)
        rows.append({"split": name, "prompt_tokens": len(prompt_ids),
                     # 답 쪽 = 전체 - 질문 쪽. 학습 때 labels 가 -100 이 아닌 칸 수와 같다
                     "answer_tokens": len(full_ids) - len(prompt_ids),
                     "total_tokens": len(full_ids)})

lengths = pd.DataFrame(rows)
# 묶음별 평균과 최대. round(1): 소수 첫째 자리까지
print(lengths.groupby("split")[["prompt_tokens", "answer_tokens", "total_tokens"]].agg(["mean", "max"]).round(1))
print("가장 긴 예시:", lengths["total_tokens"].max(), "토큰")

# train 첫 예시가 실제로 어떤 대본이 되는지 본다
first = support_ds["train"][0]
print(tokenizer.apply_chat_template(first["prompt"] + first["completion"], tokenize=False))

# 묶음마다 JSONL 로 저장: 한 줄에 예시 하나
for name, ds in support_ds.items():
    with open(f"out_ch07_support_{name}.jsonl", "w", encoding="utf-8") as f:
        for ex in ds:
            f.write(json.dumps(ex, ensure_ascii=False) + "\n")
lengths.to_csv("out_ch07_token_lengths.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch07_support_train.jsonl, out_ch07_support_valid.jsonl, out_ch07_support_test.jsonl, out_ch07_token_lengths.csv") prompt_tokens answer_tokens total_tokens
mean max mean max mean max
split
test 46.1 53 60.6 63 106.7 116
train 46.6 62 62.8 75 109.4 133
valid 44.9 50 62.5 73 107.4 120
가장 긴 예시: 133 토큰
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
휴대폰 소액결제 한도가 초과됐다고 나와요.<|im_end|>
<|im_start|>assistant
분류: 결제
긴급도: 보통
답변: 소액결제 한도는 통신사에서 설정합니다. 통신사 고객센터에서 한도를 확인하시거나 다른 결제 수단을 이용해 주세요.<|im_end|>
저장: out_ch07_support_train.jsonl, out_ch07_support_valid.jsonl, out_ch07_support_test.jsonl, out_ch07_token_lengths.csv문의 100건은 빈칸과 중복이 없고 분류마다 20건씩 고르게 들어 있습니다. 분류별로 16·2·2 건씩 나누니 train 80, valid 10, test 10 건이 되었고, 묶음마다 다섯 분류가 같은 비율로 들어갔습니다. 세 줄 형식 답을 템플릿에 넣으면 예시 하나가 100 토큰 안팎이고 가장 긴 것도 133 토큰이라, 8장 학습에서 잘릴 걱정이 없습니다. 이 프로젝트의 요점은 "형식을 가르치려면 모든 답을 같은 형식으로 맞추고, 분류처럼 중요한 열은 묶음마다 고르게 나눈다"입니다. 긴급도는 분류만큼 고르지 않으므로(낮음 47, 보통 32, 높음 21) 더 꼼꼼히 하려면 분류와 긴급도를 함께 기준으로 나눕니다.