7장. SFT 데이터 구성과 Chat Template
실습 1 — 페르소나 데이터 불러와 점검하기
냉소적인 군주 말투의 질문·답변 327쌍을 읽고, 빈값과 중복, 답변 길이를 확인합니다. 6장의 준비 코드(셀 3, 6)를 먼저 실행해 둡니다. 셀 3 이 pd(pandas)와 json 을 불러옵니다. 작업 폴더는 workspace/ 입니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
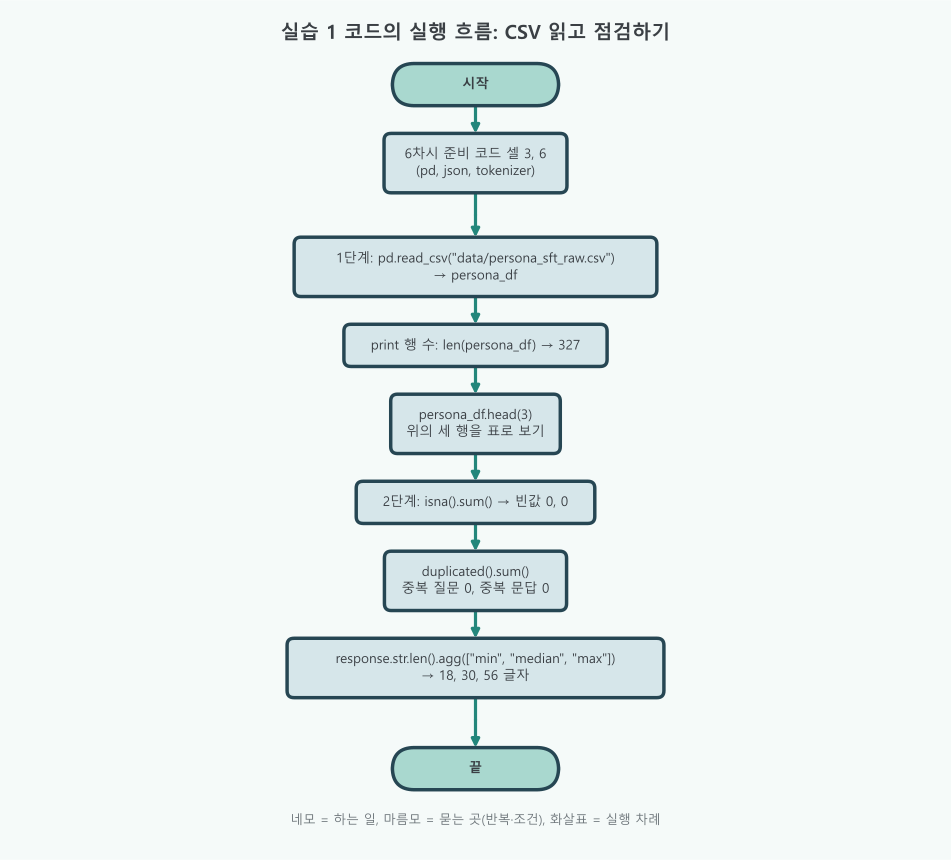
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | CSV 를 읽고 행 수와 앞 세 행 보기 | 없음 | persona_df = pd.read_csv("data/persona_sft_raw.csv") |
| 2 | 빈값, 중복, 답변 글자 수 점검 | 코드에는 없음. pandas 가 열 전체를 한 번에 계산 | persona_df["response"].str.len().agg(["min", "median", "max"]) |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 반복이 있는 실습에서는 마름모에서 "예"로 내려가 일을 하고, 화살표를 따라 다시 마름모로 돌아오는 고리가 반복문입니다. "아니요"면 고리를 빠져나와 다음 네모로 갑니다. 맨 위 네모는 먼저 실행해 둘 6장 준비 코드입니다.
- 마름모가 없는 까닭:
isna(),duplicated(),str.len()은 열 전체를 한 번에 계산합니다. 엑셀에서 수식을 열 끝까지 한 번에 채우는 것과 같아서, 코드에for문이 보이지 않습니다. - 끝부분: 1단계의 마지막 줄
persona_df.head(3)은print없이도 표가 찍힙니다. 2단계는 결과가 빈값 0, 중복 0, 글자 수 18·30·56 이면 다음 실습으로 넘어갑니다.
1단계. CSV 읽고 앞부분 보기
모범 답안 카드 묶음을 받아 몇 장인지 세고, 위의 세 장을 꺼내 봅니다.
# 질문과 모범 답변이 들어 있는 CSV 파일을 읽습니다.
# read_csv = CSV 파일을 DataFrame 으로 읽기. 열은 prompt(사용자 질문)와 response(모범 답변) 둘이다
persona_df = pd.read_csv("data/persona_sft_raw.csv")  # (질문, 답변) 데이터입니다.
# 결과: 행 수: 327
print("행 수:", len(persona_df))
# head(3): 위의 세 행. 셀의 마지막 줄이 식이므로 표가 그대로 찍힌다
# 결과: 0번 "다음 주 발표 때문에 너무 떨리는데 ..." / "떨고 있느냐. ..." 등 세 행
persona_df.head(3)행 수: 327
prompt \
0 다음 주 발표 때문에 너무 떨리는데 긴장 푸는 법 있어?
1 오늘 배운 거 요약 좀 해줄 수 있어?
2 주말에 차 막히니까 일찍 출발해야겠지?
response
0 떨고 있느냐. 네가 무슨 말을 하든 세상은 변하지 않는다. 아무도 네 말에 귀 기울...
1 앵무새처럼 되뇌어 봤자 네 것이 되지 않는다. 깨달음은 고뇌 속에 있다.
2 새벽부터 설치는 꼴이 우습구나. 그래봤자 도로 위다.2단계. 빈값, 중복, 답변 길이 점검하기
빈 카드, 겹친 카드가 없는지 보고, 답안이 얼마나 긴지 잽니다.
# isna().sum(): 열마다 빈칸 수. to_dict() 로 사전 꼴로 찍는다. 결과: {'prompt': 0, 'response': 0}
print("빈값:", persona_df[["prompt", "response"]].isna().sum().to_dict())
# duplicated(): 앞에 같은 값이 있으면 True. 질문만 같은 행 수. 결과: 0
print("중복 질문:", persona_df["prompt"].duplicated().sum())
# subset=[...]: 두 열이 모두 같은 행만 중복으로 본다. 결과: 0
print("중복 문답:", persona_df.duplicated(subset=["prompt", "response"]).sum())
print("답변 글자 수:")
# str.len(): 글자 수. agg(["min", "median", "max"]): 최솟값, 가운데 값, 최댓값을 한 번에
# 결과: min 18.0 / median 30.0 / max 56.0
print(persona_df["response"].str.len().agg(["min", "median", "max"]))빈값: {'prompt': 0, 'response': 0}
중복 질문: 0
중복 문답: 0
답변 글자 수:
min 18.0
median 30.0
max 56.0
Name: response, dtype: float64이 실습이 뜻하는 것
요리 전에 재료를 꺼내 개수를 세고, 상한 것과 같은 것이 두 번 들어 있지 않은지 본 일입니다. 327장 모두 빈칸이 없고 겹치는 카드도 없습니다. 답변은 18~56자로 고르게 짧아서, 너무 길어 잘리거나 너무 짧아 끝맺음을 못 배울 걱정이 적습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. CSV 읽기 | 행 수: 327 과 앞 세 행 | 질문과 냉소적인 답변 327쌍이 있습니다 |
| 2. 점검 | 빈값 0, 중복 0, 길이 18·30·56 | 깨끗하고 길이가 고른 데이터입니다 |
한 줄로 줄이면, 학습에 쓸 327쌍이 빈칸도 중복도 없이 짧고 고른 문답임을 확인했습니다.
코드 설명
pd.read_csv("data/persona_sft_raw.csv")는 작업 폴더workspace/기준 경로입니다.pd는 6장 셀 3 에서 불러온 pandas 입니다.- 셀의 마지막 줄
persona_df.head(3)은print없이도 노트북이 표를 보여 줍니다. 긴 답변은 화면 폭에 맞춰...로 잘려 보입니다. duplicated()는 첫 번째 것은 False 로 두고 두 번째부터 True 로 셉니다. 그래서 합이 "지워야 할 행 수"가 됩니다.agg(["min", "median", "max"])는 여러 요약값을 한 번에 구합니다. 평균 대신 가운데 값(median)을 보면 아주 긴 예시 몇 개에 덜 흔들립니다.