5장. Decoder-only LLM과 학습 단계
실습 1 — Qwen2.5-0.5B-Instruct 구조 들여다보기
가장 작은 Qwen 을 불러와 print(model) 로 부품 목록을 찍습니다. 앞의 "Qwen 설계도 읽기" 절의 표를 옆에 두고 줄마다 맞춰 봅니다. 작업 폴더는 workspace/ 이고, 첫 실행에는 모델(약 1GB)을 Hugging Face 에서 내려받습니다. 두 셀 모두 CPU 로도 돕니다.
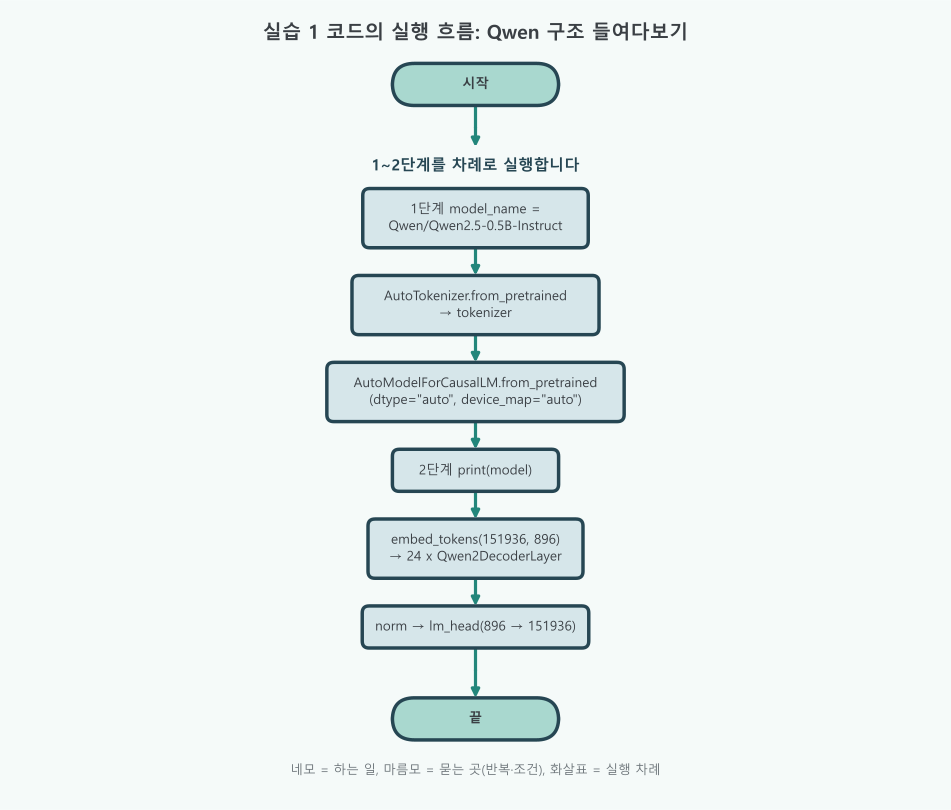
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 모델과 토크나이저를 불러온다 | 없음 | model = AutoModelForCausalLM.from_pretrained(model_name, dtype="auto", device_map="auto") |
| 2 | 모델 구조를 찍는다 | 없음 | print(model) |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 마름모에서 "예"로 내려가 일을 하고, 화살표를 따라 다시 마름모로 돌아오는 고리가 반복문입니다. 이 실습에는 마름모가 없어 한 줄기로 내려갑니다.
- 한 줄기 흐름: 2단계는 1단계의
model을 그대로 쓰므로 차례로 실행합니다. - 끝의 두 네모:
print(model)이 찍는 차례를 그대로 옮겼습니다. 24층은 같은 블록이라 출력에서도(0-23): 24 x Qwen2DecoderLayer로 한 번만 나옵니다.
1단계. 모델과 토크나이저 불러오기
설명서와 부품 상자를 함께 받아 오는 단계입니다. 토크나이저는 문장을 블록으로 쪼개는 도구, 모델은 블록을 보고 다음 블록을 맞히는 본체입니다.
# Qwen 모델과 토크나이저를 불러옵니다. 첫 실행에는 약 1GB를 다운로드합니다.
# AutoModelForCausalLM = 다음 낱말 맞히기(causal language model)용 모델을 이름만 보고 골라 불러오는 도구
# AutoTokenizer = 모델 이름만 주면 짝이 맞는 토크나이저를 골라 주는 도구
from transformers import AutoModelForCausalLM, AutoTokenizer  # 생성 모델과 토크나이저를 불러옵니다.

# Qwen = 알리바바 클라우드의 LLM, 2.5 = 세대, 0.5B = 파라미터 약 5억(billion 의 절반) 개, Instruct = 지시를 따르도록 추가 학습한 판
model_name = "Qwen/Qwen2.5-0.5B-Instruct"  # 사용할 Qwen 모델 이름입니다.

# from_pretrained = 이미 학습된(pretrained) 것을 Hugging Face 에서 내려받거나 캐시(~/.cache/huggingface)에서 불러오기
# 결과: 2차시에서 본 Qwen 의 BPE 토크나이저
tokenizer = AutoTokenizer.from_pretrained(model_name)  # Qwen 전용 토크나이저입니다.
# 결과: Qwen2ForCausalLM 객체. 처음 내려받을 때 내려받기 방식 안내 한 줄이 찍힐 수 있다
model = AutoModelForCausalLM.from_pretrained(  # 이미 학습된 Qwen 모델의 가중치를 불러옵니다.
    model_name,  # 위에서 지정한 Qwen 모델 이름을 전달합니다.
    # dtype="auto": config 에 적힌 정밀도(bfloat16, 숫자 하나에 2바이트)를 그대로 쓴다
    dtype="auto",  # 모델에 저장된 가중치의 숫자 정밀도를 자동으로 선택합니다.
    # device_map="auto": GPU 가 있으면 GPU 에, 없으면 CPU 에 올린다
    device_map="auto",  # 사용할 수 있는 CPU 또는 GPU에 모델을 자동으로 배치합니다.
)Xet Storage is enabled for this repo, but the 'hf_xet' package is not installed. Falling back to regular HTTP download. For better performance, install the package with: `pip install huggingface_hub[hf_xet]` or `pip install hf_xet`찍힌 한 줄은 오류가 아닙니다. 이 모델 저장소가 Xet 이라는 빠른 내려받기 방식을 지원하는데 hf_xet 패키지가 없어 보통 HTTP 로 내려받는다는 안내입니다. 모델은 정상으로 불러와집니다. 한 번 내려받아 캐시에 있으면 다음부터는 이 줄이 나오지 않을 수 있습니다.
2단계. print(model) 로 구조 보기
부품 상자를 열어 부품 목록을 처음부터 끝까지 읽는 단계입니다.
# print(model) = 모델 안의 층(모듈)을 나무 모양으로 찍기. 가중치 숫자는 찍지 않고 이름과 모양만 찍는다
# 결과: Qwen2ForCausalLM → model(embed_tokens, 24층, norm, rotary_emb) → lm_head 차례
print(model) # 모듈 구조를 그대로 출력합니다. 같은 층은 "(0-23)"처럼 한 번만 보여줍니다.Qwen2ForCausalLM(
(model): Qwen2Model(
(embed_tokens): Embedding(151936, 896)
(layers): ModuleList(
(0-23): 24 x Qwen2DecoderLayer(
(self_attn): Qwen2Attention(
(q_proj): Linear(in_features=896, out_features=896, bias=True)
(k_proj): Linear(in_features=896, out_features=128, bias=True)
(v_proj): Linear(in_features=896, out_features=128, bias=True)
(o_proj): Linear(in_features=896, out_features=896, bias=False)
)
(mlp): Qwen2MLP(
(gate_proj): Linear(in_features=896, out_features=4864, bias=False)
(up_proj): Linear(in_features=896, out_features=4864, bias=False)
(down_proj): Linear(in_features=4864, out_features=896, bias=False)
(act_fn): SiLUActivation()
)
(input_layernorm): Qwen2RMSNorm((896,), eps=1e-06)
(post_attention_layernorm): Qwen2RMSNorm((896,), eps=1e-06)
)
)
(norm): Qwen2RMSNorm((896,), eps=1e-06)
(rotary_emb): Qwen2RotaryEmbedding()
)
(lm_head): Linear(in_features=896, out_features=151936, bias=False)
)출력의 들여쓰기가 포함 관계입니다. Qwen2ForCausalLM 안에 model 과 lm_head 가 있고, model 안에 embed_tokens, layers, norm, rotary_emb 가 있습니다. (0-23): 24 x Qwen2DecoderLayer 는 같은 블록 24개를 한 번만 적은 것입니다. 노트북이 짚는 것처럼 Cross-Attention 에 해당하는 줄이 없습니다. Decoder-only 모델이기 때문입니다. 블록 안에서는 단어를 서로 잇는 Attention(self_attn)과 단어별 표현을 다듬는 FFN(mlp)이 함께 반복됩니다.
이 실습이 뜻하는 것
가구 상자를 받아(1단계) 부품 목록을 펼쳐 본(2단계) 일입니다. 부품 목록의 숫자 896, 128, 4864, 151936, 24 는 앞 절에서 설정표로 손계산한 숫자와 같습니다. 여기서 가구 상자가 model, 부품 목록이 print(model) 의 출력, 블록을 쪼개는 도구가 tokenizer 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 불러오기 | Xet 내려받기 안내 한 줄 | 모델을 내려받아 올렸습니다. 오류가 아닙니다 |
| 2. 구조 보기 | Embedding(151936, 896) | 토큰 151,936개 × 896칸 표 |
| 2. 구조 보기 | 24 x Qwen2DecoderLayer | 같은 Decoder 블록 24층 |
| 2. 구조 보기 | k_proj ... out_features=128 | Key·Value 머리 2개(GQA) |
| 2. 구조 보기 | gate/up/down_proj, SiLUActivation() | SwiGLU 방식의 FFN |
| 2. 구조 보기 | lm_head ... out_features=151936 | 다음 토큰 점수표 |
한 줄로 줄이면, Qwen 은 임베딩 표 하나, 같은 Decoder 블록 24층, 점수표 하나로 된 Decoder-only 모델이고, Cross-Attention 은 없습니다.
코드 설명
AutoTokenizer.from_pretrained(model_name)과AutoModelForCausalLM.from_pretrained(model_name, ...)은 이름 하나로 짝이 맞는 토크나이저와 모델을 불러옵니다. 첫 실행에만 내려받고 그다음부터는 캐시를 씁니다.dtype="auto"는 저장된 정밀도(bfloat16)를 그대로 써서 FP32 보다 메모리를 절반으로 줄입니다. 약 4.9억 개 × 2바이트 ≈ 0.99GB 입니다.device_map="auto"는 GPU 가 있으면 GPU 에 올립니다. 이 실습의 출력은 GPU 가 있는 PC 에서 찍었지만,print(model)의 모양은 CPU 에서도 같습니다.print(model)은 가중치 값이 아니라 층의 이름과 모양만 보여 줍니다. 같은 층은(0-23)처럼 묶어 한 번만 찍습니다.- 여기서 보는
q_proj,k_proj,v_proj,o_proj,gate_proj,up_proj,down_proj가 8장에서 LoRA 필름을 붙일 자리의 이름입니다.