5장. Decoder-only LLM과 학습 단계
GPT: Decoder 만 쌓은 언어 모델
받아쓰기 공책을 떠올려 봅니다. 선생님이 불러 주는 문장을 듣지 않고, 이미 쓴 앞부분만 보고 다음 글자를 이어 쓰는 연습만 한다고 해 봅시다. 원문을 따로 볼 필요가 없으니 "원문을 흘끗 보는" Cross-Attention 도 필요 없습니다. 2018년 OpenAI 의 GPT 는 4장의 Transformer 에서 이 Decoder 만 가져왔습니다. 입력 문장을 따로 인코딩하지 않으므로 Encoder 와 Cross-Attention 을 뺐습니다.
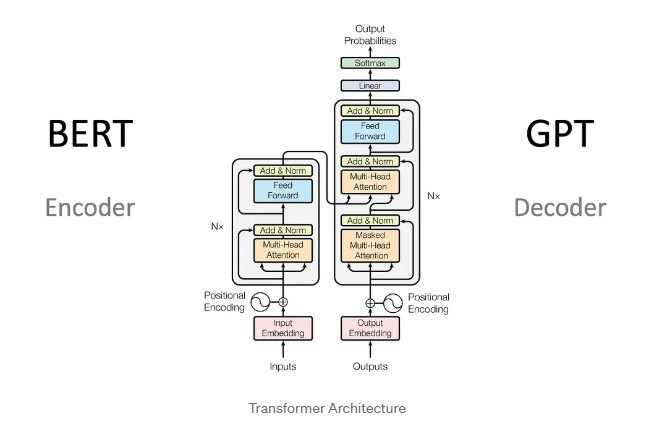
그림은 4장에서 본 Transformer 전체 구조입니다. 왼쪽 Encoder 탑만 쌓은 것이 3장의 BERT 이고, 오른쪽 Decoder 탑만 쌓은 것이 GPT 입니다. GPT 쪽에서는 Encoder 에서 넘어오던 화살표(Cross-Attention)가 빠지므로, 블록 안에는 Masked Self-Attention 과 FFN 만 남습니다.
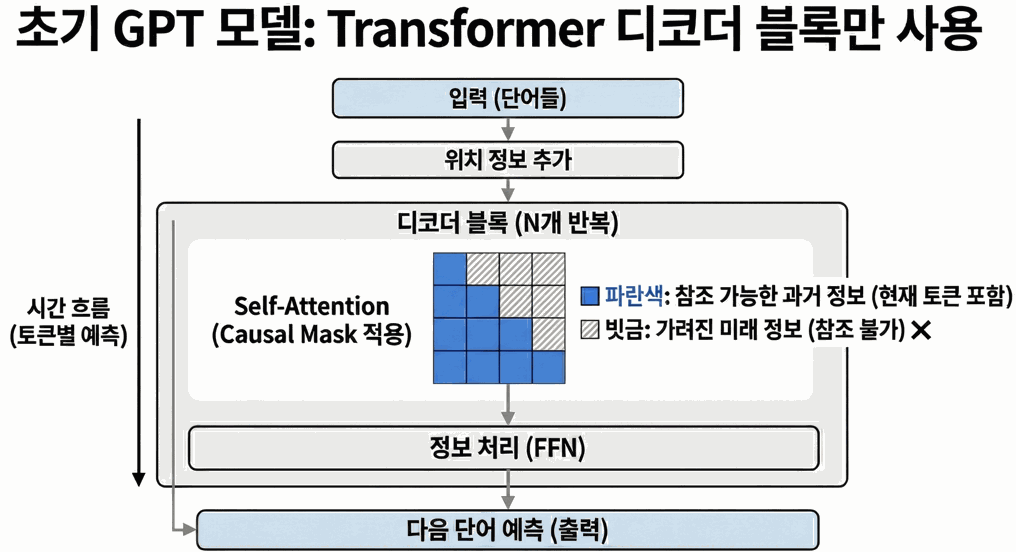
이 그림이 GPT 의 실제 모양입니다. 가운데 격자에서 파란 칸은 볼 수 있는 과거(자기 자신 포함), 빗금 칸은 가려진 미래입니다. 4장의 "시험 중 뒷장을 가리고 풀기"가 그대로 들어 있습니다. 이 블록을 N번 쌓고, 맨 위에서 다음 단어를 예측합니다.
GPT 가 배우는 것은 다음 토큰 예측 하나입니다. 노트북은 이것을 p(x_1, ..., x_T) = p(x_1) × p(x_2 | x_1) × ... × p(x_T | x_1...x_T-1) 로 적습니다. 문장 전체가 나올 확률을 "앞을 보고 다음을 맞힐 확률"의 곱으로 나눈다는 뜻입니다. 예를 들어 p(대한민국의) = 0.1, p(수도는 | 대한민국의) = 0.5, p(서울 | 대한민국의 수도는) = 0.9 라고 하면, 세 조각 문장의 확률은 0.1 × 0.5 × 0.9 = 0.045 입니다. 모델은 이 곱이 커지도록, 곧 각 위치에서 정답 토큰의 확률이 커지도록 학습합니다.
그림처럼 문장 하나에서 연습 문제가 여러 개 나옵니다. 사람이 정답을 달 필요가 없습니다. 텍스트 자체가 정답이므로 이것을 자기지도학습이라고 합니다. 번역, 요약, 질의응답도 모두 "이어질 텍스트 쓰기"로 바꿔 풀 수 있습니다. 예를 들어 번역은 "다음 문장을 영어로: 안녕하세요 →" 뒤를 이어 쓰는 문제가 됩니다.
세 가지 Transformer 비교
| 구분 | Encoder-only | Encoder-Decoder | Decoder-only |
|---|---|---|---|
| 대표 모델 | BERT(3장) | 원조 Transformer, 4장 번역기 | GPT, Qwen, Llama |
| 블록 안 | Self-Attention + FFN | Encoder 블록, Decoder 블록(Cross 포함) | Masked Self-Attention + FFN |
| Cross-Attention | 없음 | 있음 | 없음 |
| 잘하는 일 | 문장 이해, 분류 | 입력을 다른 출력으로 바꾸기 | 이어 쓰기, 생성 전반 |
| 학습 과제 | 가린 낱말 맞히기 | 원문을 보고 번역문 맞히기 | 다음 토큰 맞히기 |
짧은 예시
# AutoTokenizer = 모델 이름만 주면 짝이 맞는 토크나이저를 골라 주는 도구(모델은 불러오지 않는다)
from transformers import AutoTokenizer

# from_pretrained = 이미 만들어진(pretrained) 토크나이저를 캐시에서 불러오기
tok = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")

# 노트북의 예문을 토큰 ID(상품 번호) 리스트로 바꾼다
ids = tok("대한민국의 수도는 서울이다.")["input_ids"]
# decode([i]) = 번호 하나를 다시 글자로. 결과: 토큰 10개
print(len(ids), [tok.decode([i]) for i in ids])
# 결과: 10 ['대', '한', '민', '국', '의', ' 수도', '는', ' 서울', '이다', '.']

# 앞 t 개를 보고 t 번째(0부터) 토큰을 맞히는 문제를 만든다. 10개 토큰 → 문제 9개
for t in range(1, len(ids)):
    print(repr(tok.decode(ids[:t])), "->", repr(tok.decode([ids[t]])))
# 결과(9줄 중 끝의 세 줄):
# '대한민국의 수도' -> '는'
# '대한민국의 수도는' -> ' 서울'
# '대한민국의 수도는 서울' -> '이다'
이 코드가 뜻하는 것
받아쓰기 공책 한 줄을 연습 문제 아홉 개로 바꾼 코드입니다. 공책의 문장이 ids, 손으로 가린 앞부분이 ids[:t], 맞혀야 할 다음 글자가 ids[t] 입니다. 사람이 정답을 한 개도 달지 않았는데 문제와 정답이 함께 생겼습니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
tok("...")["input_ids"] | 문장을 토큰 번호 10개로 바꾼다 | 문장을 레고 블록 10개로 쪼개기 |
ids[:t] | 앞의 t 개만 남긴다 | 지금까지 쓴 부분 |
ids[t] | 바로 다음 토큰 | 손으로 가린 정답 |
for t in range(1, len(ids)) | t 를 1부터 9까지 바꾼다 | 문제 9개 만들기 |
노트북의 표처럼 낱말 단위로 끊기지 않고 '대', '한', '민', '국' 처럼 잘게 끊긴 것은 Qwen 의 BPE 토크나이저 때문입니다(2장). 실제 학습에서는 이 9개 문제를 한 번에(병렬로) 풉니다. 4장의 Causal Mask 가 각 위치에서 뒤를 가려 주기 때문입니다.
주의할 점
- Decoder-only 라고 Masked Self-Attention 이 빠진 것은 아닙니다. 빠진 것은 Cross-Attention 입니다. 실습의
print(model)출력에도 Cross-Attention 에 해당하는 줄이 없습니다. - 다음 토큰 예측은 "가장 그럴듯한 다음 토큰"을 배우는 것이지 "사실"을 배우는 것이 아닙니다. 그래서 그럴듯하지만 틀린 말(환각)을 할 수 있습니다.