5장. Decoder-only LLM과 학습 단계
프로젝트 1 — Qwen 설계도 읽기
회사에서 "우리 서버에 이 모델을 올릴 수 있나요?"라는 질문을 받았다고 해 봅시다. 답하려면 모델의 파라미터가 몇 개인지, 어느 부품에 몰려 있는지, 메모리가 얼마나 드는지 알아야 합니다. 설명서만 믿지 않고 부품을 하나하나 세어 표로 만들고, 손계산과 맞춰 봅니다. 모델은 CPU 에 올리고 생성은 하지 않으므로 GPU 가 없어도 됩니다.
요구사항
AutoModelForCausalLM.from_pretrained로Qwen/Qwen2.5-0.5B-Instruct를 CPU 에 불러오고, 정밀도, 장치, 층 수,lm_head가 임베딩 표를 함께 쓰는지 찍습니다.named_parameters()로 모든 파라미터의 이름, 모양, 개수를 DataFrame 으로 모으고, 이름을 보고 임베딩, Attention, FFN, Norm 네 묶음으로 나눕니다. 0번 층의 행을 찍습니다.- 묶음별 파라미터 수와 비율(%)을 표로 찍고, 합계가 494,032,768 인지 확인합니다. 표를
out_ch05_param_table.csv로 저장합니다. - 파라미터 수 × 바이트 수로 FP32, BF16, 4비트 메모리를 손계산하고,
get_memory_footprint()와 견줍니다. 끝나면del model로 메모리를 비웁니다.
힌트
device_map을 주지 않으면 모델은 CPU 에 올라갑니다.dtype="auto"를 주면 BF16 으로 올라가 메모리를 절반만 씁니다.- 이름에
embed_tokens가 있으면 임베딩,self_attn이면 Attention,mlp이면 FFN,norm이면 Norm 입니다. 마지막model.norm.weight도norm이 들어가므로 Norm 으로 셉니다. param.numel()은 텐서 안 숫자의 개수(number of elements)입니다. 묶음별 합은groupby("묶음")["개수"].sum()입니다.lm_head는 임베딩 표와 같은 텐서라서named_parameters()에 한 번만 나옵니다.model.lm_head.weight is model.model.embed_tokens.weight로 확인합니다.get_memory_footprint()는 파라미터에 버퍼(학습하지 않는 고정 값)까지 더한 바이트 수입니다. 차이가 나면model.buffers()를 세어 봅니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 모델 불러오기 | CPU 에 BF16 으로 불러오고 정밀도, 장치, 층 수, 임베딩 공유 여부를 찍는다 | 20 |
| 파라미터 모으기 | named_parameters() 로 이름, 모양, 개수를 DataFrame 으로 만들고 네 묶음으로 나눈다 | 25 |
| 묶음별 표 | 묶음별 개수와 비율을 찍고 합계 494,032,768 을 확인해 csv 로 저장한다 | 25 |
| 메모리 대조 | 세 정밀도의 메모리를 손계산하고 get_memory_footprint() 와의 차이를 설명한다 | 20 |
| 정리 | 끝에 del model 로 메모리를 비우고, 표를 읽은 결론을 한두 문장으로 쓴다 | 10 |
코드의 흐름
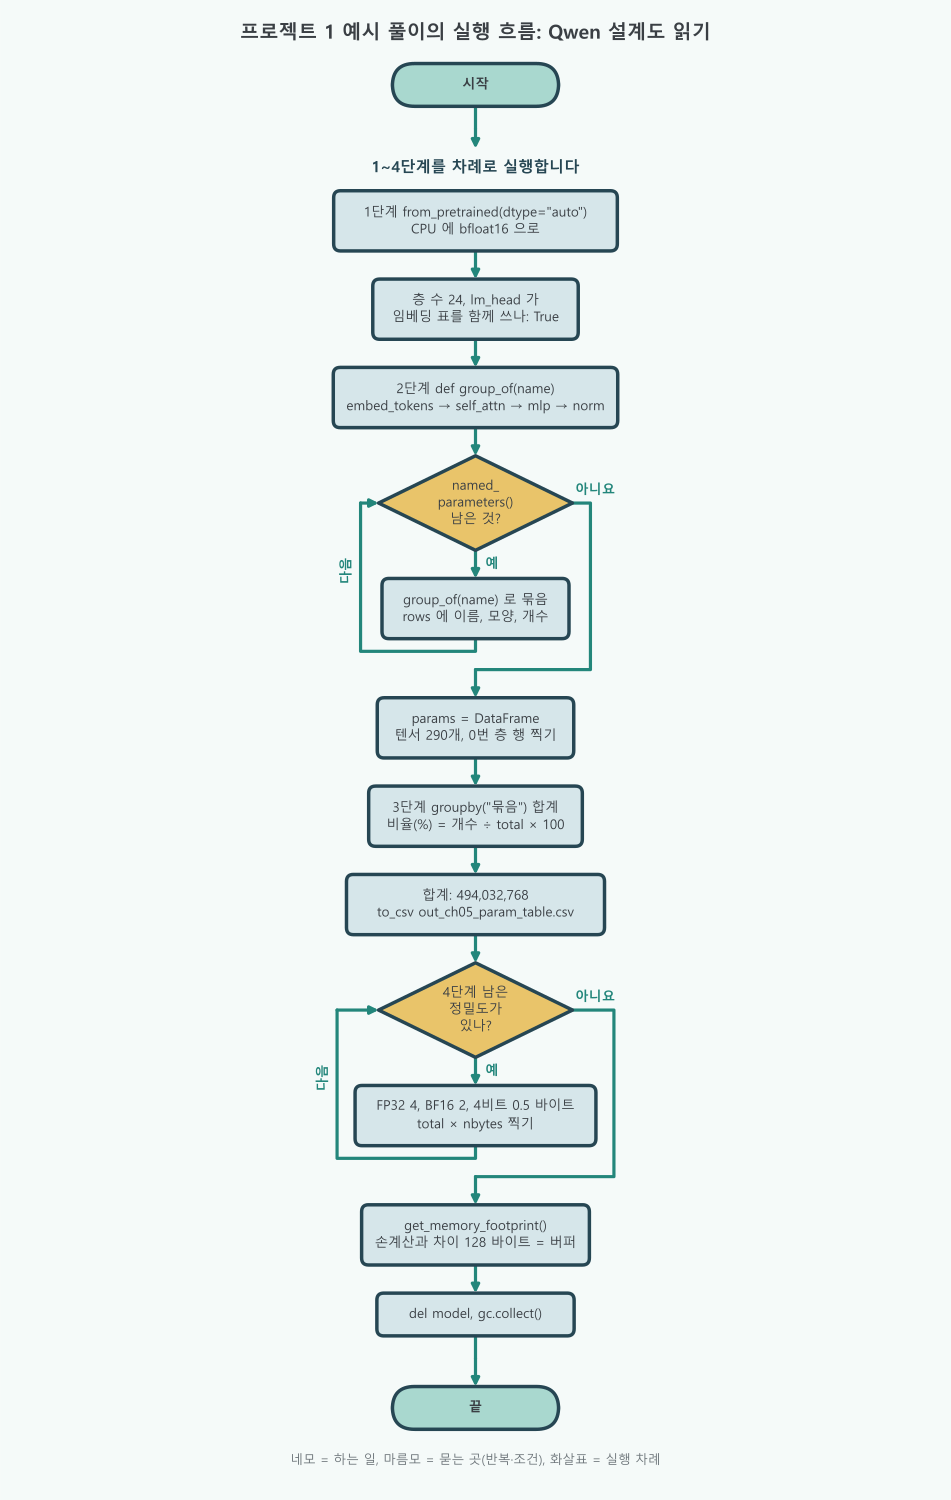
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | CPU 에 BF16 으로 불러와 정밀도, 장치, 층 수, 임베딩 공유를 찍는다 | 없음 | model = AutoModelForCausalLM.from_pretrained(model_name, dtype="auto") |
| 2 | 파라미터마다 이름, 묶음, 모양, 개수를 모은다 | 파라미터 텐서 290개를 도는 반복. 묶음은 group_of 의 if 네 개가 차례로 정한다 | for name, param in model.named_parameters(): |
| 3 | 묶음별 개수와 비율 표를 만들어 저장한다 | 없음 | params.groupby("묶음")["개수"].sum() |
| 4 | 메모리를 손계산해 실제 값과 견주고 모델을 지운다 | FP32, BF16, 4비트 세 정밀도를 도는 반복 | real = model.get_memory_footprint() |
- 한 줄기 흐름: 앞 단계의 변수(
model,params,total)를 뒤 단계가 그대로 쓰므로 1단계부터 차례로 실행합니다. - 2단계의 반복: 부품 상자에서 부품을 하나씩 꺼내 이름표를 보고 네 바구니에 나눠 담는 일입니다.
group_of안의if는 함수 안에 있으므로 그림에서는 네모 하나에 묻는 차례(embed_tokens → self_attn → mlp → norm)만 적었습니다. - 모델을 실행하지 않습니다: 이름표만 보고 분류하므로 모델에 문장을 넣어 계산하는 일은 없습니다. 그래서 CPU 로도 몇 초면 끝납니다.
- 끝부분: 손계산과 실제 값의 차이 128 바이트는 버퍼(RoPE 의 회전 주파수)입니다.
del model과gc.collect()로 메모리를 비우고 끝납니다.
결과 보기 (예시 풀이)
1단계. CPU 에 Qwen 불러오기
import pandas as pd
# AutoModelForCausalLM = 다음 낱말 맞히기용 모델을 이름만 보고 불러오는 도구
from transformers import AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
# device_map 을 주지 않으면 CPU 에 올라간다. dtype="auto" = 저장된 bfloat16 그대로
model = AutoModelForCausalLM.from_pretrained(model_name, dtype="auto")

print("정밀도:", model.dtype)                       # 결과: torch.bfloat16
print("장치:", model.device)                        # 결과: cpu
print("층 수:", model.config.num_hidden_layers)      # 결과: 24
# is = 같은 객체인지. True 면 lm_head 와 임베딩이 숫자 표 하나를 함께 쓴다
print("lm_head 가 임베딩 표를 함께 쓰나:", model.lm_head.weight is model.model.embed_tokens.weight)정밀도: torch.bfloat16
장치: cpu
층 수: 24
lm_head 가 임베딩 표를 함께 쓰나: True2단계. 이름표로 네 묶음 나누기
def group_of(name):
    # 파라미터 이름에 든 낱말로 묶음을 정한다(차례가 중요: norm 검사는 마지막)
    if "embed_tokens" in name:
        return "임베딩"
    if "self_attn" in name:
        return "Attention"
    if "mlp" in name:
        return "FFN"
    if "norm" in name:
        return "Norm"
    return "기타"

rows = []
# named_parameters() = (이름, 파라미터 텐서) 짝을 차례로 돌려준다
for name, param in model.named_parameters():
    # numel = number of elements(숫자 개수), shape = 모양
    rows.append({"이름": name, "묶음": group_of(name),
                 "모양": tuple(param.shape), "개수": param.numel()})
params = pd.DataFrame(rows)

print("파라미터 텐서 수:", len(params))
# 0번 층의 행만 골라 본다(층 하나의 부품 목록)
layer0 = params[params["이름"].str.startswith("model.layers.0.")]
print(layer0.to_string(index=False))파라미터 텐서 수: 290
이름 묶음 모양 개수
model.layers.0.self_attn.q_proj.weight Attention (896, 896) 802816
model.layers.0.self_attn.q_proj.bias Attention (896,) 896
model.layers.0.self_attn.k_proj.weight Attention (128, 896) 114688
model.layers.0.self_attn.k_proj.bias Attention (128,) 128
model.layers.0.self_attn.v_proj.weight Attention (128, 896) 114688
model.layers.0.self_attn.v_proj.bias Attention (128,) 128
model.layers.0.self_attn.o_proj.weight Attention (896, 896) 802816
model.layers.0.mlp.gate_proj.weight FFN (4864, 896) 4358144
model.layers.0.mlp.up_proj.weight FFN (4864, 896) 4358144
model.layers.0.mlp.down_proj.weight FFN (896, 4864) 4358144
model.layers.0.input_layernorm.weight Norm (896,) 896
model.layers.0.post_attention_layernorm.weight Norm (896,) 8963단계. 묶음별 개수와 비율 표
# 묶음별 합계를 큰 차례로. to_frame() = Series 를 표로
table = params.groupby("묶음")["개수"].sum().sort_values(ascending=False).to_frame()
total = int(table["개수"].sum())
# 비율 = 묶음 개수 ÷ 전체 × 100, 소수 둘째 자리
table["비율(%)"] = (table["개수"] / total * 100).round(2)

print(table.to_string(formatters={"개수": "{:,}".format}))
print(f"합계: {total:,}")
print("기타 묶음이 없나:", "기타" not in table.index)

# 층 하나 안에서의 비율도 본다
per_layer = layer0.groupby("묶음")["개수"].sum()
print("0번 층:", {k: f"{v:,}" for k, v in per_layer.items()})

# utf-8-sig = 엑셀에서 한글이 깨지지 않게 저장
table.to_csv("out_ch05_param_table.csv", encoding="utf-8-sig") 개수 비율(%)
묶음
FFN 313,786,368 63.52
임베딩 136,134,656 27.56
Attention 44,067,840 8.92
Norm 43,904 0.01
합계: 494,032,768
기타 묶음이 없나: True
0번 층: {'Attention': '1,836,160', 'FFN': '13,074,432', 'Norm': '1,792'}4단계. 메모리 손계산과 대조
import gc

# 메모리 = 파라미터 수 × 숫자 하나의 바이트 수
for label, nbytes in [("FP32", 4), ("BF16", 2), ("4비트", 0.5)]:
    print(f"{label}: {total:,} × {nbytes} = {total * nbytes / 1e9:.2f} GB")

# get_memory_footprint = 모델이 실제로 차지한 바이트(파라미터 + 버퍼)
real = model.get_memory_footprint()
by_hand = total * 2
# buffers() = 학습하지 않는 고정 값(RoPE 의 회전 주파수 등). element_size = 숫자 하나의 바이트
buffer_bytes = sum(b.numel() * b.element_size() for b in model.buffers())
print(f"실제: {real:,} 바이트, 손계산(BF16): {by_hand:,} 바이트, 차이: {real - by_hand} 바이트")
print(f"버퍼: {buffer_bytes} 바이트")

# 다른 장의 실습과 메모리를 나눠 쓰므로 모델을 지운다
del model
gc.collect()
print("모델을 메모리에서 지웠습니다.")FP32: 494,032,768 × 4 = 1.98 GB
BF16: 494,032,768 × 2 = 0.99 GB
4비트: 494,032,768 × 0.5 = 0.25 GB
실제: 988,065,664 바이트, 손계산(BF16): 988,065,536 바이트, 차이: 128 바이트
버퍼: 128 바이트
모델을 메모리에서 지웠습니다.표를 읽으면 결론은 둘입니다. 첫째, 파라미터의 가장 큰 몫은 FFN(63.52%)이고, 임베딩 표가 27.56%, Attention 은 8.92%, Norm 은 0.01% 입니다. 0.5B 처럼 작은 모델에서는 어휘가 15만 개나 되는 임베딩 표의 몫이 큽니다. 둘째, 메모리는 파라미터 수 × 바이트 수 손계산과 거의 같고, 차이 128바이트는 RoPE 의 회전 주파수 버퍼입니다. 서버에 올릴 수 있는지 물으면 "가중치만 BF16 으로 약 0.99GB, 생성과 학습에는 그보다 더 든다"고 답할 수 있습니다.