4장. Transformer Decoder와 작은 번역기
Masked Self-Attention: 뒷장을 가리고 풀기
시험지를 한꺼번에 나눠 주되, 지금 푸는 문제보다 뒤쪽은 종이로 가리게 하는 것이 Masked Self-Attention 입니다. 3번 문제를 푸는 학생은 1~3번까지만 볼 수 있고 4번은 못 봅니다. 모든 학생(위치)이 동시에 풀지만, 각자 자기 자리보다 뒤는 보지 못합니다.
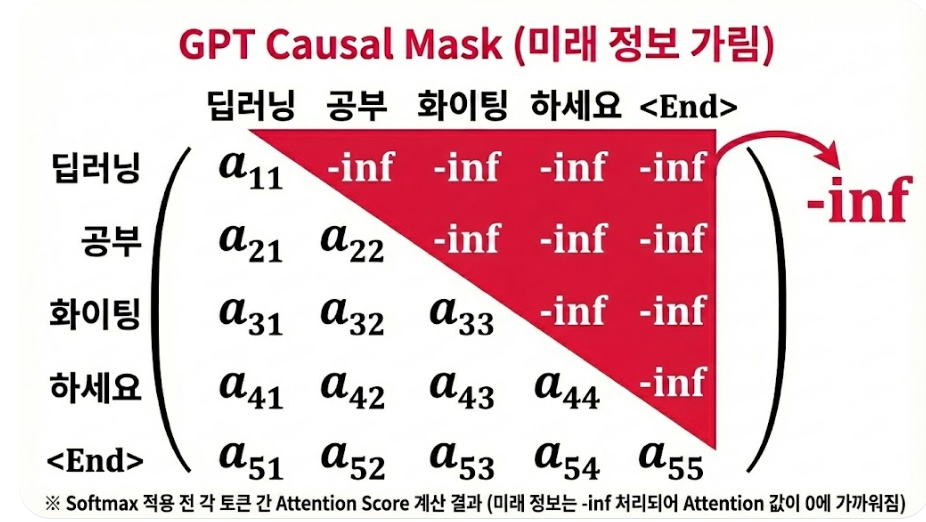
그림은 다섯 토큰 사이의 Attention 점수 표입니다. 행이 "지금 계산하는 위치(Query)", 열이 "참고하려는 위치(Key)"입니다. 대각선(자기 자신)과 그 아래 칸은 a₁₁, a₂₁ 처럼 점수가 그대로 남고, 대각선 위의 빨간 삼각형은 모두 -inf 입니다. "공부" 행은 "딥러닝"과 자기 자신만 보고, "화이팅" 이후는 못 봅니다. Softmax 를 거치면 -inf 칸의 가중치가 0 이 됩니다. 각 위치가 미래 정보 없이 다음 토큰을 예측하도록 배우는 이 방식을 자기회귀(auto-regressive)라고 합니다.
마스크가 있을 때와 없을 때
| 구분 | 마스크 없음(Encoder) | Causal Mask(Decoder) |
|---|---|---|
| 볼 수 있는 곳 | 문장 전체(앞뒤 모두) | 자기 자신과 앞쪽 |
| 점수 표의 모양 | 모든 칸이 살아 있음 | 아래 삼각형만 살아 있음 |
| 가린 칸의 값 | 없음 | 점수에 -inf 를 더함 |
| Softmax 뒤 가린 칸 | 해당 없음 | 0 |
| 쓰는 곳 | 문장 이해(BERT) | 문장 생성(GPT, 번역 Decoder) |
손으로 계산하기
세 토큰 <시작> 저는 학생 의 점수 표 셋째 행이 [2, 1, 0.1] 이라고 해 봅니다. 셋째 위치는 셋 다 볼 수 있으므로 1장의 Softmax 와 같습니다. e² ≈ 7.39, e¹ ≈ 2.72, e^0.1 ≈ 1.11 이고 합은 11.21 입니다. 각각 나누면 0.66, 0.24, 0.10 입니다. 둘째 행이 [1, 2, 0.1] 이면, 셋째 칸은 미래라서 0.1 대신 -inf 가 들어갑니다. e^-inf = 0 이므로 합은 2.72 + 7.39 = 10.11 이고, 가중치는 0.27, 0.73, 0 입니다. 첫째 행은 자기 자신만 남아 1, 0, 0 입니다.
짧은 예시
import numpy as np

# 세 위치(<시작>, 저는, 학생)의 Attention 점수 표. 행 = Query 위치, 열 = Key 위치
scores = np.array([[2.0, 1.0, 0.1],
                   [1.0, 2.0, 0.1],
                   [2.0, 1.0, 0.1]])

# np.triu = triangle upper(위쪽 삼각형). k=1 이면 대각선 바로 위부터 1, 나머지 0
# astype(bool): 1 → True(가릴 칸), 0 → False
mask = np.triu(np.ones((3, 3)), k=1).astype(bool)

# np.where(조건, 참일 때, 거짓일 때): 가릴 칸은 -inf, 아니면 원래 점수
masked = np.where(mask, -np.inf, scores)

# Softmax: e 의 거듭제곱을 행마다 합으로 나눈다. e^-inf = 0 이라 가린 칸은 0 이 된다
weights = np.exp(masked) / np.exp(masked).sum(axis=1, keepdims=True)
print(weights.round(2))
# 결과:
# [[1.   0.   0.  ]
#  [0.27 0.73 0.  ]
#  [0.66 0.24 0.1 ]]
이 코드가 뜻하는 것
점수표 위에 위쪽 삼각형 모양의 가림판을 얹고 Softmax 를 돌린 코드입니다. 가림판 아래의 점수는 아무리 커도 0 이 됩니다. 여기서 가림판이 mask, 가린 점수표가 masked, 행마다 합이 1인 비율표가 weights 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
np.triu(np.ones((3, 3)), k=1) | 대각선 위쪽만 1 인 표 | 가림판 오리기 |
np.where(mask, -np.inf, scores) | 가릴 칸을 -inf 로 | 뒷장에 종이 덮기 |
np.exp(...) / ....sum(axis=1, keepdims=True) | 행마다 Softmax | 행 합이 1인 비율표(df.div(df.sum(axis=1), axis=0)) |
손으로 계산한 0.27, 0.73 과 0.66, 0.24, 0.10 이 그대로 나옵니다. 셋째 행은 가린 칸이 없어 1장의 Softmax 결과와 같습니다.
주의할 점
- 마스크는 Softmax 앞에 씌웁니다. Softmax 뒤에 0 을 곱하면 행의 합이 1 보다 작아져 비율표가 깨집니다.
- 실제 라이브러리는 -inf 대신 아주 큰 음수(예: -1e9 나 자료형의 가장 작은 값)를 쓰기도 합니다. 모든 칸이 -inf 인 행이 생기면 0 ÷ 0 이 되어
nan이 나오기 때문입니다. - 패딩을 가리는
attention_mask와 미래를 가리는 Causal Mask 는 다른 가림판입니다. Decoder 에서는 둘을 함께 씁니다.