4장. Transformer Decoder와 작은 번역기
Decoder 가 하는 일과 Teacher Forcing
번역가가 영어 원문 I am a student 를 받아 한국어로 옮긴다고 해 봅시다. 원문 전체는 이미 다 읽었습니다(Encoder 의 일). 이제 "저는"을 쓰고, "저는"을 본 채로 "학생"을 쓰고, 또 그다음을 씁니다. Decoder 는 이렇게 한 낱말씩 써 나가는 쪽입니다. 그런데 처음 배우는 번역가에게 첫 낱말부터 혼자 쓰라고 하면, 첫 낱말이 틀리는 순간 뒤가 모두 엉망이 됩니다. 그래서 연습할 때는 앞 낱말의 정답을 보여 주고 다음 낱말만 맞히게 합니다. 이것이 Teacher Forcing 입니다.
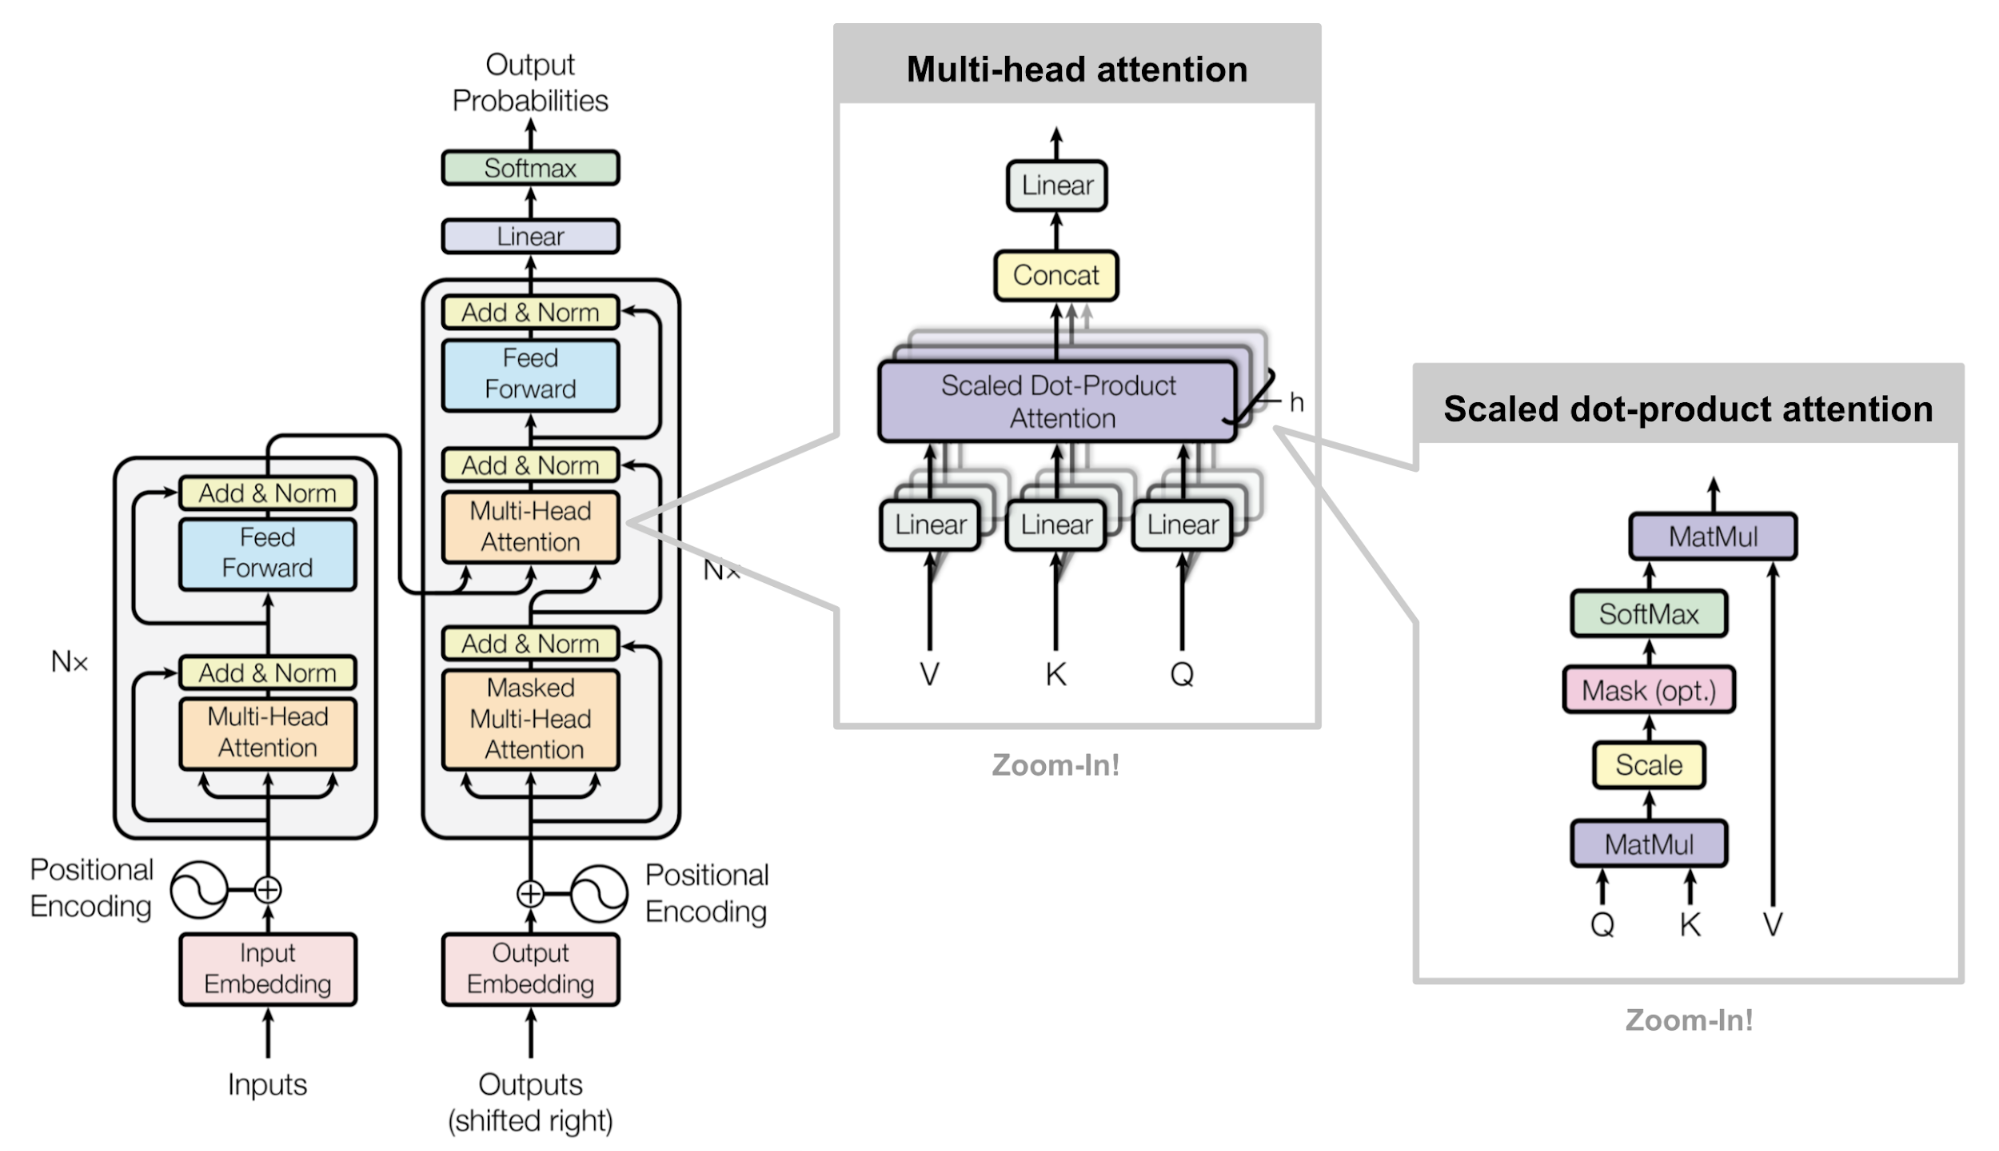
강사자료의 구조도입니다. 왼쪽 큰 그림의 오른쪽 기둥이 Decoder 입니다. 맨 아래 입력에 "Outputs (shifted right)"라고 적혀 있습니다. 출력 문장을 오른쪽으로 한 칸 밀어 넣는다는 뜻입니다. 오른쪽 끝의 확대 그림에는 "Mask (opt.)"라는 칸이 있습니다. Decoder 의 첫 Attention 에서 이 가림판을 씁니다.
이 장은 네 칸 가운데 셋째 칸인 Decoder 를 다룹니다. 1장의 전체 지도에서 지금 어디에 있는지 확인하는 그림입니다.
그림의 세 상자를 왼쪽부터 읽습니다. 정답 문장 저는 학생 입니다 <끝> 맨 앞에 <시작> 을 붙이고 맨 끝 하나를 떼면 Decoder 입력 <시작> 저는 학생 입니다 가 됩니다. 두 줄을 위아래로 겹쳐 놓으면, 입력의 각 칸 바로 아래에 "그다음 정답"이 옵니다.
위치마다 무엇을 보고 무엇을 맞히나
| 위치 | Decoder 입력(보이는 것) | 맞혀야 할 정답 |
|---|---|---|
| 1 | <시작> | 저는 |
| 2 | <시작> 저는 | 학생 |
| 3 | <시작> 저는 학생 | 입니다 |
| 4 | <시작> 저는 학생 입니다 | <끝> |
네 위치의 문제를 한 장의 시험지에 한꺼번에 낼 수 있습니다. 앞 위치의 답을 모델이 직접 만들 때까지 기다릴 필요가 없기 때문입니다. 그래서 학습이 빠릅니다. 단, 조건이 하나 있습니다. 위치 2에서 학생 을 맞혀야 하는데 입력에 학생 이 이미 보이면 커닝이 됩니다. 이 커닝을 막는 장치가 다음 절의 Masked Self-Attention 입니다.
짧은 예시
# 정답 문장(이미 토큰으로 나눴다고 친다)
answer = ["저는", "학생", "입니다", "<끝>"]

# shifted right: 맨 앞에 <시작> 을 넣고 맨 끝 하나(answer[-1])를 뺀다
decoder_input = ["<시작>"] + answer[:-1]

# zip 으로 두 줄을 위아래로 겹쳐 위치마다 짝을 짓는다
for pos, (seen, target) in enumerate(zip(decoder_input, answer), start=1):
    # decoder_input[:pos] = 그 위치까지 보이는 입력 전체
    print(pos, decoder_input[:pos], "→", target)
# 결과:
# 1 ['<시작>'] → 저는
# 2 ['<시작>', '저는'] → 학생
# 3 ['<시작>', '저는', '학생'] → 입니다
# 4 ['<시작>', '저는', '학생', '입니다'] → <끝>
이 코드가 뜻하는 것
받아쓰기 연습지를 만드는 코드입니다. 정답 줄을 한 칸 오른쪽으로 밀어 문제 줄을 만들고, 두 줄을 겹쳐 "여기까지 보고 다음을 맞혀 보세요"라는 문제 네 개를 냅니다. 여기서 정답지가 answer, 문제지가 decoder_input 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
["<시작>"] + answer[:-1] | 맨 앞에 시작 토큰, 맨 끝 하나 빼기 | 정답 줄을 한 칸 밀기 |
zip(decoder_input, answer) | 같은 위치끼리 짝짓기 | 문제와 정답을 위아래로 맞대기 |
decoder_input[:pos] | 그 위치까지의 입력 | 칠판에 적어 둔 앞 낱말들 |
pandas 로 치면 df["정답"].shift(1) 로 한 칸 내린 열을 만들고, 맨 위 빈칸을 <시작> 으로 채운 것과 같습니다. 실습 2의 DataCollatorForSeq2Seq 가 이 일을 숫자(토큰 ID)로 대신합니다.
주의할 점
- Teacher Forcing 은 학습할 때만 씁니다. 실제로 번역할 때는 정답이 없으므로 모델이 고른 토큰을 다음 입력으로 넣습니다. 그래서 학습 때는 한 번도 본 적 없는 "자기 실수"를 추론 때 처음 만나게 됩니다. 이 차이를 노출 편향(exposure bias)이라고 부릅니다.
- 실제 토크나이저는 낱말이 아니라 조각(
저,##는,학생,##입니다)으로 나눕니다. 위치 수는 낱말 수가 아니라 토큰 수입니다.