4장. Transformer Decoder와 작은 번역기
프로젝트 1 — 받아쓰기 연습지 만들기
초등학교 선생님이 받아쓰기 연습지를 만든다고 해 봅시다. 문장마다 "여기까지 보여 주고, 다음 낱말을 써 보세요" 문제를 한 줄씩 내고, 학생이 뒤쪽 정답을 보지 못하게 가림판도 준비합니다. 번역기의 Decoder 가 학습할 때 받는 것이 바로 이 연습지입니다. 실습 2에서는 DataCollatorForSeq2Seq 가 보이지 않게 만들어 준 연습지를, 이번에는 토크나이저와 NumPy 로 직접 만들고 라이브러리 결과와 맞춰 봅니다. 모델을 학습하지 않으므로 CPU 에서 몇 초 만에 끝납니다.
요구사항
tunib/electra-ko-en-small토크나이저로 한국어 정답 문장 세 개를text_target=으로 토큰화하고, 문장마다 토큰 수와 토큰 조각을 찍습니다.- 세 문장을 가장 긴 길이에 맞춰 NumPy 표로 만들고(빈칸은 -100), 정답을 오른쪽으로 한 칸 밀어 Decoder 입력을 만드는 함수
shift_right를 직접 씁니다. 첫 문장의 정답 줄과 입력 줄을 찍습니다. - 직접 만든 Decoder 입력이 transformers 의
shift_tokens_right결과와 같은지 확인합니다. - 문장마다 "위치, 보이는 입력, 맞힐 정답"을 한 행으로 하는 연습지 표를 만들어 첫 문장 부분을 찍습니다.
- 첫 문장 길이의 Causal Mask 를 NumPy 로 만들어 무작위 점수표에 씌우고 Softmax 를 돌립니다. 행 합이 모두 1이고 가린 칸의 합이 0 인지 확인한 뒤, 연습지를
out_ch04_dictation.csv로 저장합니다.
힌트
- 정답 문장만 토큰화할 때는
tokenizer(text_target=문장_리스트, truncation=True, max_length=32)["input_ids"]를 씁니다. - 한 칸 밀기는
dec[:, 1:] = labels[:, :-1]과dec[:, 0] = 시작_ID두 줄입니다. 밀려 들어온 -100 은[PAD](0)로 바꿉니다. shift_tokens_right는transformers.models.marian.modeling_marian에 있고(labels, pad_token_id, decoder_start_token_id)를 받습니다. 넘길 때는torch.tensor(...)로 감쌉니다.- 가림판은
np.triu(np.ones((L, L)), k=1).astype(bool), 씌우기는np.where(mask, -np.inf, scores)입니다. - 무작위 점수에는
np.random.default_rng(42)로 씨앗을 줍니다. csv 는 엑셀에서 한글이 깨지지 않게encoding="utf-8-sig"로 저장합니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 정답 토큰화 | 세 문장을 text_target= 으로 토큰화하고 토큰 수와 조각을 찍는다 | 15 |
| 한 칸 밀기 | shift_right 로 시작 토큰을 넣고 -100 을 패딩으로 바꾼 입력을 만든다 | 25 |
| 라이브러리와 대조 | shift_tokens_right 결과와 같음을 True 로 확인한다 | 15 |
| 연습지 표 | 위치마다 보이는 입력과 맞힐 정답을 DataFrame 으로 만든다 | 20 |
| 가림판과 저장 | Causal Mask 뒤 행 합 1, 가린 칸 합 0 을 확인하고 csv 로 저장한다 | 25 |
코드의 흐름
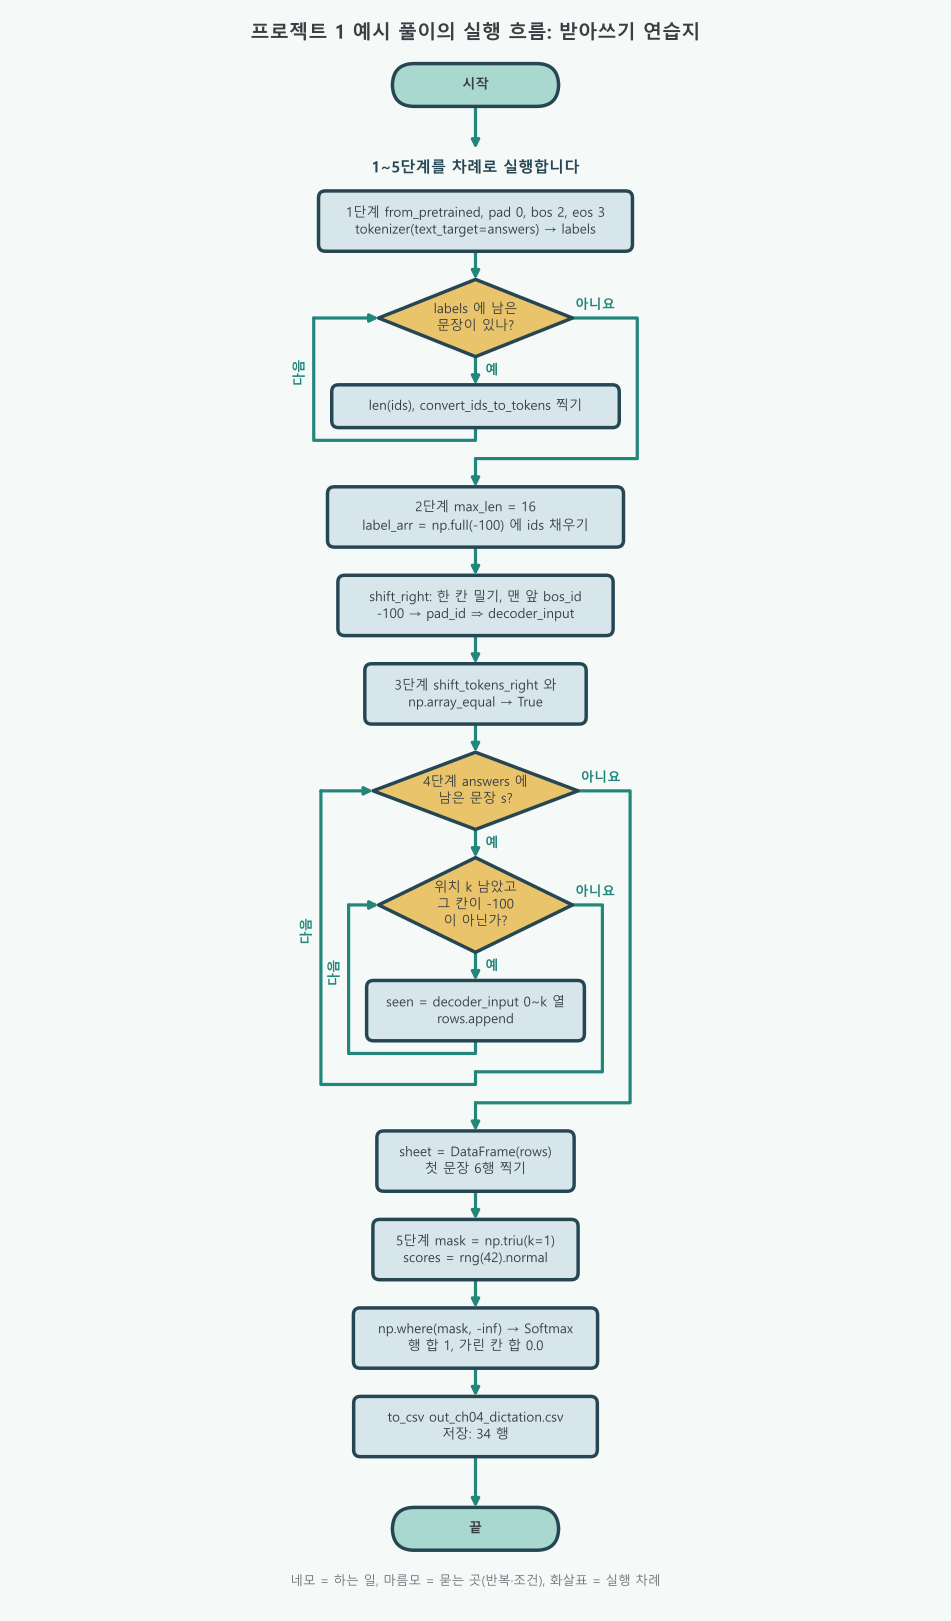
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 정답 세 문장을 토큰화한다 | 문장마다 토큰 수와 조각을 찍는 반복 | labels = tokenizer(text_target=answers, ...)["input_ids"] |
| 2 | -100 표에 담고 한 칸 민다 | 표를 채우는 짧은 for 는 네모 하나로 줄여 그렸다 | decoder_input[:, 1:] = label_arr[:, :-1] |
| 3 | 라이브러리 결과와 맞춰 본다 | 없음 | np.array_equal(lib.numpy(), decoder_input) |
| 4 | 연습지 표를 만든다 | 문장 × 위치의 이중 반복. 빈칸(-100)에 닿으면 break | rows.append({... "맞힐 정답": ...}) |
| 5 | 가림판을 씌우고 저장한다 | 없음 | masked = np.where(mask, -np.inf, scores) |
- 한 줄기 흐름: 앞 단계의 변수(
labels,label_arr,decoder_input,sheet)를 뒤 단계가 그대로 쓰므로 1단계부터 차례로 실행합니다. - 3단계의 뜻: 직접 만든 입력이 라이브러리 결과와 같으면, 실습 2에서 Trainer 안에서 일어난 Teacher Forcing 을 손으로 재현했다는 뜻입니다.
- 4단계의 이중 반복: 바깥 고리는 문장, 안쪽 고리는 위치입니다. 안쪽 마름모는
for k와if ... break를 한 물음으로 합친 것입니다. 빈칸에 닿으면 그 문장을 끝내고 바깥 고리로 돌아가므로, 문제는 6 + 16 + 12 = 34행이 됩니다. - 5단계의 가림판: 그 입력을 Decoder 가 볼 때 미래를 가리는 장치입니다. 행 합 1, 가린 칸 합 0.0 이 확인 지점입니다.
결과 보기 (예시 풀이)
1단계. 정답 문장 세 개를 토큰 ID 로 바꾸기
본문의 저는 학생입니다 와 실습 1·3에 나온 정답 두 문장으로 연습지를 만듭니다.
import numpy as np
import pandas as pd
# AutoTokenizer = 모델 이름만 주면 맞는 토크나이저를 골라 주는 도구
from transformers import AutoTokenizer

# 실습 1과 같은 토크나이저(사전 61,790개)
tokenizer = AutoTokenizer.from_pretrained("tunib/electra-ko-en-small")
pad_id = tokenizer.pad_token_id      # [PAD] = 0
bos_id = tokenizer.cls_token_id      # [CLS] = 2, 실습 2에서 decoder_start_token_id 로 쓴 토큰
eos_id = tokenizer.sep_token_id      # [SEP] = 3, 문장 끝

# Decoder 가 맞힐 한국어 정답 세 문장
answers = ["저는 학생입니다", "스트레스를 관리하지 않으면 문제가 생길 수 있어.", "주차 공간이 필요하면 미리 문의해 주세요."]
# text_target= 만 주면 정답 쪽(labels)만 토큰화한다. 결과: 문장마다 토큰 ID 리스트
labels = tokenizer(text_target=answers, truncation=True, max_length=32)["input_ids"]

print("특수 토큰 ID:", pad_id, bos_id, eos_id)
for ids in labels:
    # convert_ids_to_tokens = 번호를 토큰 조각 글자로 되돌리기
print(len(ids), tokenizer.convert_ids_to_tokens(ids))특수 토큰 ID: 0 2 3
6 ['[CLS]', '저', '##는', '학생', '##입니다', '[SEP]']
16 ['[CLS]', '스트레스', '##를', '관리', '##하', '##지', '않', '##으면', '문제', '##가', '생길', '수', '있', '##어', '.', '[SEP]']
12 ['[CLS]', '주차', '공간', '##이', '필요', '##하면', '미리', '문의', '##해', '주세요', '.', '[SEP]']2단계. 정답을 한 칸 밀어 Decoder 입력 만들기
길이가 다른 세 문장을 같은 길이의 표로 맞춘 다음, 정답 줄을 오른쪽으로 한 칸 밉니다.
# 가장 긴 문장의 토큰 수가 표의 열 수가 된다
max_len = max(len(ids) for ids in labels)
# np.full(모양, 값): 모든 칸을 -100(채점에서 빼는 칸)으로 채운 표
label_arr = np.full((len(labels), max_len), -100)
for i, ids in enumerate(labels):
    label_arr[i, :len(ids)] = ids    # 앞쪽부터 진짜 토큰 ID 를 채운다

def shift_right(label_arr, start_id, pad_id):
    # zeros_like: 같은 모양의 0 표
    decoder_input = np.zeros_like(label_arr)
    # 정답의 0~끝-1 열을 입력의 1~끝 열로 옮긴다(한 칸 오른쪽으로)
    decoder_input[:, 1:] = label_arr[:, :-1]
    # 비워진 맨 앞 열에 시작 토큰
    decoder_input[:, 0] = start_id
    # 정답의 빈칸(-100)이 밀려 들어온 자리는 [PAD] 로 바꾼다(모델 입력에 -100 은 없는 번호)
    decoder_input[decoder_input == -100] = pad_id
    return decoder_input

decoder_input = shift_right(label_arr, bos_id, pad_id)
print(label_arr.shape)                 # (문장 수, 최대 토큰 수)
print("정답  :", label_arr[0])
print("입력 :", decoder_input[0])(3, 16)
정답 : [ 2 44567 16936 53699 20008 3 -100 -100 -100 -100 -100 -100
-100 -100 -100 -100]
입력 : [ 2 2 44567 16936 53699 20008 3 0 0 0 0 0
0 0 0 0]입력 줄이 2 2 44567 ... 로 시작합니다. 이 토크나이저는 정답 문장에도 맨 앞에 [CLS](2)를 붙이는데, 한 칸 밀며 시작 토큰 [CLS] 를 또 넣었기 때문입니다. 그래서 실습 2의 번역기는 위치 1에서 "[CLS] 를 보고 [CLS] 를 맞히는" 쉬운 문제도 함께 풉니다. 생성 결과에서는 skip_special_tokens=True 가 이 토큰을 지워 주므로 겉으로 드러나지 않습니다.
3단계. 라이브러리 결과와 맞춰 보기
직접 만든 연습지가 실습 2의 Trainer 안에서 쓰인 것과 같은지 확인합니다.
import torch
# shift_tokens_right = Marian 모델이 labels 를 한 칸 밀 때 쓰는 함수(DataCollatorForSeq2Seq 가 부른다)
from transformers.models.marian.modeling_marian import shift_tokens_right

# 인자: (정답 텐서, 패딩 ID, 시작 토큰 ID). 결과: 한 칸 민 텐서
lib = shift_tokens_right(torch.tensor(label_arr), pad_id, bos_id)
# np.array_equal = 두 표의 모양과 모든 칸이 같은지. 결과: True
print("라이브러리와 같은가:", np.array_equal(lib.numpy(), decoder_input))라이브러리와 같은가: True4단계. 위치마다 문제 한 줄씩 연습지 표로 만들기
문장마다 "여기까지 보고(보이는 입력) 이것을 쓰세요(맞힐 정답)"를 한 행으로 적습니다.
rows = []
for s, sentence in enumerate(answers):
    for k in range(max_len):
        if label_arr[s, k] == -100:     # 빈칸에 닿으면 그 문장은 끝
            break
        # 위치 k 까지 보이는 입력: decoder_input 의 0~k 열
        seen = tokenizer.convert_ids_to_tokens(decoder_input[s, :k + 1].tolist())
        rows.append({"문장": s + 1, "위치": k + 1, "보이는 입력": " ".join(seen),
                     "맞힐 정답": tokenizer.convert_ids_to_tokens(int(label_arr[s, k]))})
sheet = pd.DataFrame(rows)
# 첫 문장 부분만 찍는다. to_string(index=False): 행 번호 없이 표 전체
print(sheet[sheet["문장"] == 1].to_string(index=False)) 문장 위치 보이는 입력 맞힐 정답
1 1 [CLS] [CLS]
1 2 [CLS] [CLS] 저
1 3 [CLS] [CLS] 저 ##는
1 4 [CLS] [CLS] 저 ##는 학생
1 5 [CLS] [CLS] 저 ##는 학생 ##입니다
1 6 [CLS] [CLS] 저 ##는 학생 ##입니다 [SEP]5단계. Causal Mask 가림판 씌우고 연습지 저장하기
첫 문장 6토큰의 점수표에 가림판을 씌웁니다. 점수는 모델 대신 씨앗을 준 무작위 숫자로 채웁니다.
L = len(labels[0])                                  # 첫 문장의 토큰 수(6)
mask = np.triu(np.ones((L, L)), k=1).astype(bool)   # 대각선 위 = 미래 = 가릴 칸
rng = np.random.default_rng(42)                     # 씨앗 42: 매번 같은 점수
scores = rng.normal(size=(L, L)).round(1)           # 모델이 냈다고 치는 Attention 점수
masked = np.where(mask, -np.inf, scores)            # 미래 칸을 -inf 로
# 행마다 Softmax. e^-inf = 0 이라 가린 칸은 0
weights = np.exp(masked) / np.exp(masked).sum(axis=1, keepdims=True)

# 행·열 이름을 Decoder 입력 토큰으로 붙여 표로 본다
names = tokenizer.convert_ids_to_tokens(decoder_input[0, :L].tolist())
print(pd.DataFrame(weights.round(2), index=names, columns=names))
print("행 합:", weights.sum(axis=1).round(2))      # 모두 1 이어야 한다
print("가린 칸 합:", weights[mask].sum())           # 0 이어야 한다

# utf-8-sig: 엑셀에서 열어도 한글이 깨지지 않는 인코딩
sheet.to_csv("out_ch04_dictation.csv", index=False, encoding="utf-8-sig")
print("저장:", len(sheet), "행") [CLS] [CLS] 저 ##는 학생 ##입니다
[CLS] 1.00 0.00 0.00 0.00 0.00 0.0
[CLS] 0.60 0.40 0.00 0.00 0.00 0.0
저 0.19 0.52 0.29 0.00 0.00 0.0
##는 0.52 0.21 0.17 0.10 0.00 0.0
학생 0.11 0.11 0.28 0.25 0.25 0.0
##입니다 0.55 0.05 0.04 0.03 0.12 0.2
행 합: [1. 1. 1. 1. 1. 1.]
가린 칸 합: 0.0
저장: 34 행가중치 표의 대각선 위쪽은 모두 0 이고, 행마다 합이 1 입니다. 첫 행([CLS])은 자기 자신만 보므로 1.00 이고, 마지막 행(##입니다)은 앞의 여섯 칸을 모두 나눠 봅니다. 연습지 csv 에는 세 문장의 문제 6 + 16 + 12 = 34행이 담깁니다. 이 프로젝트의 요점은 "Teacher Forcing 은 정답을 한 칸 미는 것, Causal Mask 는 대각선 위를 -inf 로 가리는 것" 두 가지가 실습 2의 학습을 떠받친다는 것입니다.