4장. Transformer Decoder와 작은 번역기
실습 3 — 학습한 번역기로 새 문장 번역하기
실습 1과 2를 먼저 실행해 둡니다. 학습에 쓰지 않은 test 문장 하나를 generate() 로 번역하고, test 950쌍 전체의 손실을 잽니다. 작은 모델을 처음부터 학습했으므로 번역이 어색할 수 있습니다. 보려는 것은 품질보다 "고른 토큰을 다시 넣으며 이어 쓰는 과정"입니다.
코드를 따라가기 전에 실행 흐름을 한 장으로 봅니다.
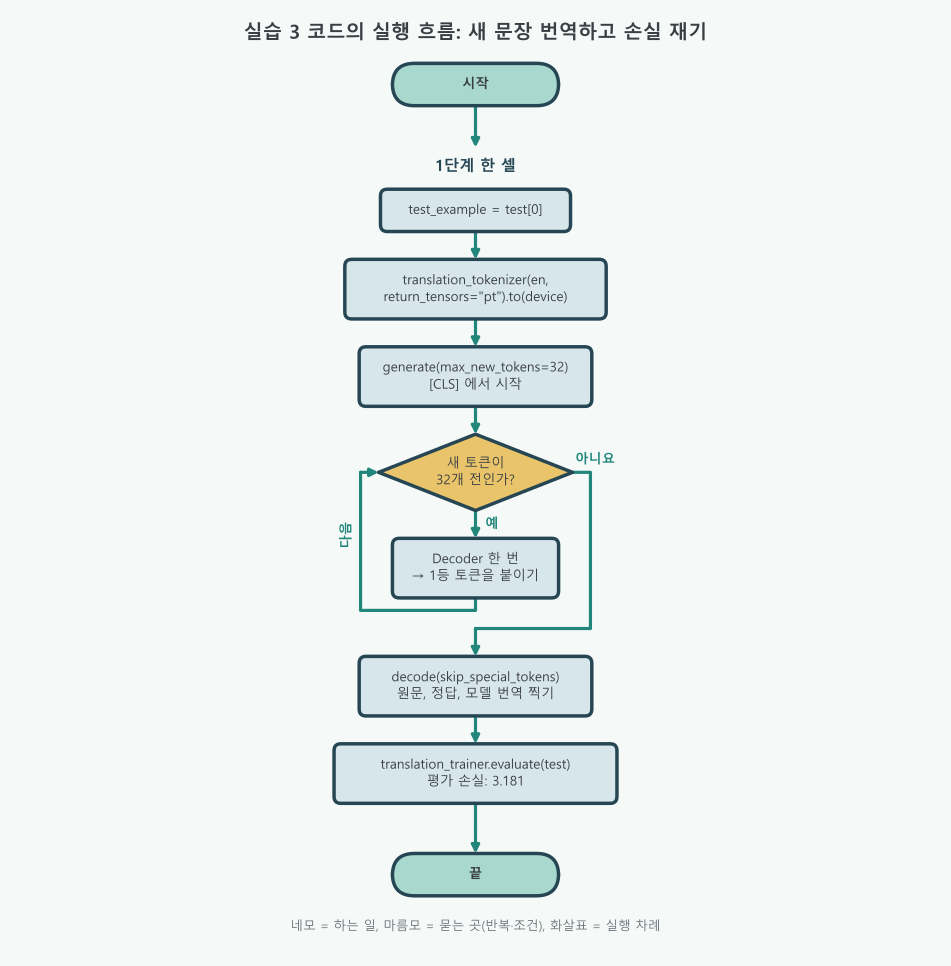
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | test 문장 하나를 번역하고 test 950쌍의 손실을 잰다 | 새 토큰 32개까지 한 토큰씩 반복(generate() 가 안에서 도는 반복) | output_ids = translation_model.generate(...) |
- 고리는 generate 안에 있습니다: 코드는
generate(...)한 줄이지만, 안에서는 Decoder 를 한 번 돌려 1등 토큰을 고르고, 그 토큰을 붙여 다시 넣기를 되풀이합니다. 본문 "학습과 추론" 절의 자기회귀 반복입니다. - 멈추는 곳:
max_new_tokens=MAX_LENGTH가 반복 횟수의 상한입니다. 마름모의 "아니요"는 새 토큰이 32개에 닿은 경우입니다. - 두 가지 시험:
generate는 정답 없이 혼자 받아쓰기이고, 마지막 네모의evaluate는 정답을 보여 주며 손실만 재는 채점입니다.
1단계. 실전 시험 문장 번역하고 평가 손실 재기
연습을 마친 학생에게 처음 보는 문장을 받아쓰게 합니다. 정답을 보여 주지 않으므로 학생은 자기가 쓴 낱말을 보며 다음 낱말을 씁니다.
# test 분할의 0번 행. 결과: en, ko 두 열이 든 사전
test_example = translation_data["test"][0]  # 학습에 쓰지 않은 문장쌍입니다.
inputs = translation_tokenizer(  # 평가할 영어 문장을 모델에 넣을 토큰 ID로 바꿉니다.
    test_example["en"],  # 평가 데이터의 영어 문장을 번역 입력으로 사용합니다.
    # return_tensors="pt": PyTorch 텐서(모델이 받는 숫자 묶음)로 돌려준다
    return_tensors="pt",  # 모델에 바로 넣을 수 있도록 PyTorch 텐서로 받습니다.
    truncation=True,  # 정해 둔 길이를 넘는 문장은 뒤쪽 토큰을 자릅니다.
    max_length=MAX_LENGTH,  # 입력 문장의 길이를 최대 32토큰으로 제한합니다.
# .to(장치): 모델이 GPU 에 있으면 입력도 GPU 로, CPU 면 CPU 로 옮긴다
).to(translation_model.device)  # 입력과 모델이 같은 CPU 또는 GPU에 있도록 옮깁니다.
# generate = 한 토큰씩 이어 쓰기. [CLS] 에서 시작해 고른 토큰을 붙이며 반복한다(기본은 greedy)
output_ids = translation_model.generate(  # 한 토큰씩 고르며 번역 문장을 만듭니다.
    input_ids=inputs["input_ids"],  # 번역할 영어 문장의 토큰 ID를 전달합니다.
    # attention_mask: 1 은 진짜 토큰, 0 은 패딩. 문장이 하나라 모두 1 이다
    attention_mask=inputs["attention_mask"],  # 실제 토큰과 패딩을 구분하는 마스크를 전달합니다.
    # max_new_tokens: 새로 만들 토큰 수의 상한(시험 시간 제한)
    max_new_tokens=MAX_LENGTH,  # 번역을 만들 때 새 토큰을 최대 32개 생성합니다.
)

print("영어 원문:", test_example["en"])
print("한국어 정답:", test_example["ko"])
# decode = 토큰 ID 줄을 글자로 되돌리기. skip_special_tokens=True: [CLS], [SEP], [PAD] 를 빼고 보여 준다
print("모델 번역:", translation_tokenizer.decode(output_ids[0], skip_special_tokens=True))
# evaluate(데이터) = 그 데이터 전체로 손실만 잰다(가중치는 고치지 않는다). 결과: 평가 손실: 3.181
print("평가 손실:", round(translation_trainer.evaluate(tokenized["test"])["eval_loss"], 3)) # 평가 손실이 낮을수록 정답 토큰에 높은 확률을 준 것입니다.영어 원문: If you need parking space, please inquire in advance.
한국어 정답: 주차 공간이 필요하면 미리 문의해 주세요.
모델 번역: 서비스가 있다면, 언제든지 연락해 주세요.
평가 손실: 3.181정답은 "주차 공간이 필요하면 미리 문의해 주세요."인데, 모델은 "서비스가 있다면, 언제든지 연락해 주세요."라고 썼습니다. 낱말은 틀렸지만 "~다면, ~해 주세요"라는 안내문의 뼈대는 따라 했습니다. "주차"처럼 학습 데이터에 드물게 나온 낱말은 7,594쌍과 10 epoch 로는 다 익히지 못합니다. 평가 손실 3.181 은 검증 손실 3.19 와 거의 같습니다. 처음 보는 문장에서도 모의고사 수준의 실력을 냈다는 뜻입니다. e^3.181 ≈ 24 이므로 "매 토큰마다 후보 24개쯤에서 헤매는" 수준입니다.
이 실습이 뜻하는 것
처음 보는 실전 문제를 혼자 받아쓰게 하고, 실전 시험지 950장 전체의 벌점 평균을 낸 일입니다. 여기서 시험 문제가 test_example, 학생의 답안이 output_ids, 벌점 평균이 eval_loss 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 원문 | If you need parking space, please inquire in advance. | 학습에 쓰지 않은 문장입니다 |
| 정답 | 주차 공간이 필요하면 미리 문의해 주세요. | 사람이 쓴 번역입니다 |
| 모델 번역 | 서비스가 있다면, 언제든지 연락해 주세요. | 문장 꼴은 비슷하고 낱말은 틀렸습니다 |
| 평가 손실 | 3.181 | 검증 손실 3.19 와 비슷합니다 |
한 줄로 줄이면, generate() 가 토큰을 하나씩 골라 붙이는 자기회귀 방식으로 번역문을 만들었고, 작은 모델이라 내용은 아직 서툽니다.
코드 설명
translation_tokenizer(..., return_tensors="pt")는 리스트 대신 PyTorch 텐서를 돌려줍니다..to(translation_model.device)로 모델과 같은 장치에 둡니다.generate()는decoder_start_token_id([CLS])로 시작해 Decoder 를 한 번 돌리고, 가장 높은 확률의 토큰을 골라 붙이기를 되풀이합니다. 본문 "학습과 추론" 절의 반복을 대신합니다.max_new_tokens=MAX_LENGTH가 상한입니다. 끝 토큰이 나오지 않아도 새 토큰 32개에서 멈춥니다.decode(..., skip_special_tokens=True)는[CLS],[SEP],[PAD]를 빼고 글자로 되돌립니다.##조각도 앞 조각에 붙여 줍니다.translation_trainer.evaluate(tokenized["test"])는 test 950쌍에서 Teacher Forcing 으로 손실만 잽니다. 생성 품질과 손실은 함께 보아야 합니다.