4장. Transformer Decoder와 작은 번역기
실습 2 — 작은 번역기를 만들고 처음부터 학습하기
실습 1의 translation_tokenizer, tokenized, pad_id, bos_id, eos_id, MAX_LENGTH 를 그대로 씁니다. 실습 1을 먼저 실행해 둡니다. 사전학습 가중치 없이 2층짜리 Encoder-Decoder 를 무작위로 만들고, Seq2SeqTrainer 로 10 epoch 학습합니다. 실린 학습 출력은 RTX 3080 에서 약 52초 걸렸고, CPU 에서는 훨씬 오래 걸립니다.
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다.
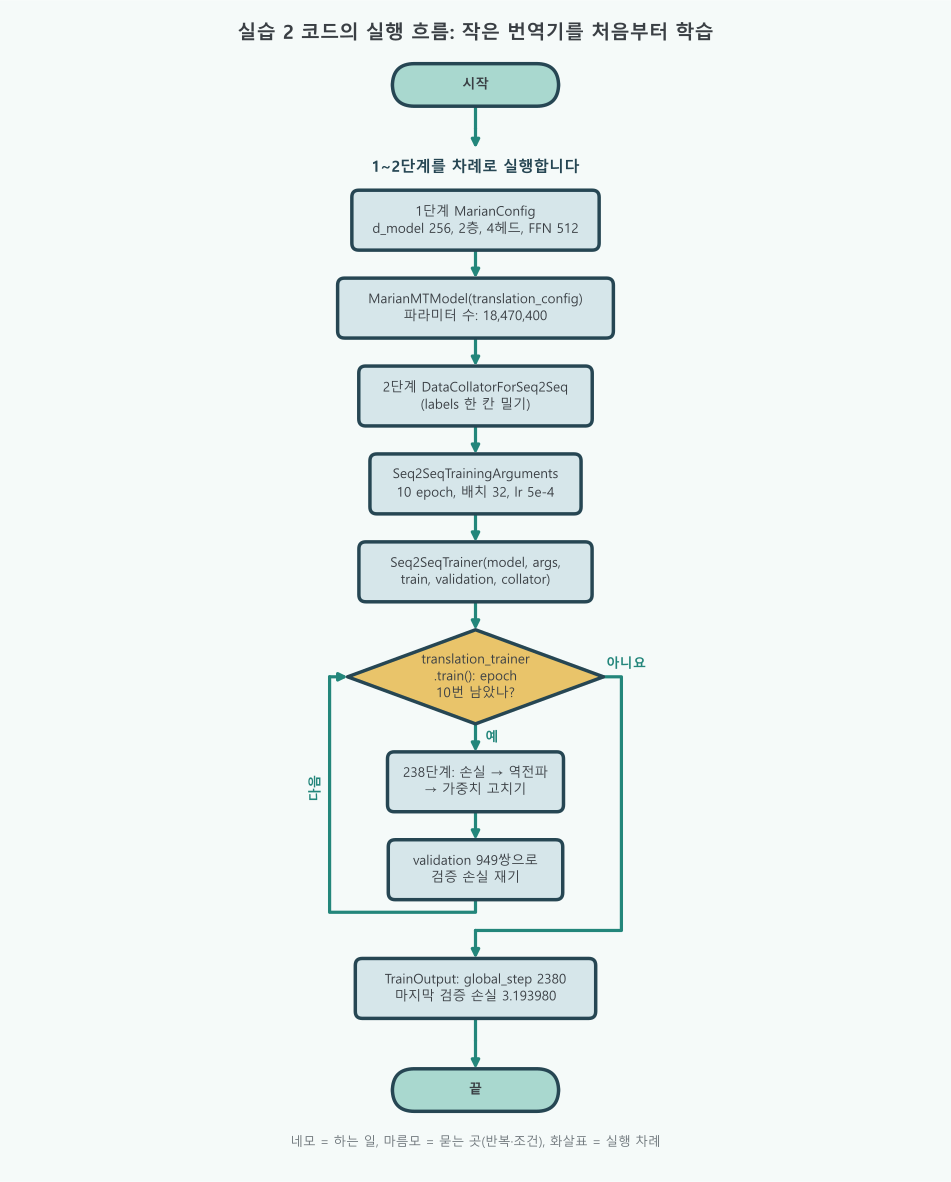
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 설정표로 2층 Encoder-Decoder 를 만들고 파라미터를 센다 | 없음 | translation_model = MarianMTModel(translation_config) |
| 2 | 묶음 정리 담당, 학습 조건표, 학습 담당을 잇고 학습한다 | epoch 10번 반복(Trainer 가 안에서 도는 반복). 바퀴마다 학습 뒤 검증 | translation_trainer.train() |
- 고리는 Trainer 안에 있습니다: 코드에는
for가 없고translation_trainer.train()한 줄뿐입니다. 그림의 고리는 Trainer 가 안에서 도는 반복을 풀어 그린 것입니다.num_train_epochs=10이 바퀴 수를,eval_strategy="epoch"가 바퀴마다 검증하는 시점을 정합니다. - 한 바퀴의 일: 학습 데이터 7,594쌍을 32쌍씩 238묶음으로 나눠, 묶음마다 손실 계산 → 역전파 → 가중치 고치기를 합니다. 10바퀴면 2,380단계로, 출력의
global_step=2380과 같습니다. - 끝부분: 고리를 빠져나오면
TrainOutput이 찍힙니다. 마지막 바퀴의 검증 손실 3.193980 이 실습 3의 평가 손실과 견줄 기준입니다.
1단계. 설정표로 작은 Encoder-Decoder 만들기
반죽 크기를 정하는 단계입니다. 층 수, 헤드 수, 벡터 크기를 설정표에 적고, 그 크기대로 빈 모델(무작위 숫자로 채운 모델)을 만듭니다.
# MarianConfig = Marian 번역 모델의 설정표, MarianMTModel = Marian machine translation model(Encoder-Decoder 번역 모델)
from transformers import MarianConfig, MarianMTModel  # 작은 Encoder-Decoder Transformer를 만듭니다.

translation_config = MarianConfig(  # 모델 크기와 특수 토큰을 정합니다.
    # len(tokenizer) = 61,790. 단어 표의 행 수이자 출력 Linear 의 칸 수
    vocab_size=len(translation_tokenizer),  # 토크나이저의 전체 토큰 수입니다.
    # d_model = 토큰 하나를 나타내는 숫자 개수(열 수). 원조 Transformer 는 512
    d_model=256,  # 토큰 벡터의 크기입니다.
    # 원조 Transformer 는 6층씩. 여기서는 빨리 돌도록 2층씩
    encoder_layers=2, decoder_layers=2,  # Encoder·Decoder를 두 층씩 쌓습니다.
    # 헤드 4개 → 헤드 하나가 256 ÷ 4 = 64칸씩 맡는다(√64 = 8 로 나눈다)
    encoder_attention_heads=4, decoder_attention_heads=4,  # Attention을 네 관점으로 나눕니다.
    # FFN: 256 → 512 → 256 으로 넓혔다가 줄인다
    encoder_ffn_dim=512, decoder_ffn_dim=512,  # FFN의 중간 벡터 크기입니다.
    max_position_embeddings=MAX_LENGTH,  # 모델이 처리할 입력과 번역문의 최대 길이를 토큰 수로 지정합니다.
    pad_token_id=pad_id,  # 문장 길이를 맞추기 위해 빈자리에 넣을 토큰의 ID입니다.
    eos_token_id=eos_id,  # 번역이 끝났음을 알리는 토큰의 ID입니다.
    # decoder_start_token_id: 정답을 한 칸 밀 때 맨 앞에 넣는 <시작> 토큰. 여기서는 [CLS](2)
    decoder_start_token_id=bos_id,  # Decoder가 번역을 시작할 때 맨 앞에 넣는 토큰의 ID입니다.
)
# 설정표만 주고 만들면 가중치가 무작위 숫자로 채워진다(아무것도 모르는 모델)
translation_model = MarianMTModel(translation_config)  # 사전학습 가중치 없이 설정값만으로 초기화합니다.
# p.numel() = number of elements(행렬 하나에 든 숫자 개수). 모두 더하면 전체 파라미터 수
# :, = 세 자리마다 쉼표. 결과: 파라미터 수: 18,470,400
print(f"파라미터 수: {sum(p.numel() for p in translation_model.parameters()):,}")파라미터 수: 18,470,4002단계. Seq2SeqTrainer 로 10 epoch 학습하기
오븐에 넣는 단계입니다. 묶음 정리 담당(DataCollatorForSeq2Seq)이 정답을 한 칸 밀어 Decoder 입력을 만들고, 학습 담당(Seq2SeqTrainer)이 손실 계산, 역전파(오차를 거꾸로 전해 가중치마다 고칠 방향을 구하는 일), 가중치 고치기를 2,380번 되풀이합니다.
# DataCollatorForSeq2Seq = 묶음(batch) 정리 담당, Seq2SeqTrainingArguments = 학습 조건표, Seq2SeqTrainer = 학습 반복 담당
from transformers import DataCollatorForSeq2Seq, Seq2SeqTrainingArguments, Seq2SeqTrainer  # 문장 길이를 맞추고 번역 모델을 학습할 도구를 불러옵니다.

# model= 을 주면 모델의 shift 규칙으로 labels 를 한 칸 밀어 decoder_input_ids 를 만든다(Teacher Forcing)
# labels 의 빈칸은 -100(채점에서 빼는 칸)으로, input_ids 의 빈칸은 [PAD] 로 채운다
data_collator = DataCollatorForSeq2Seq(translation_tokenizer, model=translation_model)  # 문장 길이를 맞추고, 정답 문장을 한 칸 밀어 Decoder 입력을 만듭니다.

translation_args = Seq2SeqTrainingArguments(  # 반복 횟수, 배치 크기, 학습률과 검증 주기 등을 정합니다.
    output_dir="outputs/translation-scratch",  # 학습 결과가 저장될 폴더를 지정합니다.
    # epoch = 문제집 한 바퀴. 10바퀴 × 238단계 = 2,380단계
    num_train_epochs=10,  # 전체 학습 데이터를 열 번 반복합니다.
    per_device_train_batch_size=32,  # 한 번의 학습 단계에서 문장쌍 32개를 처리합니다.
    per_device_eval_batch_size=32,  # 한 번의 검증 단계에서 문장쌍 32개를 처리합니다.
    # 5e-4 = 0.0005. 한 걸음의 보폭. 처음부터 배우는 작은 모델이라 파인튜닝보다 크게 잡았다
    learning_rate=5e-4,  # 학습할 때 가중치를 얼마나 크게 바꿀지 정하는 학습률입니다.
    # "epoch": 한 바퀴 돌 때마다 검증 데이터(949쌍)로 모의고사를 본다
    eval_strategy="epoch",  # epoch마다 검증 손실을 확인합니다.
    logging_steps=50,  # 학습 50단계마다 손실 등을 기록합니다.
    report_to="none",  # 학습 기록을 외부 서비스로 보내지 않습니다.
    save_strategy="no",  # 학습 중간에는 모델을 저장하지 않습니다.
)

translation_trainer = Seq2SeqTrainer(  # 번역 모델, 데이터, 학습 조건을 Trainer에 연결합니다.
    model=translation_model,  # 위에서 만든 번역 모델의 가중치를 학습합니다.
    args=translation_args,  # 앞에서 정한 배치 크기와 학습률 등의 조건을 적용합니다.
    train_dataset=tokenized["train"],  # 이 데이터로 모델의 가중치를 업데이트합니다.
    eval_dataset=tokenized["validation"],  # 이 데이터로 학습 중 번역 성능을 확인합니다.
    data_collator=data_collator,  # 길이가 다른 문장을 패딩하고 Decoder 입력을 준비합니다.
    # processing_class: 입력을 처리하는 도구(여기서는 토크나이저)를 Trainer 에 알려 준다
    processing_class=translation_tokenizer,  # 영어·한국어 문장을 토큰 ID로 바꾸는 토크나이저를 전달합니다.
)
# train() = 학습 시작. 결과: epoch 별 학습 손실·검증 손실 표와 TrainOutput(걸린 시간 등)
# 이 PC(RTX 3080)에서 약 52초. 마지막 검증 손실 약 3.19
translation_trainer.train()The tokenizer has new PAD/BOS/EOS tokens that differ from the model config and generation config. The model config and generation config were aligned accordingly, being updated with the tokenizer's values. Updated tokens: {'eos_token_id': None}.
[2380/2380 00:51, Epoch 10/10]
Epoch Training Loss Validation Loss
1 4.962600 4.801691
2 4.523900 4.479119
3 4.027000 4.048675
4 3.724700 3.806342
5 3.516600 3.623791
6 3.367400 3.469677
7 3.212100 3.364400
8 3.069500 3.269272
9 2.976400 3.216625
10 2.910500 3.193980
TrainOutput(global_step=2380, training_loss=3.7325123955221735, metrics={'train_runtime': 52.1728, 'train_samples_per_second': 1455.547, 'train_steps_per_second': 45.618, 'total_flos': 25040768163840.0, 'train_loss': 3.7325123955221735, 'epoch': 10.0})첫 줄의 안내는 모델 설정과 생성 설정의 특수 토큰을 토크나이저 값에 맞췄다는 뜻입니다. 이 토크나이저에는 eos_token 이라는 이름의 토큰이 따로 없어서 eos_token_id 가 None 으로 적혔습니다. 학습 손실 계산에는 영향이 없습니다. 학습 표는 epoch 마다 학습 손실(Training Loss)과 검증 손실(Validation Loss)을 보여 줍니다. 두 손실이 함께 4.96·4.80 에서 2.91·3.19 로 내려갔고, 검증 손실이 다시 오르지 않았으므로 과적합(문제집 답만 외우기)의 조짐은 아직 없습니다.
이 실습이 뜻하는 것
반죽 크기를 정해 빈 모델을 만들고(1단계), 정답을 한 칸 밀어 보여 주는 받아쓰기 연습을 2,380번 시킨(2단계) 일입니다. 여기서 반죽 크기표가 translation_config, 연습생이 translation_model, 연습 담당 선생님이 translation_trainer 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 모델 만들기 | 파라미터 수: 18,470,400 | 단어 표 15,818,240개와 층 2,652,160개입니다 |
| 2. 학습 진행 | [2380/2380 00:51, Epoch 10/10] | 238단계 × 10바퀴를 약 51초에 마쳤습니다 |
| 2. 첫 epoch | 4.962600 4.801691 | 처음 눈높이 11.03 보다 이미 많이 낮습니다 |
| 2. 마지막 epoch | 2.910500 3.193980 | 후보 약 24개 정도로 좁힌 셈입니다 |
| 2. TrainOutput | 'train_runtime': 52.1728 | 걸린 시간은 약 52초입니다 |
한 줄로 줄이면, 무작위 숫자로 시작한 1,847만 개짜리 번역기가 10바퀴 연습으로 검증 손실을 4.80 에서 3.19 로 낮췄습니다.
코드 설명
MarianMTModel(translation_config)는 가중치를 무작위로 채운 Encoder-Decoder 를 만듭니다.from_pretrained를 쓰지 않았으므로 처음부터 배웁니다.- 파라미터 18,470,400개 중 15,818,240개(약 86%)가 61,790 × 256 단어 표입니다. 출력 Linear 는 이 표를 함께 씁니다.
DataCollatorForSeq2Seq(..., model=translation_model)가 묶음마다 길이를 맞추고,labels를 한 칸 밀어decoder_input_ids를 만듭니다. 본문의 Teacher Forcing 이 이 한 줄에 들어 있습니다.Seq2SeqTrainer는 2일차의SFTTrainer와 같은 집안의 학습 담당입니다. 손실 계산, 역전파, 가중치 고치기 반복을 대신합니다.- 학습 손실이 계속 내려가는데 검증 손실이 다시 오르면 외우기 시작한 것입니다. 이번 출력에서는 검증 손실이 마지막까지 내려갔습니다.