4장. Transformer Decoder와 작은 번역기
실습 1 — 영한 문장쌍을 토큰 ID 로 바꾸기
영어와 한국어가 짝지어진 문장쌍 데이터와 토크나이저를 불러오고, 영어는 Encoder 입력으로, 한국어는 Decoder 가 맞힐 정답(labels)으로 토큰화합니다. 처음 실행하면 데이터와 토크나이저를 Hugging Face 에서 내려받습니다. 실습 1~3의 셀은 변수가 이어지므로 같은 노트북에서 차례로 실행합니다.
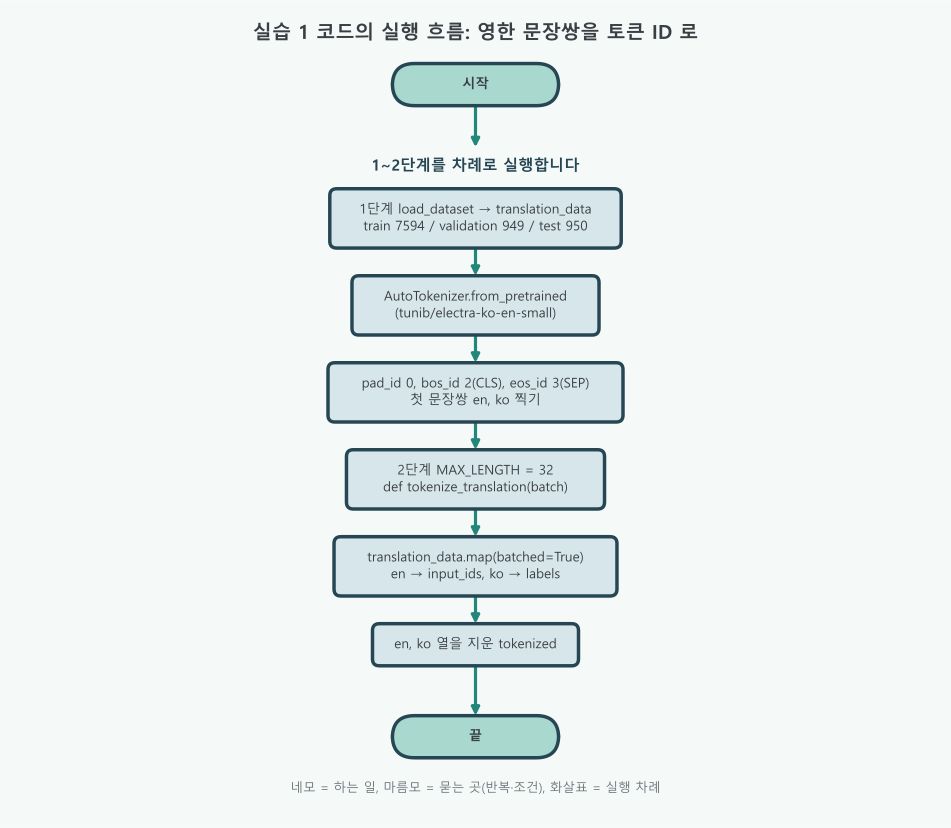
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 문장쌍과 토크나이저를 불러오고 특수 토큰 번호를 꺼낸다 | 없음 | bos_id = translation_tokenizer.cls_token_id |
| 2 | 영어는 입력, 한국어는 정답으로 토큰화한다 | 없음. 행을 도는 일은 map 이 안에서 맡는다 | tokenized = translation_data.map(tokenize_translation, batched=True, ...) |
- 흐름도의 모양: 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 마름모에서 "예"로 내려가 일을 하고, 화살표를 따라 다시 마름모로 돌아오는 고리가 반복문입니다. 고리를 다 돌면 "아니요"로 빠져나갑니다. 이 실습에는 마름모가 없어 한 줄기로 내려갑니다.
- 한 줄기 흐름: 2단계는 1단계의
translation_data와translation_tokenizer를 그대로 쓰므로 차례로 실행합니다. - map 의 반복:
map(..., batched=True)는 pandas 의df.apply처럼 모든 행에 함수를 적용합니다. 반복이 코드에 보이지 않으므로 네모 하나로 그렸습니다.
1단계. 문장쌍과 토크나이저 불러오기
번역 연습 문제집(문장쌍)과 글자를 상품 번호로 바꾸는 계산대(토크나이저)를 준비합니다. 특수 토큰 세 개(빈칸 채우기, 시작, 끝)의 번호도 미리 꺼내 둡니다.
# 영어 문장과 한국어 번역이 짝지어진 데이터와 토크나이저를 불러옵니다.
# load_dataset = Hugging Face Hub 에서 데이터셋을 내려받아 DatasetDict(분할별 표 묶음)로 돌려준다
from datasets import load_dataset  # 공개 영한 문장쌍을 불러옵니다.
# AutoTokenizer = 모델 이름만 주면 맞는 토크나이저를 골라 주는 도구
from transformers import AutoTokenizer  # 영어와 한국어를 토큰 ID로 바꿉니다.

# 결과: train 7,594 / validation 949 / test 950 쌍이 든 DatasetDict
translation_data = load_dataset("strongminsu/ko-en-structured-translations")  # 학습·검증·평가용 영어·한국어 문장쌍을 불러옵니다.
# from_pretrained = 이미 만들어 둔(pretrained) 설정과 사전을 불러오기
# tunib/electra-ko-en-small: 한국어와 영어를 함께 담은 사전(61,790개)을 가진 토크나이저
translation_tokenizer = AutoTokenizer.from_pretrained("tunib/electra-ko-en-small")  # 영어와 한국어 문장을 모델이 읽을 토큰 ID로 바꿉니다.
# [PAD] 의 번호. 결과: 0
pad_id = translation_tokenizer.pad_token_id  # 길이가 다른 문장을 배치로 묶을 때 빈자리를 채우는 토큰의 ID입니다.
# cls_token = classification token([CLS]). 원래 BERT 계열에서 문장 맨 앞에 붙는 토큰인데, 여기서는 "번역 시작" 표시로 빌려 쓴다. 결과: 2
bos_id = translation_tokenizer.cls_token_id  # Decoder가 번역을 시작할 때 맨 앞에 넣는 토큰의 ID입니다.
# sep_token = separator token([SEP]). 문장 끝 표시로 쓴다. 결과: 3
eos_id = translation_tokenizer.sep_token_id  # 번역문의 끝을 표시하는 토큰의 ID입니다.
# 딕셔너리 컴프리헨션으로 분할 이름: 행 수. 결과: {'train': 7594, 'validation': 949, 'test': 950}
print({name: len(rows) for name, rows in translation_data.items()})  # 학습·검증·평가 데이터에 문장쌍이 각각 몇 개 있는지 확인합니다.
# train 의 0번 행에서 en 열과 ko 열을 꺼낸다(DataFrame 의 df.loc[0, "en"] 과 같다)
print("영어:", translation_data["train"][0]["en"])
print("한국어:", translation_data["train"][0]["ko"]){'train': 7594, 'validation': 949, 'test': 950}
영어: If you don't manage your stress, problems may arise.
한국어: 스트레스를 관리하지 않으면 문제가 생길 수 있어.Windows 에서 처음 내려받을 때 huggingface_hub 의 UserWarning(캐시 바로가기를 만들 수 없다는 안내)이 함께 뜰 수 있습니다. 파일을 조금 더 많이 저장할 뿐 결과에는 영향이 없습니다.
2단계. 영어는 입력으로, 한국어는 정답으로 토큰화하기
문제집의 모든 문장을 상품 번호 줄로 바꿉니다. 영어는 Encoder 가 읽을 input_ids, 한국어는 Decoder 가 맞힐 labels 가 됩니다. 이 셀은 변수만 만들고 찍는 것이 없습니다.
# 문장 하나의 최대 토큰 수. 위치 표(max_position_embeddings)의 크기도 이 값을 쓴다
MAX_LENGTH = 32  # 영어 입력과 한국어 정답을 각각 최대 32토큰으로 제한합니다.

# batch: 문장쌍 여러 개가 든 사전. batch["en"] 은 영어 문장 리스트, batch["ko"] 는 한국어 문장 리스트
def tokenize_translation(batch):  # 영어는 입력, 한국어는 Decoder가 맞힐 정답으로 토큰화합니다.
    # 결과: input_ids, attention_mask(영어 쪽), labels(한국어 쪽) 세 열이 든 사전
    return translation_tokenizer(  # 영어 입력의 토큰 ID와 한국어 정답의 토큰 ID를 함께 만듭니다.
        batch["en"],  # Encoder가 읽을 영어 문장입니다.
        # text_target = 목표(target) 문장. 이것을 주면 그 토큰 ID 가 labels 열로 들어간다
        text_target=batch["ko"],  # Decoder가 맞힐 한국어 정답입니다.
        # truncation = 자르기. True 면 max_length 를 넘는 뒤쪽 토큰을 버린다
        truncation=True,  # 32토큰을 넘는 부분은 자릅니다.
        max_length=MAX_LENGTH,  # 영어와 한국어에 같은 상한을 적용합니다.
    )

# map = 모든 행에 함수를 적용해 새 열을 만든다(pandas 의 df.apply 와 비슷하다)
# 결과: 분할마다 input_ids, token_type_ids, attention_mask, labels 열만 남은 DatasetDict
tokenized = translation_data.map(  # train·validation·test를 한 번에 토큰화합니다.
    tokenize_translation,  # 각 문장쌍에 위 토큰화 함수를 적용합니다.
    # batched=True: 한 행씩이 아니라 1,000행씩 묶어 넘겨 빠르게 처리한다
    batched=True,  # 여러 문장쌍을 한 번에 변환합니다.
    # remove_columns: en, ko 문자열 열은 모델에 넣을 수 없으므로 지운다
    remove_columns=translation_data["train"].column_names,  # 원본 문자열 열은 제외합니다.
)
이 실습이 뜻하는 것
번역 연습 문제집을 펼쳐 문제 수를 세고(1단계), 모든 문제와 정답을 상품 번호 줄로 옮겨 적은(2단계) 일입니다. 여기서 문제집이 translation_data, 계산대가 translation_tokenizer, 번호로 옮긴 문제집이 tokenized 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 불러오기 | {'train': 7594, 'validation': 949, 'test': 950} | 문제집, 모의고사, 실전 시험의 문항 수입니다 |
| 1. 첫 문장쌍 | If you don't manage your stress, ... / 스트레스를 관리하지 않으면 ... | 영어가 입력, 한국어가 정답입니다 |
| 2. 토큰화 | 출력 없음 | 영어는 input_ids, 한국어는 labels 열이 되었습니다 |
한 줄로 줄이면, 영한 문장 9,493쌍이 "영어 번호 줄 + 한국어 번호 줄"의 표로 바뀌었습니다.
코드 설명
load_dataset(...)은 분할 이름(train, validation, test)을 열쇠로 하는DatasetDict를 돌려줍니다. 각 분할은en,ko두 열짜리 표입니다.- 이 토크나이저에는 따로 된 시작·끝 토큰이 없어서
[CLS](2)를 시작,[SEP](3)를 끝으로 빌려 씁니다.[PAD]는 0 입니다. text_target=을 주면 한 번의 호출로 영어input_ids와 한국어labels를 함께 만듭니다. 이 토크나이저는 한국어 정답에도 앞뒤로[CLS],[SEP]를 붙입니다.MAX_LENGTH = 32로 자르므로 긴 문장의 뒤쪽은 버려집니다. 위치 표의 크기도 32라서 이보다 긴 문장은 넣을 수 없습니다.map(..., batched=True, remove_columns=...)는 세 분할을 한꺼번에 바꾸고 문자열 열을 지웁니다. 남은 열은 모두 숫자 리스트입니다.