4장. Transformer Decoder와 작은 번역기
Transformer 이후의 발전
처음 나온 휴대전화는 통화만 하는 기계였지만, 같은 틀 위에 카메라, 지도, 앱이 얹히며 지금의 스마트폰이 되었습니다. Transformer 도 번역기로 시작했지만, 크기를 키우고 학습 방법을 바꾸며 거의 모든 언어 모델의 기본 틀이 되었습니다.
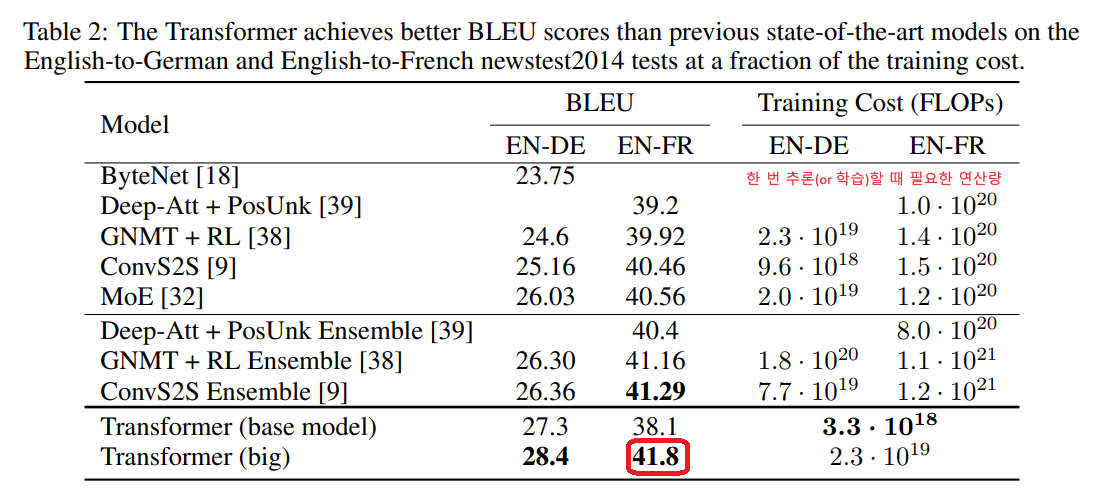
원 논문의 결과표입니다. BLEU 는 번역이 사람 번역과 얼마나 겹치는지 재는 점수(높을수록 좋음)이고, Training Cost 는 학습에 든 계산량입니다. 맨 아래 두 줄의 Transformer 는 BLEU 가 가장 높으면서(영어-프랑스어 41.8), 계산량은 이전 모델들보다 적습니다. 빨간 테두리가 그 41.8 입니다. "더 빠르게 배우고 더 잘 번역한다"는 이 결과가 이후 흐름의 출발점이었습니다.
연도별 흐름
| 연도 | 모델 | 의미 |
|---|---|---|
| 2017 | Transformer | RNN 없이 Attention 만으로 번역 |
| 2018 | GPT-1 | 대규모 사전학습 뒤 파인튜닝하는 흐름을 제시 |
| 2018 | BERT | 양방향 문맥 이해, 분류·검색에 강함 |
| 2019 | GPT-2, T5 | 규모를 키우면 범용 능력이 생김을 보여 줌 |
| 2020 | GPT-3 (175B) | 예시 몇 개만으로 새 작업 수행(in-context learning) |
| 2022 | InstructGPT, ChatGPT | 지시를 따르는 대화형 모델의 대중화 |
| 2023 | LLaMA, Llama 2, Mistral | 공개 LLM 생태계와 LoRA 파인튜닝 확산 |
| 2024~2025 | Llama 3·4, Qwen2.5·3, DeepSeek | 긴 문맥, 멀티모달, 추론 특화, 경량 모델 |
오늘날 생성형 LLM 은 대부분 Decoder 블록만 쌓은 구조입니다. 이 구조가 왜 유리한지는 5장에서 다룹니다. 2일차에 파인튜닝할 Qwen2.5 도 이 표의 마지막 줄에 있습니다.
짧은 예시
# 메모리 = 파라미터 수 × 숫자 하나의 바이트 수
small = 18_470_400          # 실습 2의 번역기 파라미터 수
gpt3 = 175_000_000_000      # GPT-3 의 파라미터 수(175B)

# FP32(32비트 실수)는 숫자 하나에 4바이트. 1e6 바이트 = 1MB
print("번역기(FP32):", round(small * 4 / 1e6, 1), "MB")    # 결과: 번역기(FP32): 73.9 MB
# BF16(16비트)은 숫자 하나에 2바이트. 1e9 바이트 = 1GB
print("GPT-3(BF16):", gpt3 * 2 / 1e9, "GB")                # 결과: GPT-3(BF16): 350.0 GB
print("몇 배:", round(gpt3 / small))                        # 결과: 몇 배: 9475
이 코드가 뜻하는 것
우리 번역기와 GPT-3 의 무게를 저울에 달아 본 코드입니다. 숫자 하나가 차지하는 바이트에 숫자 개수를 곱하면 모델 파일과 GPU 메모리의 크기를 어림할 수 있습니다. 여기서 숫자 개수가 small, gpt3 이고, 숫자 하나의 무게가 4 또는 2 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
small * 4 / 1e6 | 1,847만 × 4바이트 | 사진 몇십 장 크기 |
gpt3 * 2 / 1e9 | 1,750억 × 2바이트 | 가정용 GPU 로는 못 올리는 크기 |
gpt3 / small | 크기 비율 | 약 9,475배 |
18,470,400 × 4 = 73,881,600 바이트, 약 73.9MB 입니다. GPT-3 는 BF16 으로 줄여도 350GB 라서 10GB 짜리 GPU 에 올릴 수 없습니다. 2일차에 0.5B 짜리 Qwen 과 LoRA, QLoRA 를 쓰는 까닭이 여기에 있습니다.
주의할 점
- 표의 모델 이름과 연도는 큰 흐름을 보려는 것입니다. 모델은 지금도 빠르게 나오므로 최신 정보는 공식 발표를 확인합니다.
- 메모리 계산은 가중치만 센 것입니다. 학습할 때는 기울기와 옵티마이저 상태가 더해져 몇 배가 됩니다. 8장에서 다시 계산합니다.