2장. Transformer 입력 표현
프로젝트 1 — 공지문 토큰 수 계산기
회사 총무팀에서 한국어와 영어로 사내 공지를 내보낸다고 해 봅시다. 공지를 사내 챗봇(LLM)에 넣어 요약하고 번역하려는데, 팀장이 "한국어 공지와 영어 공지 중 어느 쪽이 토큰을 더 쓰나요? 숫자로 보여 주세요"라고 묻습니다. 같은 공지를 두 언어로 적은 표를 만들고, Qwen 과 BERT 토크나이저로 글자 수와 토큰 수를 세어 한눈에 보는 표로 정리합니다. 모델은 불러오지 않고 토크나이저만 쓰므로 CPU 에서 끝납니다.
요구사항
- 같은 공지 세 개(회의, 엘리베이터, 보안)를 한국어와 영어로 적어 pandas
DataFrame하나로 만듭니다. - Qwen(
Qwen/Qwen2.5-0.5B-Instruct)과 BERT(bert-base-uncased) 토크나이저를 불러와 사전 크기를 찍습니다. - 공지마다, 언어마다 글자 수, Qwen 토큰 수, BERT 토큰 수, 글자당 Qwen 토큰을 한 행으로 세어 긴 표를 만듭니다(특수 토큰은 빼고 셉니다).
- 공지별로 한국어와 영어의 Qwen 토큰 수를 나란히 놓고 "한국어 ÷ 영어" 비를 구합니다.
- 첫 공지의 한국어 문장이 두 토크나이저에서 어떤 조각으로 잘리는지 찍어 보고, 표를
out_ch02_notice_tokens.csv로 저장합니다.
힌트
- 토큰 수는
len(tokenizer(text, add_special_tokens=False)["input_ids"])입니다. 함수 하나로 묶어 두면 두 토크나이저에 똑같이 씁니다. - 긴 표는 행 사전을 리스트에 모아
pd.DataFrame(rows)로 만듭니다. - 나란히 놓기는
table.pivot(index="공지", columns="언어", values="Qwen 토큰")입니다. - 언어별 합계는
table.groupby("언어")[["글자 수", "Qwen 토큰"]].sum()입니다. - 엑셀에서 한글이 깨지지 않게
to_csv(..., encoding="utf-8-sig")로 저장합니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 공지 표 | 같은 뜻의 한국어·영어 공지 세 쌍을 DataFrame 으로 만든다 | 15 |
| 토크나이저 준비 | 두 토크나이저를 불러오고 사전 크기를 찍는다 | 15 |
| 토큰 세기 | 특수 토큰을 빼고 글자 수, 두 토크나이저의 토큰 수, 글자당 토큰을 표로 만든다 | 30 |
| 언어 비교 | 공지별 한국어 ÷ 영어 비와 언어별 합계를 구한다 | 20 |
| 조각 확인과 저장 | 한국어 문장의 조각을 찍어 해석하고 csv 로 저장한다 | 20 |
코드의 흐름
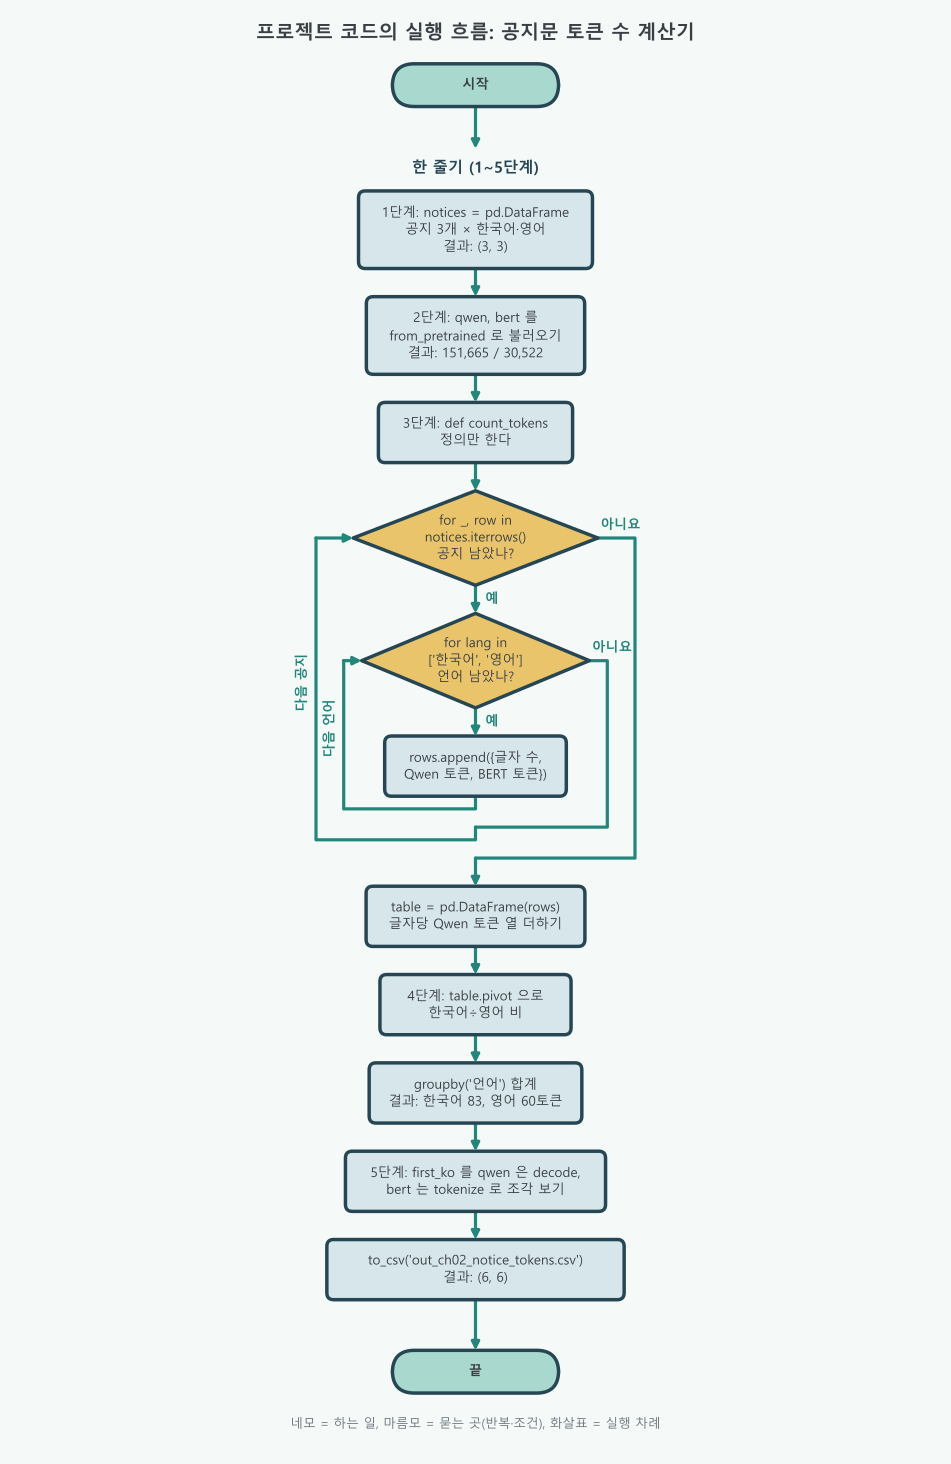
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 같은 공지 세 개를 한국어·영어로 적은 표 만들기 | 없음 | notices = pd.DataFrame({...}) |
| 2 | Qwen 과 BERT 토크나이저 불러오기 | 없음 | AutoTokenizer.from_pretrained(...) |
| 3 | 공지마다, 언어마다 글자 수와 토큰 수 세기 | 이중 반복: 공지 3개(for _, row in notices.iterrows()) × 언어 2개(for lang in) | rows.append({...}) |
| 4 | 한국어와 영어를 나란히 놓고 비와 합계 구하기 | 없음 | table.pivot(index="공지", columns="언어", values="Qwen 토큰") |
| 5 | 첫 공지의 조각을 보고 csv 로 저장하기 | 없음 | table.to_csv("out_ch02_notice_tokens.csv", ...) |
- 겹친 반복: 3단계는 바깥 마름모(공지 남았나?) 안에 안쪽 마름모(언어 남았나?)가 들어 있습니다. 공지 하나마다 언어 두 개를 돌므로
rows에 3 × 2 = 6 행이 쌓입니다. 엑셀에서 공지마다 한국어 줄과 영어 줄을 한 줄씩 적어 내려가는 일과 같습니다. - 정의와 실행:
def count_tokens는 3단계 맨 앞에서 정의만 하고, 실제로는 안쪽 반복에서 Qwen 과 BERT 에 한 번씩 부릅니다. - 반복 뒤의 표 돌리기: 4단계는 반복 없이 pandas 의
pivot과groupby로 표를 돌립니다. 데이터 분석 때 쓰던 방법 그대로입니다.
결과 보기 (예시 풀이)
1단계. 공지 표 만들기
같은 공지를 한국어와 영어로 한 행에 적습니다.
import pandas as pd

# 공지 세 개를 한국어와 영어로 적은 표. 한 행이 같은 뜻의 공지 한 쌍이다
notices = pd.DataFrame({
    "공지": ["회의", "엘리베이터", "보안"],
    "한국어": [
        "다음 주 월요일 오전 10시에 3층 대회의실에서 전체 회의가 있습니다.",
        "건물 점검으로 금요일 오후 6시부터 엘리베이터 운행을 멈춥니다.",
        "개인정보 보호를 위해 퇴근 전에 모니터 화면을 잠가 주십시오.",
    ],
    "영어": [
        "There is an all-hands meeting in the main conference room on the 3rd floor next Monday at 10 a.m.",
        "Elevator service will stop from 6 p.m. on Friday for a building inspection.",
        "To protect personal information, please lock your monitor screen before you leave work.",
    ],
})
# 결과: (3, 3)  공지 3개 × 열 3개
print(notices.shape)(3, 3)2단계. 토크나이저 두 개 불러오기
두 회사의 설명서(토크나이저)를 준비하고, 각 사전에 블록이 몇 종류인지 봅니다.
from transformers import AutoTokenizer

# Qwen(Byte-level BPE)과 BERT(WordPiece) 토크나이저. 모델 무게는 내려받지 않는다
qwen = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")
bert = AutoTokenizer.from_pretrained("bert-base-uncased")

# 사전 크기. 결과: Qwen 151,665 / BERT 30,522
print(f"Qwen {len(qwen):,} / BERT {len(bert):,}")Qwen 151,665 / BERT 30,5223단계. 글자 수와 토큰 수 세기
공지마다, 언어마다 미터기를 눌러 한 행씩 기록합니다.
def count_tokens(tokenizer, text):
    # 특수 토큰을 빼고 센 토큰 수. 두 토크나이저에 똑같이 쓴다
    return len(tokenizer(text, add_special_tokens=False)["input_ids"])

rows = []
# iterrows = 표를 한 행씩 꺼내기. _ 는 행 번호(쓰지 않음), row 는 그 행
for _, row in notices.iterrows():
    for lang in ["한국어", "영어"]:
        text = row[lang]
        rows.append({
            "공지": row["공지"],
            "언어": lang,
            "글자 수": len(text),
            "Qwen 토큰": count_tokens(qwen, text),
            "BERT 토큰": count_tokens(bert, text),
        })

# 행 사전 6개로 긴 표를 만든다(공지 3 × 언어 2)
table = pd.DataFrame(rows)
# 글자당 Qwen 토큰 = 토큰 수 ÷ 글자 수. 소수 둘째 자리까지
table["글자당 Qwen 토큰"] = (table["Qwen 토큰"] / table["글자 수"]).round(2)
# 결과: 한국어 행은 글자당 0.69~0.86, 영어 행은 0.17~0.28
print(table.to_string(index=False)) 공지 언어 글자 수 Qwen 토큰 BERT 토큰 글자당 Qwen 토큰
회의 한국어 39 27 38 0.69
회의 영어 97 27 24 0.28
엘리베이터 한국어 35 30 66 0.86
엘리베이터 영어 75 18 17 0.24
보안 한국어 34 26 53 0.76
보안 영어 87 15 15 0.174단계. 한국어와 영어 견주기
같은 공지를 두 언어로 나란히 놓고 비를 구합니다. 데이터 분석에서 자주 쓰던 pivot 과 groupby 그대로입니다.
# pivot = 긴 표를 넓은 표로. 행은 공지, 열은 언어, 값은 Qwen 토큰 수
pivot = table.pivot(index="공지", columns="언어", values="Qwen 토큰")
pivot["한국어÷영어"] = (pivot["한국어"] / pivot["영어"]).round(2)
# 결과: 보안 1.73, 엘리베이터 1.67, 회의 1.00
print(pivot)

# 언어별 합계. 결과: 한국어 108글자 83토큰, 영어 259글자 60토큰
print(table.groupby("언어")[["글자 수", "Qwen 토큰"]].sum())언어 영어 한국어 한국어÷영어
공지
보안 15 26 1.73
엘리베이터 18 30 1.67
회의 27 27 1.00
글자 수 Qwen 토큰
언어
영어 259 60
한국어 108 835단계. 조각 확인과 저장
첫 공지의 한국어 문장이 어떤 조각으로 잘렸는지 보고, 표를 파일로 남깁니다.
first_ko = notices.loc[0, "한국어"]

# Qwen 조각: 번호를 하나씩 decode 해서 본다
q_ids = qwen(first_ko, add_special_tokens=False)["input_ids"]
print([qwen.decode([i]) for i in q_ids])
# BERT 조각: 한글을 자모로 쪼개고, 사전에 없는 것은 [UNK](unknown, 모름)으로 둔다
print(bert.tokenize(first_ko))

# utf-8-sig = 엑셀에서 열어도 한글이 깨지지 않는 저장 방식
table.to_csv("out_ch02_notice_tokens.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch02_notice_tokens.csv", table.shape) # 결과: 저장: out_ch02_notice_tokens.csv (6, 6)['다', '음', ' 주', ' �', '�', '요', '일', ' 오', '전', ' ', '1', '0', '시', '에', ' ', '3', '층', ' 대', '회의', '실', '에서', ' 전체', ' 회', '의', '가', ' 있습니다', '.']
['ᄃ', '##ᅡ', '##ᄋ', '##ᅳ', '##ᆷ', 'ᄌ', '##ᅮ', 'ᄋ', '##ᅯ', '##ᆯ', '##ᄋ', '##ᅭ', '##ᄋ', '##ᅵ', '##ᆯ', 'ᄋ', '##ᅩ', '##ᄌ', '##ᅥ', '##ᆫ', '10', '##ᄉ', '##ᅵ', '##ᄋ', '##ᅦ', '3', '##ᄎ', '##ᅳ', '##ᆼ', '[UNK]', 'ᄌ', '##ᅥ', '##ᆫ', '##ᄎ', '##ᅦ', '[UNK]', '[UNK]', '.']
저장: out_ch02_notice_tokens.csv (6, 6)세 공지를 합치면 한국어는 108글자에 83토큰, 영어는 259글자에 60토큰입니다. 같은 내용을 Qwen 으로 보내면 한국어가 약 1.4배(83 ÷ 60) 토큰을 씁니다. 다만 "회의" 공지는 두 언어가 27토큰으로 같았습니다. 영어 문장이 97글자로 길게 쓰였고, 한국어 쪽에 "회의", " 있습니다" 처럼 사전에 통째로 든 조각이 있어 차이가 줄었습니다. 비는 문장마다 달라지므로 실제 공지로 세어 봐야 합니다. BERT(bert-base-uncased)는 영어 위주 사전이라 한글을 자모로 잘게 쪼개고 [UNK] 까지 내므로, 한국어 문장을 다루는 모델에는 맞지 않습니다. 팀장에게는 "같은 공지라도 언어와 토크나이저에 따라 토큰 수가 다르니, 실제로 쓸 모델의 토크나이저로 세어 예산을 잡자"고 답하면 됩니다.