2장. Transformer 입력 표현
토큰화: 문장을 레고 블록으로
레고로 집을 짓는다고 해 봅시다. 블록이 너무 크면(방 하나가 통째로 한 블록) 처음 보는 모양의 집은 지을 수 없습니다. 블록이 너무 작으면(점 하나가 한 블록) 무엇이든 지을 수 있지만 블록이 끝없이 많이 듭니다. 그래서 자주 쓰는 모양(벽, 창문)은 큰 블록으로, 드문 모양은 작은 블록을 조합해 만듭니다. 토큰화도 같습니다. 문장을 자를 때 단어 단위, 문자 단위, 그 사이의 서브워드 단위가 있습니다.
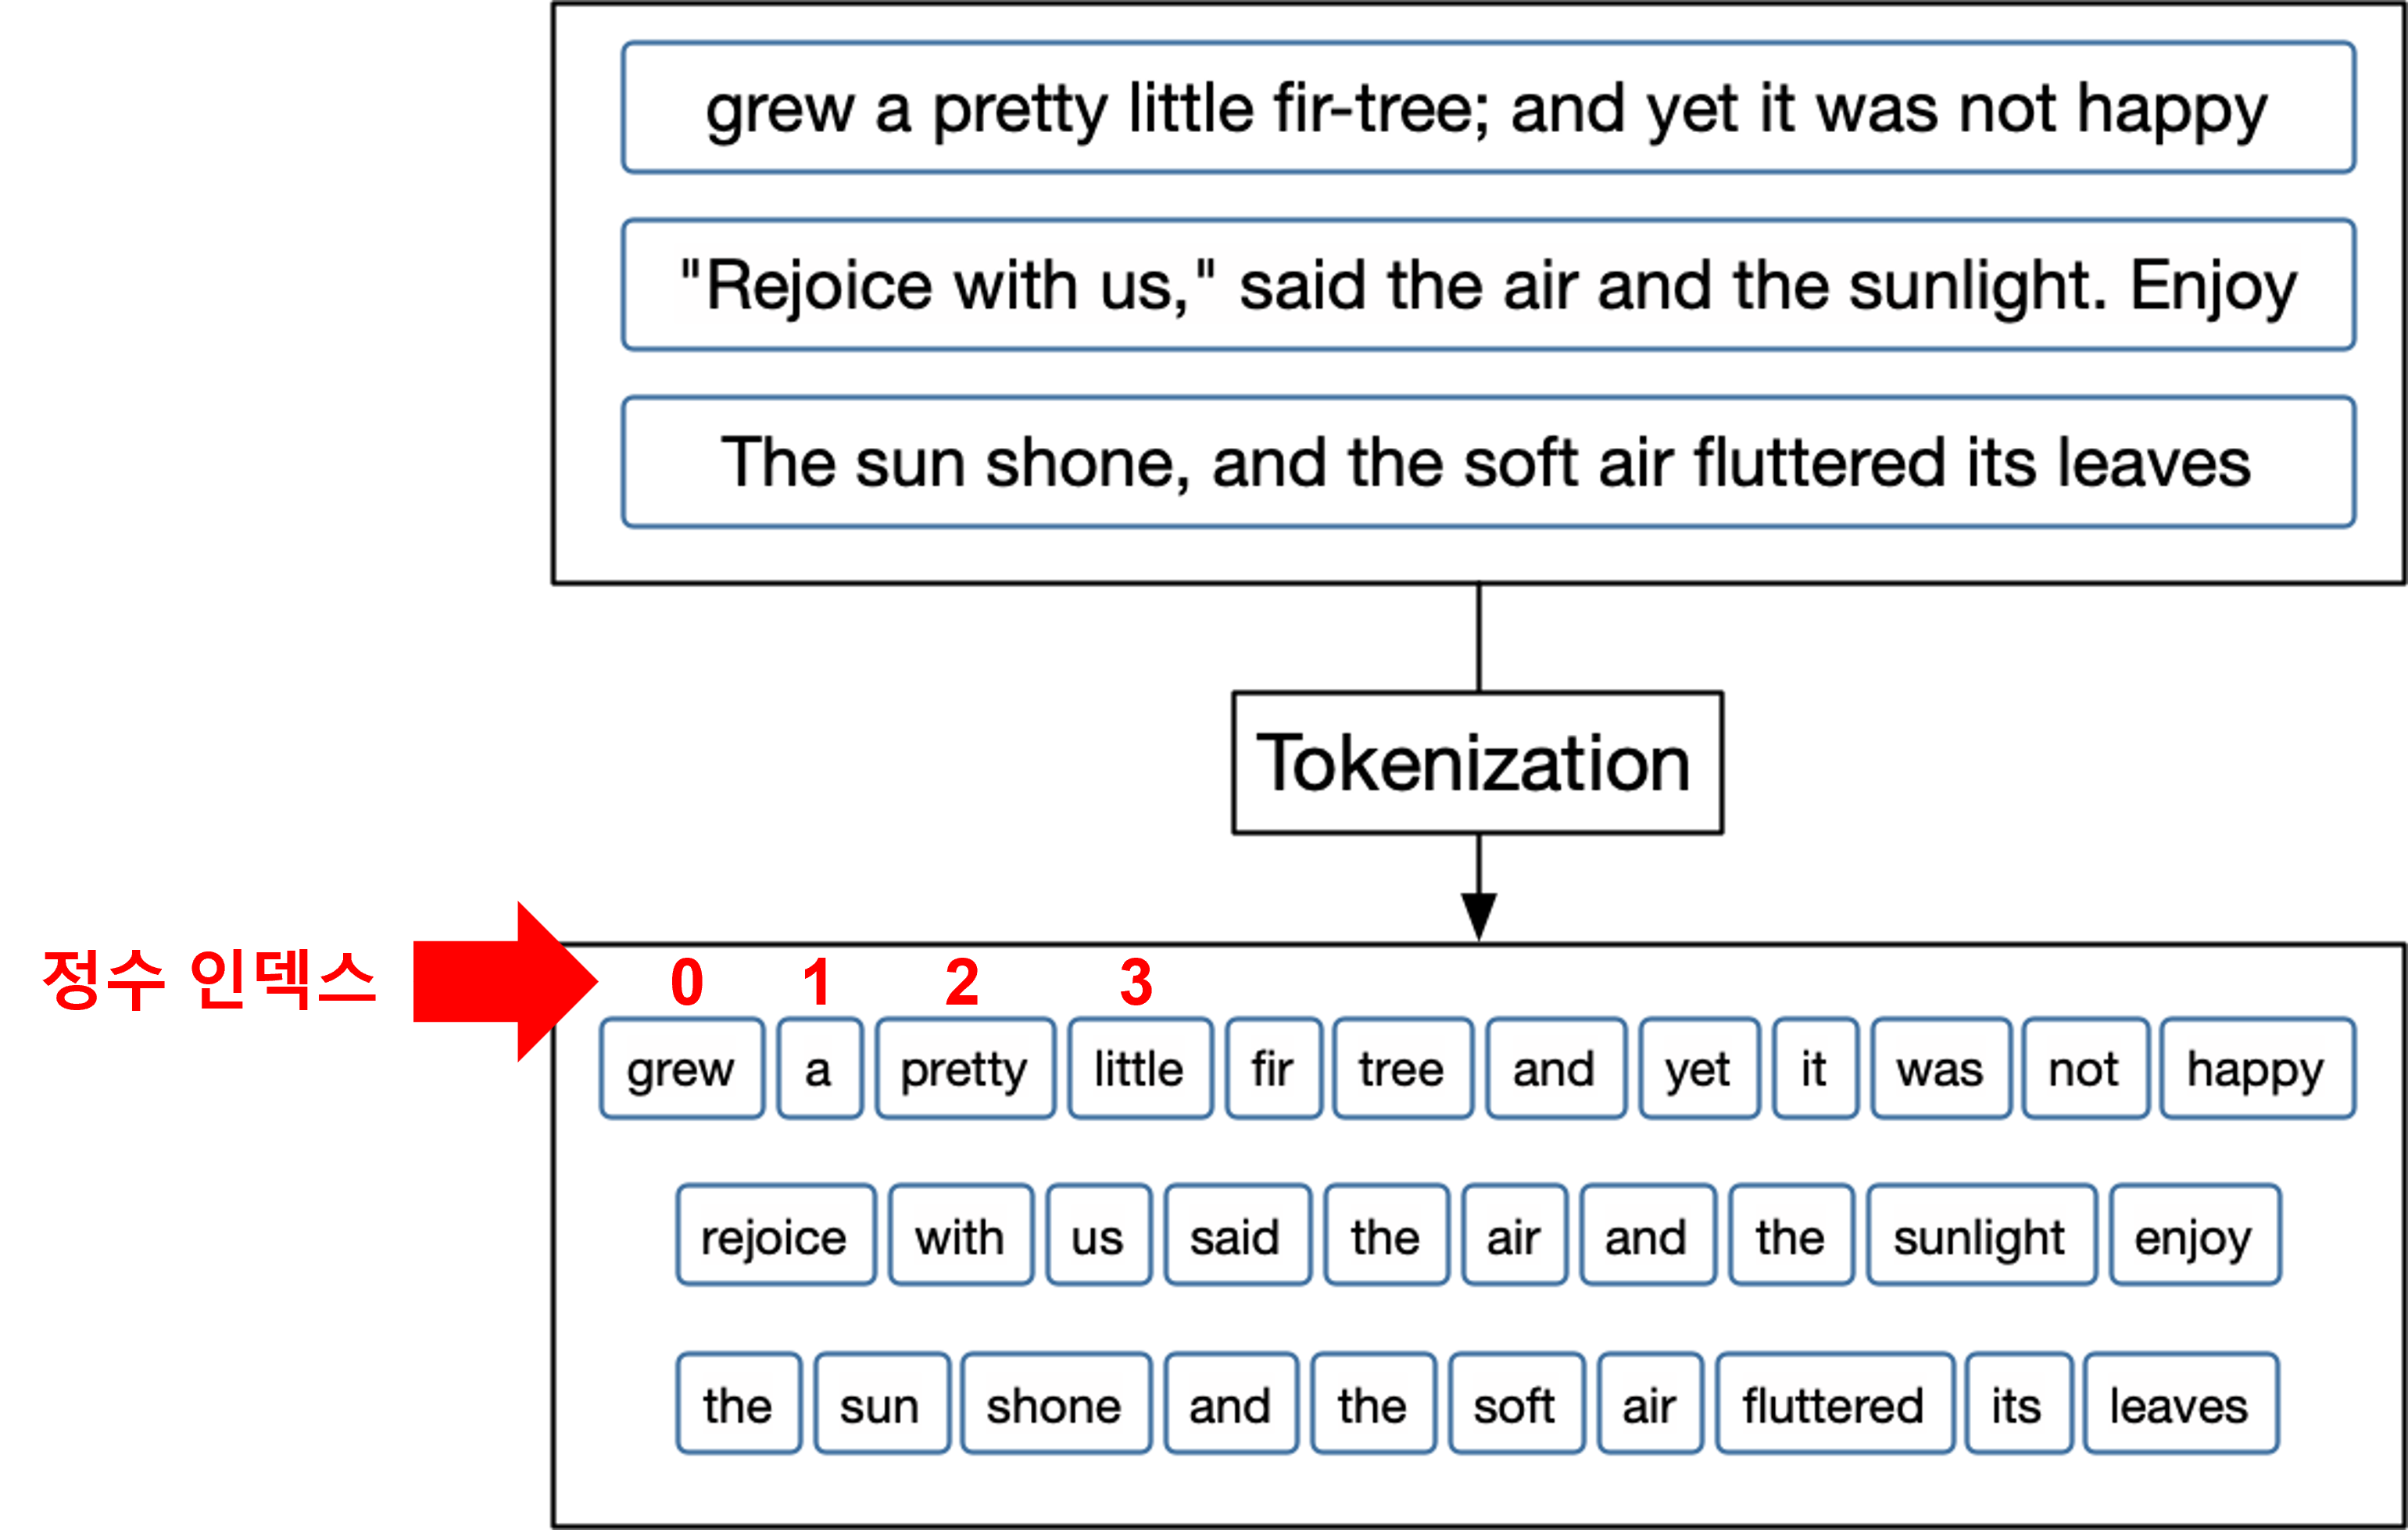
그림 위쪽 상자는 원래 문장 세 개이고, 아래쪽은 토큰으로 나눈 결과입니다. 왼쪽의 빨간 화살표가 가리키는 0, 1, 2, 3 이 사전에서 매긴 번호(정수 인덱스)입니다. 토큰을 모두 모아 번호를 붙인 목록이 사전이고, 문장의 토큰을 사전에서 찾아 번호로 바꾼 것이 토큰 ID 입니다. pandas 로 치면 pd.factorize 로 낱말마다 번호를 붙이는 것과 비슷합니다.
자르는 단위 세 가지
| 방식 | 예: unbelievable | 장점 | 단점 |
|---|---|---|---|
| 단어 단위 | unbelievable | 사람이 이해하기 쉽다 | 사전에 없는 단어(OOV)를 처리하지 못하고, 사전 크기가 폭발한다 |
| 문자 단위 | u n b e l i e ... | OOV 가 없다 | 줄이 너무 길어지고, 조각 하나에 뜻이 거의 없다 |
| 서브워드 단위 | un + believ + able | 자주 쓰는 단어는 통째로, 드문 단어는 조각으로 | 조각이 사람 눈에 어색할 수 있다 |
현대 LLM 은 모두 서브워드 단위로 자릅니다. 다만 같은 서브워드 방식이라도 어디서 자를지는 토크나이저마다 다릅니다.
짧은 예시
from transformers import AutoTokenizer

# BERT(WordPiece)와 Qwen(Byte-level BPE) 토크나이저를 함께 불러온다
bert = AutoTokenizer.from_pretrained("bert-base-uncased")
qwen = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")

for word in ["unbelievable", "unbelievably", "tokenization"]:
    # tokenize = 문장을 토큰 조각(글자)으로만 자른다. 번호로 바꾸지는 않는다
    b_pieces = bert.tokenize(word)
    # Qwen 은 조각을 사람이 읽는 글자로 보기 위해 번호를 하나씩 decode 한다
    q_pieces = [qwen.decode([i]) for i in qwen(word, add_special_tokens=False)["input_ids"]]
    print(word, b_pieces, q_pieces)
# 결과:
# unbelievable ['unbelievable'] ['un', 'belie', 'vable']
# unbelievably ['un', '##bel', '##ie', '##va', '##bly'] ['un', 'belie', 'vably']
# tokenization ['token', '##ization'] ['token', 'ization']
이 코드가 뜻하는 것
같은 레고 상자를 두 회사의 설명서로 조립해 본 코드입니다. BERT 사전에는 unbelievable 이 통째로 있어서 한 블록이지만, 끝이 조금 다른 unbelievably 는 다섯 조각으로 나뉩니다. Qwen 은 둘 다 세 조각입니다. 어느 쪽이 맞고 틀린 것이 아니라, 각자의 사전이 다를 뿐입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
bert.tokenize(word) | WordPiece 로 자른 조각을 본다 | BERT 설명서로 조립 |
##bel | 앞 조각에 바로 이어 붙는 조각 표시 | "앞 블록에 붙이세요" |
qwen.decode([i]) | 번호 하나를 글자로 되돌린다 | Qwen 블록 하나 들여다보기 |
주의할 점
- 토크나이저는 모델과 한 세트입니다. BERT 의 번호 3084 와 Qwen 의 번호 3084 는 전혀 다른 조각입니다. 다른 모델의 토크나이저를 섞어 쓰면 엉뚱한 번호가 들어가 모델이 동작하지 않습니다.
bert-base-uncased의 uncased 는 "대소문자를 가리지 않는다"는 뜻입니다. 그래서 "Tokenization" 의 T 가 소문자 t 로 바뀐 채 잘립니다.