2장. Transformer 입력 표현
실습 2 — 한국어와 영어 토큰 수 견주기
같은 뜻의 한국어 문장과 영어 문장을 Qwen 토크나이저로 잘라 글자 수와 토큰 수를 견줍니다. 실습 1의 2단계(Qwen 토크나이저를 불러오는 셀)를 먼저 실행해 둡니다.
셀이 하나뿐인 짧은 실습이지만, 같은 꼴로 실행 흐름을 먼저 봅니다.
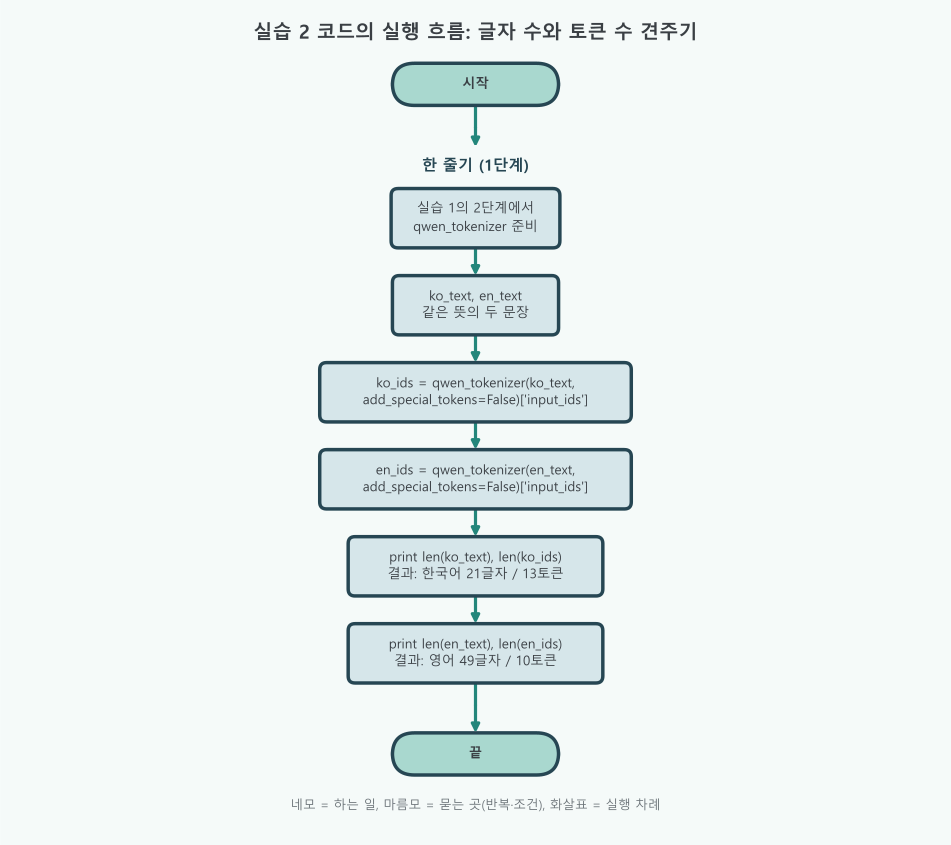
| 단계 | 하는 일 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| 1 | 같은 뜻의 두 문장을 같은 토크나이저로 잘라 글자 수와 토큰 수 견주기 | 없음 | len(ko_text), len(ko_ids) |
- 한 줄기 흐름: 마름모가 없는 한 줄기입니다. 두 문장을 차례로 한 번씩 자르고 찍습니다.
- 첫 네모:
qwen_tokenizer는 이 셀에서 만들지 않고 실습 1의 2단계에서 만든 변수입니다. 그 셀을 건너뛰면 첫 줄에서 이름을 모른다는 오류가 납니다. - 끝부분: 같은 미터기로 두 길을 재야 공평하듯, 두 문장 모두
add_special_tokens=False로 같은 조건에서 셉니다.
1단계. 글자 수와 토큰 수 세기
같은 회의 공지를 한국어와 영어로 쓰고, 각각 몇 글자이고 몇 토큰인지 셉니다. 택시로 치면 같은 목적지까지 두 길의 미터기를 견주는 일입니다.
# 같은 토크나이저로 두 문장을 나누고, 글자 수와 토큰 수를 비교합니다.
# 뜻이 같은 한국어 문장과 영어 문장
ko_text = "오늘 회의는 오후 세 시에 시작합니다."
en_text = "Today's meeting starts at three in the afternoon."
# 실습 1에서 불러온 qwen_tokenizer 로 자른다(같은 토크나이저로 세야 비교가 된다)
ko_ids = qwen_tokenizer(ko_text, add_special_tokens=False)["input_ids"]  # 한국어 문장의 토큰 ID입니다.
en_ids = qwen_tokenizer(en_text, add_special_tokens=False)["input_ids"]  # 영어 문장의 토큰 ID입니다.
# len(문자열) = 글자 수, len(리스트) = 토큰 수. 결과: 한국어: 21글자 / 13토큰
print(f"한국어: {len(ko_text)}글자 / {len(ko_ids)}토큰")
# 결과: 영어  : 49글자 / 10토큰
print(f"영어 : {len(en_text)}글자 / {len(en_ids)}토큰")한국어: 21글자 / 13토큰
영어 : 49글자 / 10토큰이 실습이 뜻하는 것
같은 목적지까지 두 길로 택시를 탄 실습입니다. 한국어는 21글자로 짧지만 13토큰, 영어는 49글자로 길지만 10토큰입니다. 글자 수로는 영어가 두 배 넘게 길어도, 모델이 세는 토큰은 한국어가 더 많습니다. Qwen 의 사전에는 영어 낱말이 통째로 많이 들어 있고, 한국어는 더 잘게 잘리기 때문입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 한국어 21글자 / 13토큰 | 글자당 약 0.62토큰(13 ÷ 21) |
| 1단계 | 영어 49글자 / 10토큰 | 글자당 약 0.20토큰(10 ÷ 49) |
한 줄 요약: 글자 수와 토큰 수는 다르고, 같은 뜻이라도 언어마다 토큰 수가 다릅니다.
코드 설명
qwen_tokenizer는 실습 1의 2단계에서 만든 변수입니다. 두 문장을 같은 토크나이저로 잘라야 공평하게 견줄 수 있습니다.len(ko_text)는 파이썬이 센 글자 수(띄어쓰기, 마침표 포함)이고,len(ko_ids)는 토큰 ID 리스트의 길이, 즉 토큰 수입니다.- 13 ÷ 21 ≈ 0.62 와 10 ÷ 49 ≈ 0.20 을 견주면, 한 글자가 담는 정보가 많은 한국어가 글자당 토큰이 세 배쯤 많습니다.
- 그래서 한국어 데이터의 최대 길이, 컨텍스트에 넣을 문서의 양, API 요금은 글자 수가 아니라 실제 토크나이저로 센 토큰 수로 정합니다.
- 비교 결과는 문장과 토크나이저에 따라 달라집니다. 다음 프로젝트에서 공지 세 개로 넓혀 표로 정리합니다.