2장. Transformer 입력 표현
실습 1 — 토크나이저로 문장 쪼개 보기
BERT 의 WordPiece 로 영어 문장을, Qwen 의 BPE 로 한국어 문장을 잘라 토큰과 토큰 ID 를 찍습니다. 원본 노트북의 셀을 그대로 싣고 주석만 더했습니다. 출력은 이 PC 에서 처음 실행했을 때의 결과라 내려받기 경고가 함께 찍혀 있습니다.
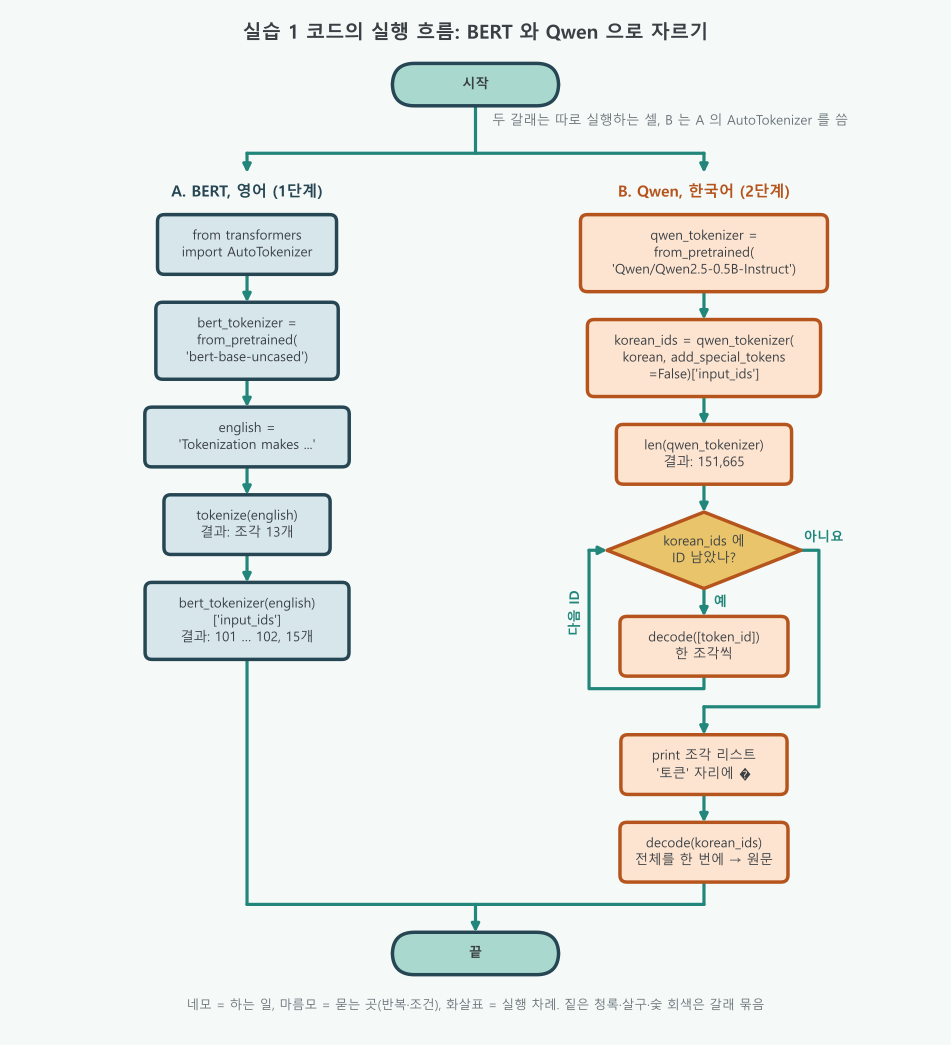
코드를 단계별로 따라가기 전에 실행 흐름을 한 장으로 봅니다. 요리책의 순서도처럼 위에서 아래로 화살표를 따라 읽습니다.
| 갈래 | 단계 | 반복과 조건 | 핵심 한 줄 |
|---|---|---|---|
| A. BERT, 영어 | 1 | 없음 | bert_tokenizer(english)["input_ids"] |
| B. Qwen, 한국어 | 2 | korean_ids 의 ID 20개를 하나씩 도는 반복(리스트 안의 for token_id in korean_ids) | qwen_tokenizer.decode([token_id]) |
- 흐름도의 모양: 위아래가 둥근 알약은 시작과 끝, 네모는 하는 일, 마름모는 묻는 곳(반복을 더 할지, 조건이 맞는지), 화살표는 실행 차례입니다. 마름모에서 "예"로 내려가 일을 하고, 왼쪽 선을 따라 다시 마름모로 돌아오는 고리가 반복문입니다. "아니요"면 오른쪽 선으로 빠져나갑니다.
- 두 갈래: 짙은 청록(A)과 살구(B)는 따로 실행하는 셀입니다. B 는 A 의 첫 줄
from transformers import AutoTokenizer를 쓰므로 A 를 먼저 실행합니다. - B 의 반복:
[... for token_id in korean_ids]처럼 대괄호 안에 쓴 반복도 반복문입니다. 번호 하나씩 글자로 되돌리다 보면 "토큰" 자리에�가 보이고, 반복을 빠져나온 뒤decode(korean_ids)로 한 번에 되돌리면 원문이 나옵니다.
1단계. BERT 로 영어 문장 자르기
BERT 설명서로 영어 문장을 레고 블록으로 쪼개고, 블록마다 붙은 상품 번호를 찍습니다.
# BERT의 WordPiece 방식으로 영어 문장이 어떻게 나뉘는지 확인합니다.
# AutoTokenizer = 모델 이름만 주면 그 모델에 맞는 토크나이저를 골라 주는 도구
from transformers import AutoTokenizer  # 사전학습 토크나이저를 불러옵니다.

# 참고 : https://huggingface.co/google-bert/bert-base-uncased
# from_pretrained = 이미 학습된(pretrained) 토크나이저 파일을 불러오기. uncased = 대소문자를 가리지 않음
bert_tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")  # BERT 토크나이저를 내려받습니다.
# 드문 낱말(unbelievably, manageable)이 섞인 영어 문장
english = "Tokenization makes unbelievably rare words manageable."

# tokenize = 조각으로만 자른다. 결과: 13조각, 'token', '##ization', ... '.'
print("토큰:", bert_tokenizer.tokenize(english))  # '##'은 앞 조각에 이어 붙는 조각이라는 표시입니다.
# 토크나이저를 함수처럼 부르면 사전({"input_ids": ..., ...})을 돌려준다. 결과: 101 로 시작해 102 로 끝나는 15개
print("ID :", bert_tokenizer(english)["input_ids"]) # [CLS]=101, [SEP]=102 같은 특수 토큰이 앞뒤에 붙습니다.토큰: ['token', '##ization', 'makes', 'un', '##bel', '##ie', '##va', '##bly', 'rare', 'words', 'manage', '##able', '.']
ID : [101, 19204, 3989, 3084, 4895, 8671, 2666, 3567, 6321, 4678, 2616, 6133, 3085, 1012, 102]2단계. Qwen 으로 한국어 문장 자르기
이번에는 Qwen 설명서로 한국어 문장을 자릅니다. 한글 한 글자는 3바이트라서, 블록 하나가 글자 하나를 다 담지 못하는 경우도 봅니다.
# Qwen 토크나이저가 한국어 문장을 어떻게 나누는지 확인합니다.
qwen_tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")  # Qwen 토크나이저를 불러옵니다.
# 26글자(띄어쓰기와 마침표 포함)짜리 한국어 문장
korean = "트랜스포머는 문장을 토큰으로 나눠서 처리합니다."
# add_special_tokens=False = 표시용 특수 토큰을 붙이지 않는다. 결과: 토큰 ID 20개
korean_ids = qwen_tokenizer(korean, add_special_tokens=False)["input_ids"]  # 특수 토큰 없이 한국어 문장을 ID로 바꿉니다.

# len(토크나이저) = 사전에 든 토큰 수. 결과: 151,665
print("토크나이저 어휘 수:", f"{len(qwen_tokenizer):,}")
# 결과: [28626, 136499, ..., 13] 20개
print("토큰 ID:", korean_ids)
# decode = 번호를 글자로 되돌리기. 하나씩 되돌리면 '토큰' 자리에 � 조각들이 보인다
print("한 토큰씩 디코딩:", [qwen_tokenizer.decode([token_id]) for token_id in korean_ids])  # 한글 바이트가 여러 토큰으로 나뉘면 한 조각만 디코딩할 때 �가 보일 수 있습니다.
# 결과: 트랜스포머는 문장을 토큰으로 나눠서 처리합니다.
print("전체를 디코딩:", qwen_tokenizer.decode(korean_ids)) # 전체 ID를 합쳐 원문으로 되돌립니다.토크나이저 어휘 수: 151,665
토큰 ID: [28626, 136499, 24897, 128808, 132125, 16560, 53435, 137471, 10764, 228, 57160, 223, 108, 42039, 73518, 144478, 26698, 81058, 60838, 13]
한 토큰씩 디코딩: ['트', '랜', '스', '포', '머', '는', ' 문', '장을', ' �', '�', '��', '�', '�', '으로', ' 나', '눠', '서', ' 처리', '합니다', '.']
전체를 디코딩: 트랜스포머는 문장을 토큰으로 나눠서 처리합니다.이 실습이 뜻하는 것
같은 레고 상자를 두 회사 설명서로 조립해 본 실습입니다. BERT 는 영어 낱말을 ## 표시로 이어 붙이는 조각으로 나누고, 앞뒤에 시작(101)과 끝(102) 표시 블록을 붙입니다. Qwen 은 한국어 문장 26글자를 20토큰으로 나눴는데, "트랜스포머" 는 다섯 글자가 다섯 토큰이고 "처리" 와 "합니다" 는 한 토큰입니다. "토큰" 두 글자는 바이트 조각 다섯 개로 나뉘어, 하나씩 되돌리면 �가 보이고 함께 되돌리면 원래 글자가 됩니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1단계 | 토큰 13개, ID 15개(101 … 102) | 낱말이 ## 조각으로 나뉘고 특수 토큰 2개가 붙는다 |
| 2단계 | 어휘 수 151,665, 토큰 ID 20개 | 한국어도 사전 번호의 열로 바뀐다 |
| 2단계 | 한 토큰씩 디코딩에 � | 한 글자의 바이트가 여러 토큰에 나뉘었다 |
| 2단계 | 전체를 디코딩하면 원문 | 토큰 ID 와 사람이 읽는 글자는 다른 단위다 |
한 줄 요약: 토큰은 낱말도 글자도 아닌, 그 토크나이저의 사전이 정한 조각입니다.
코드 설명
AutoTokenizer.from_pretrained("bert-base-uncased")는 BERT 의 사전(30,522개)과 자르는 규칙을 불러옵니다. Windows 에서 처음 내려받을 때 캐시 바로 가기(symlink) 경고가 보일 수 있습니다. 결과에는 영향이 없어 교안의 출력에서는 뺐습니다.tokenize는 조각(글자)만, 토크나이저를 함수처럼 부르면 번호(input_ids)까지 돌려줍니다. BERT 는 기본으로[CLS](101)와[SEP](102)를 앞뒤에 붙여 13조각이 15개 번호가 됩니다.- "Tokenization" 은
token+##ization, "unbelievably" 는un+##bel+##ie+##va+##bly로 나뉩니다. 대문자 T 는 uncased 라서 소문자가 됐습니다. - Qwen 의
add_special_tokens=False는 표시용 토큰 없이 문장의 토큰만 받으려는 설정입니다. 사전은 151,665개로 BERT 의 약 5배입니다. decode([token_id])로 하나씩 되돌린 리스트에서' �', '�', '��', '�', '�'다섯 개가 "토큰" 두 글자(6바이트)입니다. 바이트 단위로 쪼갠 BPE 라서 생기는 모습이고, 전체를 한 번에decode하면 문제없이 원문이 됩니다.